使用自定义 api_base 的 LiteLLM:在 Python 中调用 CheapTokens
使用 openai/ 前缀、api_base 和完整模型 id,从 litellm.completion() 和 LiteLLM 代理 config.yaml 调用 CheapTokens,并修复 Not Found。
要把 LiteLLM 指向 CheapTokens,你需要改三个值:model 在完整模型 id 前加上 openai/ 前缀,api_base 改为 https:/,api_key 填你的 CheapTokens 密钥。整个切换就这些,Python 里的 litellm. 和 LiteLLM 代理都一样。
假设你已有一个项目,用 OpenAI 或 Anthropic 模型调用 litellm.,想在不改动其余代码的情况下试试更便宜的模型。前缀就是关键:LiteLLM 的 OpenAI 兼容提供商文档(2026 年 10 月 29 日查阅)说明,对于任何 OpenAI 兼容端点,你用 openai/ 设置模型,让 LiteLLM 路由到 OpenAI 提供商,然后在旁边传入 api_base 和 api_key。CheapTokens 在 https:/ 使用 OpenAI Chat Completions 格式,所以正好适配。
Python 和代理中的同一次调用#
两种配置都很短。选择与你运行 LiteLLM 方式匹配的标签页。
一个 CheapTokens 模型,两种调用方式
Python SDK
import os
import litellm

response = litellm.completion(
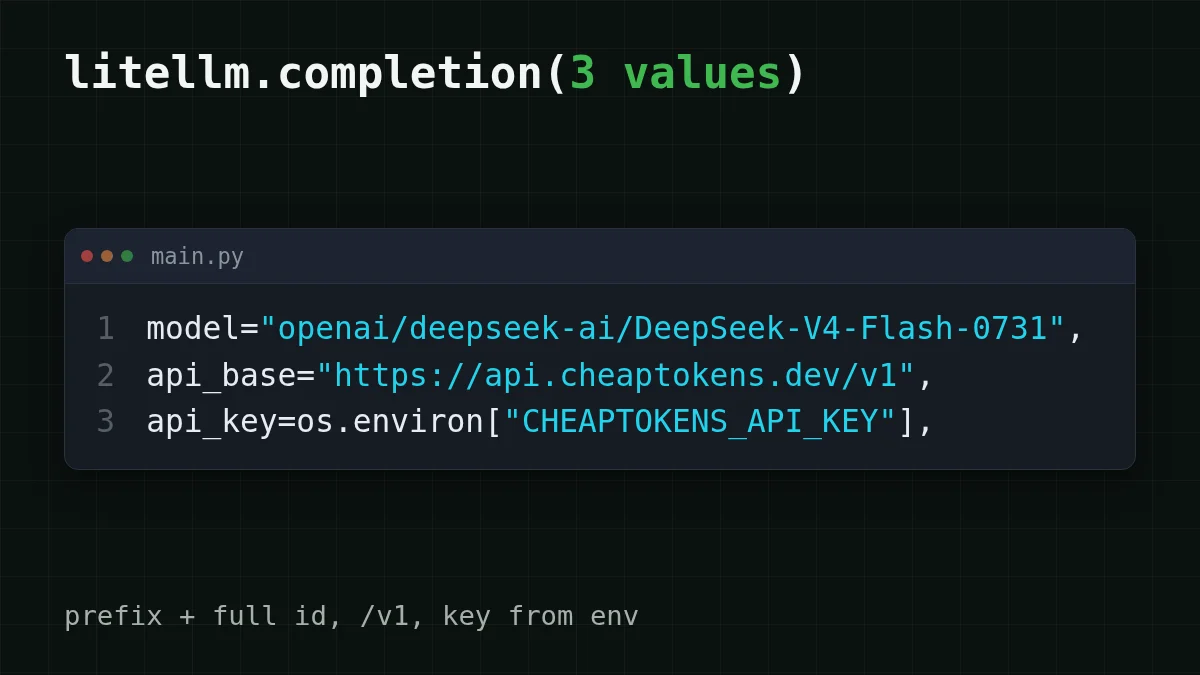
    model="openai/deepseek-ai/DeepSeek-V4-Flash-0731",
    api_base="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
    messages=[{"role": "user", "content": "Explain what api_base does in one sentence."}],
    max_tokens=200,
)

print(response.choices[0].message.content)
print(response.usage)
把密钥放在环境变量里,不要写在文件中。
代理 config.yaml
model_list:
  - model_name: cheap-chat
    litellm_params:
      model: openai/deepseek-ai/DeepSeek-V4-Flash-0731
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
用 litellm - 启动它。客户端向代理请求 cheap-chat,永远看不到真实模型 id。
调用代理
curl http://localhost:4000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "cheap-chat", "messages": [{"role": "user", "content": "Say hi"}]}'
代理默认监听 4000 端口。以后更换 cheap-chat 背后的模型时,这个请求不用改。
模型 id 是容易出错的地方。CheapTokens 接受的 id 是完整的 deepseek-,openai/ 放在它前面。不是 deepseek-,也不是只写前缀加短名称。如果不确定模型叫什么,用 GET /v1/models 列出模型,从响应中复制 id。
你应该看到什么#
运行 Python 标签页。第一个 print 显示模型的文本。第二个显示 response.usage,即那次调用的 token 计数:prompt_tokens 是你发送的,completion_ 是模型写出的。LiteLLM 以 OpenAI 格式返回它们,所以已经读取 usage 的代码继续可用。如果想把这些数字变成累计账单,在 Python 中跟踪 agent token 成本 展示了做法。
向代理添加更多模型#
model_name 的意义在于,客户端保持一个别名,而你改变它背后的东西。一个 model_list 可以包含多个条目,全部指向同一个 api_base 和同一个密钥,因为一个 CheapTokens 余额覆盖所有模型:
model_list:
  - model_name: cheap-chat
    litellm_params:
      model: openai/deepseek-ai/DeepSeek-V4-Flash-0731
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
  - model_name: cheap-glm
    litellm_params:
      model: openai/zai-org/GLM-5.3-Flash
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
  - model_name: cheap-minimax
    litellm_params:
      model: openai/MiniMaxAI/MiniMax-M2.7
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
哪个别名用于哪个任务?对于回答可能很长的聊天和 agent 调用,DeepSeek-V4-Flash 是首选:380K 上下文,每次回答最多 32,768 个输出 token,固定价格且无高峰时段。GLM-5.3-Flash 有 390K 上下文和最多 8,192 个输出 token。MiniMax-M2.7 有 180K 上下文。DeepSeek 页面 有详细信息,定价 列出了三者的当前费率。
出错时:Not Found 和 401#
两个错误覆盖了大多数失败的首次调用。LiteLLM 文档说不要在基础 URL 中添加任何额外内容,并且遇到 Not Found 错误时,应检查 api_base 是否以 /v1 结尾。一个注意点:文档自己针对本地代理的示例使用 http:/ 且没有 /v1。那是不同的服务器。对于 CheapTokens,/v1 要保留。
选择你的情况
你的错误是什么样子?
选择一个选项以查看答案
Not Found (404)
检查 api_base。它必须正好是 https:/,带 /v1 且末尾不带 /。LiteLLM 会自己添加路径的其余部分。
401 Unauthorized
密钥缺失、错误,或 LiteLLM 读取了空的环境变量。打印 os. 的长度(不是密钥本身)来检查它是否已设置,并确保你没有习惯性地传入 OpenAI 密钥。
模型被拒绝
将 id 与 /v1/models 中的逐字母比较。openai/ 前缀仅用于 LiteLLM;它后面是完整的 CheapTokens id,包括斜杠前的开发者部分。
关于状态码的完整说明,请参阅 API 401 或 404:错误的密钥、基础 URL 或模型 id。如果你想先了解 api_base 背后的概念,什么是 base_url 以及如何切换 用通俗语言解释了它。
快速检查
你的 api_base 是 https://api.cheaptokens.dev,调用返回 Not Found。你首先改什么?
显示答案
答案: 添加 /v1,使其变为 https://api.cheaptokens.dev/v1
Not Found 指向路径。密钥会给出 401,而前缀是告诉 LiteLLM 使用 OpenAI 风格请求的东西。
一千次调用的成本#
假设代理后面的支持机器人每天发送 1,000 个请求,每个请求约 2,000 个输入 token(问题加上下文)和 500 个输出 token。以下是该负载按实时价格计算的成本,并附 OpenRouter 列,按总量、输入和输出合计比较:
| 模型 | 输入 $/1M | 输出 $/1M | 每次请求 | 1,000 次请求 | OpenRouter,1,000 次请求 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00006 | $0.06 | $0.121 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00008 | $0.08 | $0.173 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00018 | $0.175 | $1.20 |
每次请求 2,000 个输入 token 和 500 个输出 token。每 100 万 token 的价格为当前价格,会随我们的资费一同变动;OpenRouter 列显示相同工作负载的参考价格。
对于 DeepSeek-V4-Flash,该负载每天花费 $0.08,表格显示其总量比 OpenRouter 便宜。把这两个数字换成你自己的平均请求,你就有了预算。
这就是 LiteLLM 所需的全部:三个值、一个 /v1 和一个完整模型 id。从仪表板添加密钥并运行 Python 标签页。


