API и SDKИнструкция
LiteLLM с custom api_base: вызов CheapTokens на Python
Префикс openai/, api_base и полный id модели: как вызвать CheapTokens из litellm.completion() и config.yaml прокси LiteLLM и исправить Not Found.
Содержание
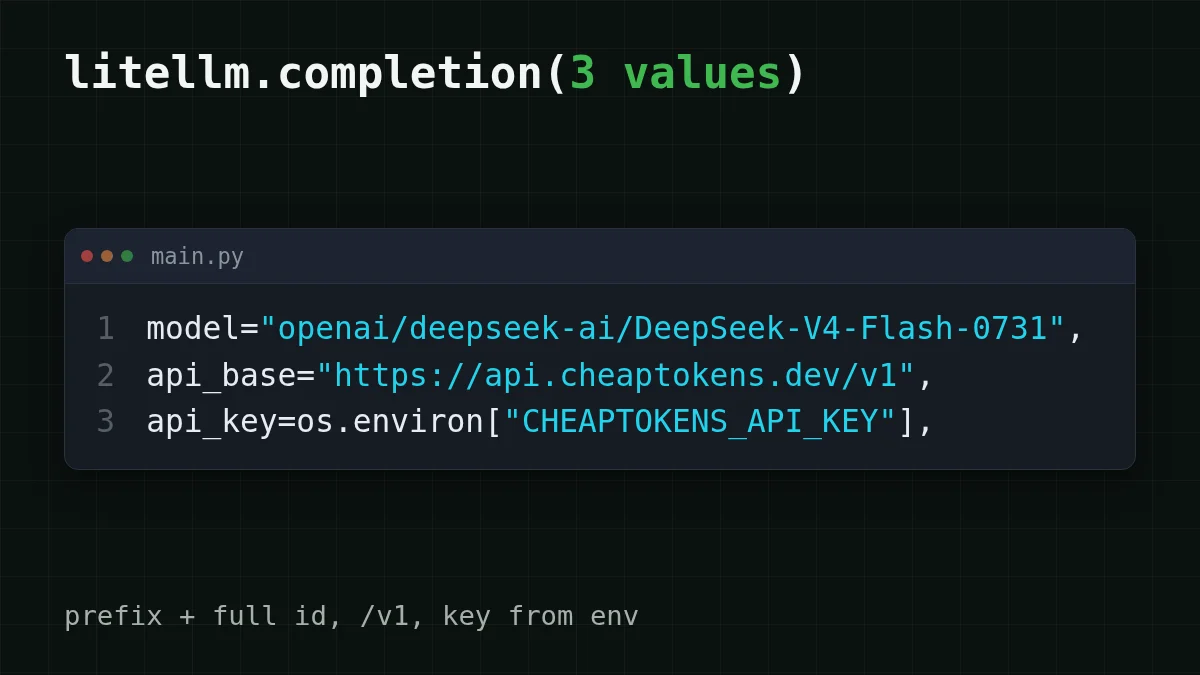
Чтобы направить LiteLLM на CheapTokens, меняются три значения: у model перед полным id модели появляется префикс openai/, api_base становится https:/, а api_key — ваш ключ CheapTokens. Это вся настройка, и для litellm. на Python, и для прокси LiteLLM.
Допустим, у вас уже есть проект, который вызывает litellm. с моделью OpenAI или Anthropic, и вы хотите попробовать модель подешевле, не трогая остальной код. Работает это благодаря префиксу. В документации LiteLLM про OpenAI-совместимые провайдеры (сверено 29 октября 2026) сказано: для любого OpenAI-совместимого адреса в model ставят openai/, и LiteLLM идёт через провайдера OpenAI, а рядом передают api_base и api_key. CheapTokens понимает формат OpenAI Chat Completions по адресу https:/, так что подходит.
Один и тот же вызов в Python и в прокси#
Оба варианта короткие. Выберите вкладку по тому, как вы запускаете LiteLLM.
Одна модель CheapTokens, два способа вызова
Python SDK
import os
import litellm

response = litellm.completion(
    model="openai/deepseek-ai/DeepSeek-V4-Flash-0731",
    api_base="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
    messages=[{"role": "user", "content": "Explain what api_base does in one sentence."}],
    max_tokens=200,
)

print(response.choices[0].message.content)
print(response.usage)
Ключ храните в переменной окружения, а не в файле.
Прокси config.yaml
model_list:
  - model_name: cheap-chat
    litellm_params:
      model: openai/deepseek-ai/DeepSeek-V4-Flash-0731
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
Запуск: litellm -. Клиенты просят у прокси cheap-chat и настоящего id модели не видят.
Вызов прокси
curl http://localhost:4000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "cheap-chat", "messages": [{"role": "user", "content": "Say hi"}]}'
Прокси по умолчанию слушает порт 4000. Позже подмените модель за cheap-chat — этот запрос останется прежним.
О чём спотыкаются чаще всего — id модели. CheapTokens принимает полный id, deepseek-, а openai/ ставится перед ним. Не deepseek- и не префикс с коротким именем. Если не уверены, как называется модель, запросите список моделей через GET /v1/models и скопируйте id из ответа.
Что вы увидите#
Запустите вкладку с Python. Первый print покажет текст ответа. Второй — response.usage, счётчики токенов этого вызова: prompt_tokens — что вы отправили, completion_ — что написала модель. LiteLLM отдаёт их в формате OpenAI, поэтому код, который уже читает usage, продолжит работать. Как превратить эти два числа в текущий счёт, показано в статье учёт токенов и стоимости агента на Python.
Ещё модели в прокси#
Смысл model_name в том, что клиенты держатся за один псевдоним, а то, что за ним, вы меняете. В model_list может быть несколько записей с одним api_base и одним ключом: один баланс CheapTokens работает для всех моделей.
model_list:
  - model_name: cheap-chat
    litellm_params:
      model: openai/deepseek-ai/DeepSeek-V4-Flash-0731
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
  - model_name: cheap-glm
    litellm_params:
      model: openai/zai-org/GLM-5.3-Flash
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
  - model_name: cheap-minimax
    litellm_params:
      model: openai/MiniMaxAI/MiniMax-M2.7
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
Какой псевдоним для чего? Для чата и агентных вызовов, где ответ бывает длинным, начните с DeepSeek-V4-Flash: контекст 380K, до 32 768 токенов в ответе, фиксированная цена без пиковых часов. У GLM-5.3-Flash контекст 390K и до 8 192 токенов в ответе. У MiniMax-M2.7 контекст 180K. Подробности — на странице DeepSeek, текущие тарифы всех трёх — в ценах.
Если не работает: Not Found и 401#
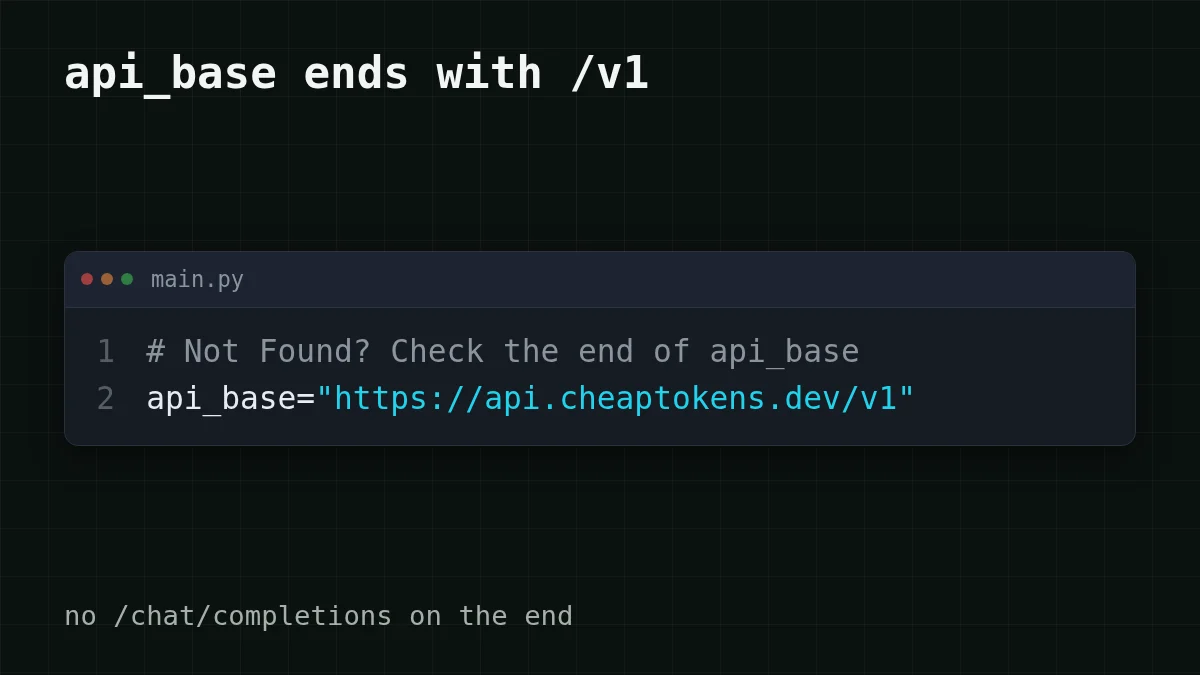
Большинство неудачных первых вызовов — одна из двух ошибок. В документации LiteLLM сказано не добавлять ничего лишнего к базовому адресу, а при Not Found проверить, что api_base заканчивается на /v1. Тонкость: в собственном примере для локального прокси там указан http:/ без /v1. Это другой сервер. Для CheapTokens /v1 остаётся.
Выберите свой случай
Как выглядит ваша ошибка?
Выберите вариант, чтобы увидеть ответ
Not Found (404)
Проверьте api_base. Это ровно https:/: с /v1 и без / на конце. Остальной путь LiteLLM добавляет сам.
401 Unauthorized
Ключ не передан, неверный, или LiteLLM прочитал пустую переменную окружения. Проверьте длину os. (сам ключ не печатайте) и убедитесь, что по привычке не подставили ключ OpenAI.
Модель отклонена
Сверьте id посимвольно с тем, что вернул /v1/models. Префикс openai/ нужен только LiteLLM; дальше идёт полный id CheapTokens, включая часть разработчика до слэша.
Подробный разбор кодов — в статье ошибка API 401 или 404: ключ, base URL или id модели. А если сначала нужна идея самого api_base, её простыми словами объясняет статья что такое base_url и как переключиться.
Быстрая проверка
api_base у вас https://api.cheaptokens.dev, и вызов возвращает Not Found. Что поменять первым?
Показать ответ
Ответ: Добавить /v1, чтобы получилось https://api.cheaptokens.dev/v1
Not Found указывает на путь. С ключом была бы ошибка 401, а префикс как раз говорит LiteLLM использовать запрос в стиле OpenAI.
Сколько стоит тысяча вызовов#
Допустим, бот поддержки за прокси отправляет 1 000 запросов в день, в каждом около 2 000 токенов на входе (вопрос и контекст) и 500 на выходе. Вот эта нагрузка по живым ценам, с колонкой OpenRouter для сравнения в сумме, с учётом входа и выхода:
| Модель | Вход $/1M | Выход $/1M | За запрос | 1 000 запросов | OpenRouter, 1 000 запросов |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00006 | $0.06 | $0.121 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00008 | $0.08 | $0.173 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00018 | $0.175 | $1.20 |
2 000 входных и 500 выходных токенов на запрос. Цены за 1M токенов актуальны и меняются вместе с нашими тарифами; столбец OpenRouter показывает справочные цены для той же нагрузки.
Для DeepSeek-V4-Flash такая нагрузка стоит $0.08 в день, и по таблице видно, что в сумме это дешевле OpenRouter. Подставьте свои два числа, и получится ваш бюджет.
Больше LiteLLM ничего не нужно: три значения, один /v1 и полный id модели. Возьмите ключ в кабинете и запустите вкладку с Python.


