API & SDKGuide
LiteLLM avec un api_base personnalisé : appeler CheapTokens en Python
Utilisez le préfixe openai/, api_base et un id de modèle complet pour appeler CheapTokens depuis litellm.completion() et un config.yaml de proxy LiteLLM, et corriger Not Found.
Sur cette page
Pour envoyer LiteLLM vers CheapTokens, vous modifiez trois valeurs : model reçoit le préfixe openai/ devant l'id complet du modèle, api_base devient https:/, et api_key est votre clé CheapTokens. C'est tout le basculement, aussi bien pour litellm. en Python que pour un proxy LiteLLM.
Supposez que vous avez déjà un projet qui appelle litellm. avec un modèle OpenAI ou Anthropic, et que vous voulez en essayer un moins cher sans toucher au reste du code. Le préfixe est ce qui fait fonctionner le tout : la documentation du fournisseur compatible OpenAI de LiteLLM (vérifiée le 29 octobre 2026) indique que pour tout endpoint compatible OpenAI, vous définissez le modèle avec openai/ afin que LiteLLM route vers le fournisseur OpenAI, puis vous passez api_base et api_key à côté. CheapTokens parle le format OpenAI Chat Completions à https:/, donc cela convient.
Le même appel en Python et dans un proxy#
Les deux configurations sont courtes. Choisissez l'onglet qui correspond à votre façon d'exécuter LiteLLM.
Un modèle CheapTokens, deux façons de l'appeler
SDK Python
import os
import litellm

response = litellm.completion(
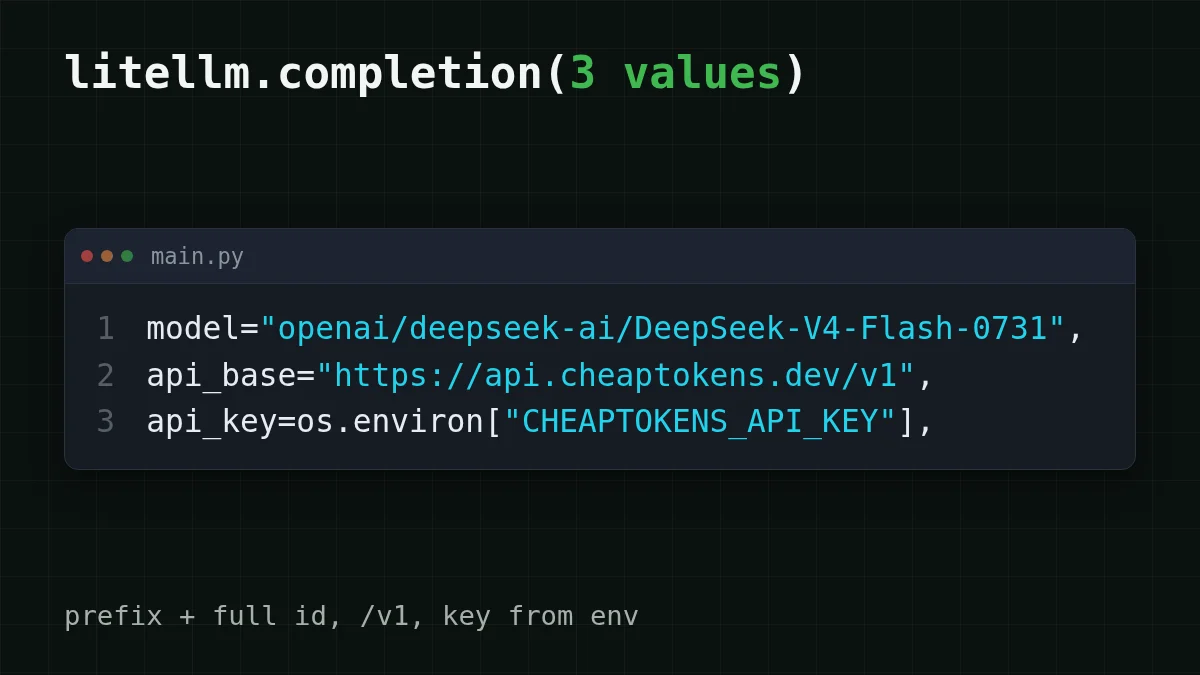
    model="openai/deepseek-ai/DeepSeek-V4-Flash-0731",
    api_base="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
    messages=[{"role": "user", "content": "Explain what api_base does in one sentence."}],
    max_tokens=200,
)

print(response.choices[0].message.content)
print(response.usage)
Gardez la clé dans une variable d'environnement, pas dans le fichier.
config.yaml du proxy
model_list:
  - model_name: cheap-chat
    litellm_params:
      model: openai/deepseek-ai/DeepSeek-V4-Flash-0731
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
Démarrez-le avec litellm -. Les clients demandent cheap-chat au proxy et ne voient jamais le véritable id du modèle.
Appeler le proxy
curl http://localhost:4000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "cheap-chat", "messages": [{"role": "user", "content": "Say hi"}]}'
Le proxy écoute sur le port 4000 par défaut. Changez le modèle derrière cheap-chat plus tard et cette requête ne change pas.
L'id du modèle est la partie sur laquelle les gens trébuchent. L'id que CheapTokens accepte est le complet, deepseek-, et openai/ se place devant. Pas deepseek-, pas seulement le préfixe plus un nom court. Si vous n'êtes pas sûr du nom d'un modèle, listez les modèles avec GET /v1/models et copiez l'id depuis la réponse.
Ce que vous devriez voir#
Exécutez l'onglet Python. Le premier print affiche le texte du modèle. Le second affiche response.usage, les comptes de tokens pour cet appel : prompt_tokens pour ce que vous avez envoyé et completion_ pour ce que le modèle a écrit. LiteLLM les renvoie au format OpenAI, donc le code qui lit déjà usage continue de fonctionner. Si vous voulez transformer ces deux nombres en facture courante, suivre le coût en tokens d'un agent en Python montre comment faire.
Ajouter d'autres modèles au proxy#
L'intérêt de model_name est que vos clients gardent un seul alias pendant que vous changez ce qui se trouve derrière. Un model_list peut contenir plusieurs entrées, toutes pointant vers le même api_base et la même clé, car un seul solde CheapTokens couvre tous les modèles :
model_list:
  - model_name: cheap-chat
    litellm_params:
      model: openai/deepseek-ai/DeepSeek-V4-Flash-0731
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
  - model_name: cheap-glm
    litellm_params:
      model: openai/zai-org/GLM-5.3-Flash
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
  - model_name: cheap-minimax
    litellm_params:
      model: openai/MiniMaxAI/MiniMax-M2.7
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
Quel alias pour quel usage ? Pour les appels de chat et d'agent où la réponse peut être longue, DeepSeek-V4-Flash est celui par lequel commencer : 380K de contexte, jusqu'à 32 768 tokens de sortie par réponse, et un prix fixe sans heures de pointe. GLM-5.3-Flash a un contexte de 390K et jusqu'à 8 192 tokens de sortie. MiniMax-M2.7 a un contexte de 180K. La page DeepSeek contient les détails, et la tarification liste les tarifs actuels pour les trois.
Quand ça casse : Not Found et 401#
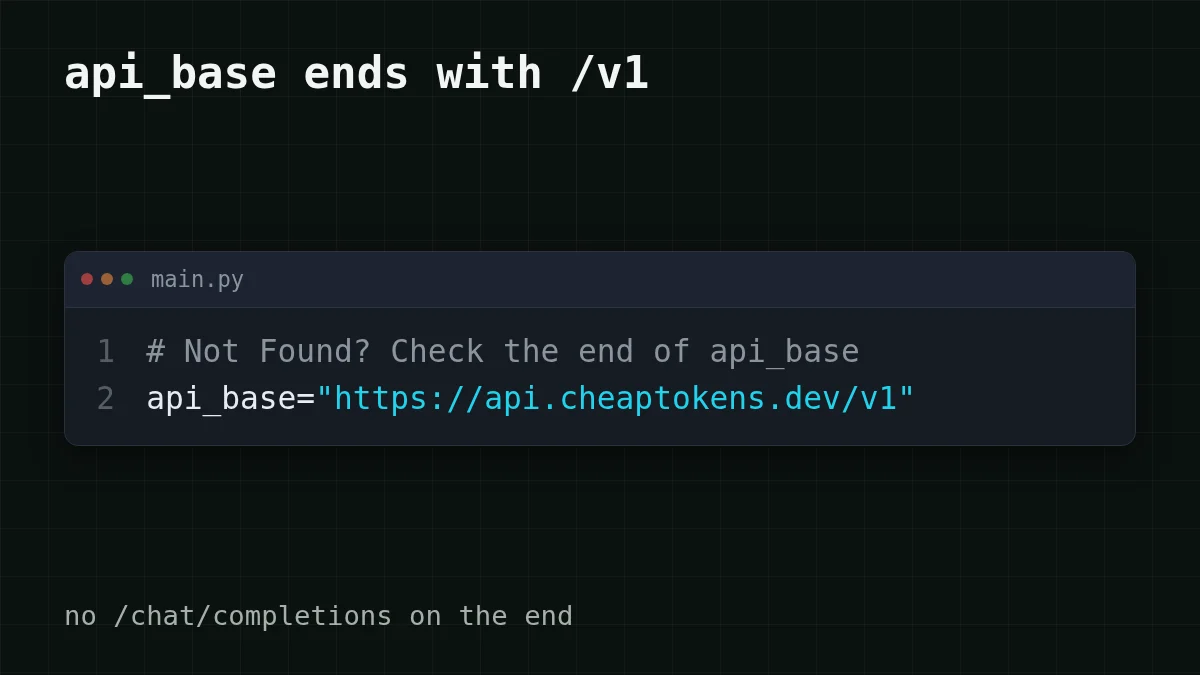
Deux erreurs couvrent la plupart des premiers appels échoués. La documentation LiteLLM indique de ne rien ajouter d'extra à l'URL de base, et qu'en cas d'erreur Not Found, vous devez vérifier que api_base se termine par /v1. Un piège : l'exemple de la documentation pour un proxy local utilise http:/ sans /v1. C'est un autre serveur. Pour CheapTokens, le /v1 reste.
Choisissez votre cas
À quoi ressemble votre erreur ?
Choisissez une option pour voir la réponse
Not Found (404)
Vérifiez api_base. Il doit être exactement https:/, avec /v1 et sans / à la fin. LiteLLM ajoute lui-même le reste du chemin.
401 Unauthorized
La clé est absente, erronée, ou LiteLLM a lu une variable d'environnement vide. Affichez la longueur de os., pas la clé elle-même, pour vérifier qu'elle est définie, et assurez-vous que vous n'avez pas passé une clé OpenAI par habitude.
Le modèle est rejeté
Comparez l'id lettre par lettre avec celui de /v1/models. Le préfixe openai/ est réservé à LiteLLM ; ce qui suit est l'id CheapTokens complet, y compris la partie développeur avant la barre oblique.
Pour le parcours complet des codes de statut, voir API 401 ou 404 : mauvaise clé, URL de base ou id de modèle. Si vous voulez d'abord l'idée derrière api_base, ce qu'est base_url et comment basculer l'explique en langage simple.
Vérification rapide
Votre api_base est https://api.cheaptokens.dev et l'appel renvoie Not Found. Que changez-vous en premier ?
Afficher la réponse
Réponse: Ajouter /v1 pour obtenir https://api.cheaptokens.dev/v1
Not Found pointe vers le chemin. La clé donnerait 401, et le préfixe est ce qui indique à LiteLLM d'utiliser la requête de style OpenAI.
Combien coûtent mille appels#
Supposez qu'un bot de support derrière le proxy envoie 1 000 requêtes par jour, chacune avec environ 2 000 tokens en entrée (la question plus le contexte) et 500 tokens en sortie. Voici cette charge aux tarifs actuels, avec une colonne OpenRouter pour comparer au total, entrée et sortie comptées ensemble :
| Modèle | Entrée $/1M | Sortie $/1M | Par requête | 1 000 requêtes | OpenRouter, 1 000 requêtes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00006 | $0.06 | $0.121 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00008 | $0.08 | $0.173 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00018 | $0.175 | $1.20 |
2 000 tokens d'entrée et 500 tokens de sortie par requête. Les prix par million de tokens sont actuels et évoluent avec nos tarifs ; la colonne OpenRouter indique des prix de référence pour la même charge de travail.
Pour DeepSeek-V4-Flash, cette charge coûte $0.08 par jour, et le tableau montre que c'est moins cher qu'OpenRouter au total. Remplacez les deux nombres par votre propre requête moyenne et vous avez votre budget.
C'est tout ce dont LiteLLM a besoin : trois valeurs, un /v1, et un id de modèle complet. Ajoutez la clé depuis votre tableau de bord et exécutez l'onglet Python.


