API & SDKAnleitung
LiteLLM mit einer benutzerdefinierten api_base: CheapTokens in Python aufrufen
Verwende das openai/-Präfix, api_base und eine vollständige Modell-ID, um CheapTokens aus litellm.completion() und einer LiteLLM-Proxy-config.yaml aufzurufen, und behebe Not Found.
Auf dieser Seite
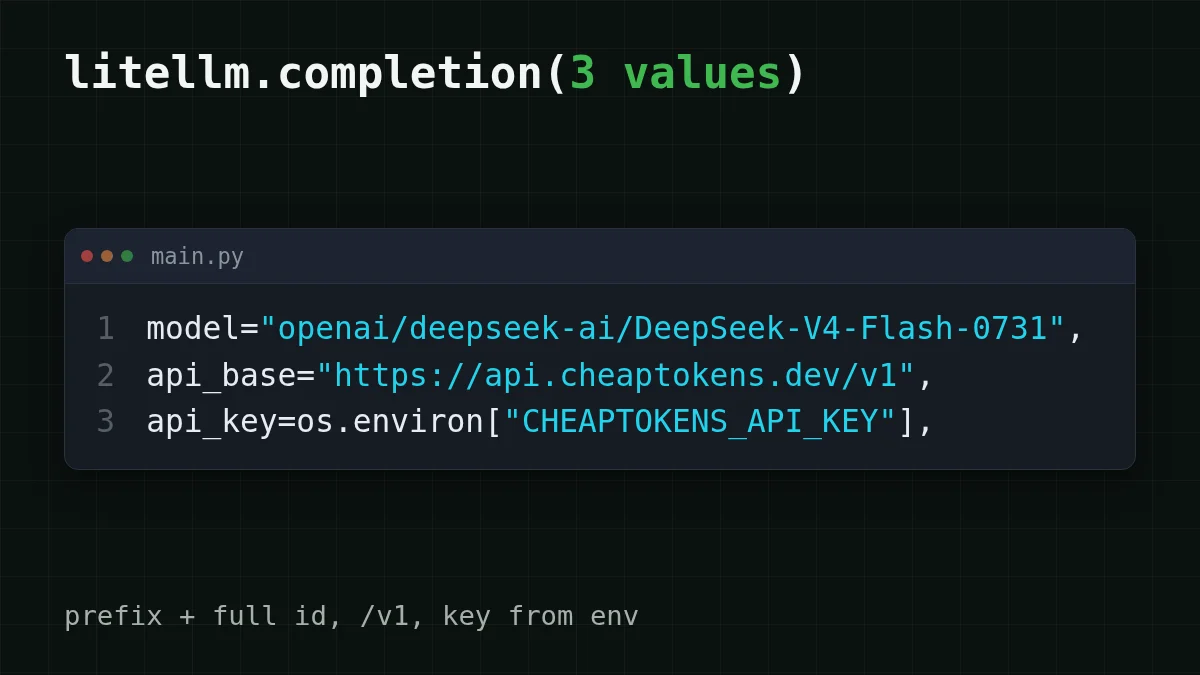
Um LiteLLM auf CheapTokens umzustellen, änderst du drei Werte: model bekommt das Präfix openai/ vor der vollständigen Modell-ID, api_base wird zu https:/, und api_key ist dein CheapTokens-Schlüssel. Das ist der ganze Wechsel, sowohl für litellm. in Python als auch für einen LiteLLM-Proxy.
Angenommen, du hast bereits ein Projekt, das litellm. mit einem OpenAI- oder Anthropic-Modell aufruft, und möchtest ein günstigeres ausprobieren, ohne den restlichen Code anzufassen. Das Präfix ist der entscheidende Punkt: Die Dokumentation zum OpenAI-kompatiblen Provider von LiteLLM (geprüft am 29. Oktober 2026) besagt, dass du für jeden OpenAI-kompatiblen Endpunkt das Modell mit openai/ setzt, damit LiteLLM an den OpenAI-Provider weiterleitet, und dann api_base und api_key daneben übergibst. CheapTokens spricht das OpenAI-Chat-Completions-Format unter https:/, also passt es.
Derselbe Aufruf in Python und im Proxy#
Beide Setups sind kurz. Wähle den Tab, der zu deiner Art passt, LiteLLM zu betreiben.
Ein CheapTokens-Modell, zwei Aufrufwege
Python SDK
import os
import litellm

response = litellm.completion(
    model="openai/deepseek-ai/DeepSeek-V4-Flash-0731",
    api_base="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
    messages=[{"role": "user", "content": "Explain what api_base does in one sentence."}],
    max_tokens=200,
)

print(response.choices[0].message.content)
print(response.usage)
Halte den Schlüssel in einer Umgebungsvariable, nicht in der Datei.
Proxy config.yaml
model_list:
  - model_name: cheap-chat
    litellm_params:
      model: openai/deepseek-ai/DeepSeek-V4-Flash-0731
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
Starte ihn mit litellm -. Clients fragen den Proxy nach cheap-chat und sehen die echte Modell-ID nie.
Den Proxy aufrufen
curl http://localhost:4000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "cheap-chat", "messages": [{"role": "user", "content": "Say hi"}]}'
Der Proxy lauscht standardmäßig auf Port 4000. Tauschst du später das Modell hinter cheap-chat aus, ändert sich diese Anfrage nicht.
Die Modell-ID ist der Punkt, an dem viele stolpern. Die ID, die CheapTokens akzeptiert, ist die vollständige, deepseek-, und openai/ kommt davor. Nicht deepseek-, nicht nur das Präfix plus ein Kurzname. Wenn du unsicher bist, wie ein Modell heißt, liste die Modelle mit GET /v1/models auf und kopiere die ID aus der Antwort.
Was du sehen solltest#
Führe den Python-Tab aus. Der erste print zeigt den Text des Modells. Der zweite zeigt response.usage, die Token-Zahlen für diesen einen Aufruf: prompt_tokens für das, was du gesendet hast, und completion_ für das, was das Modell geschrieben hat. LiteLLM gibt sie im OpenAI-Format zurück, sodass Code, der bereits usage liest, weiter funktioniert. Wenn du diese beiden Zahlen in eine laufende Abrechnung umwandeln willst, zeigt Token-Kosten von Agenten in Python verfolgen, wie das geht.
Weitere Modelle zum Proxy hinzufügen#
Der Sinn von model_name ist, dass deine Clients einen Alias behalten, während du änderst, was dahinter steckt. Eine model_list kann mehrere Einträge enthalten, die alle auf dieselbe api_base und denselben Schlüssel zeigen, weil ein CheapTokens-Guthaben alle Modelle abdeckt:
model_list:
  - model_name: cheap-chat
    litellm_params:
      model: openai/deepseek-ai/DeepSeek-V4-Flash-0731
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
  - model_name: cheap-glm
    litellm_params:
      model: openai/zai-org/GLM-5.3-Flash
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
  - model_name: cheap-minimax
    litellm_params:
      model: openai/MiniMaxAI/MiniMax-M2.7
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
Welcher Alias für welche Aufgabe? Für Chat- und Agent-Aufrufe, bei denen die Antwort lang werden kann, ist DeepSeek-V4-Flash der richtige Einstieg: 380K Kontext, bis zu 32.768 Ausgabe-Token pro Antwort und ein Festpreis ohne Stoßzeiten. GLM-5.3-Flash hat 390K Kontext und bis zu 8.192 Ausgabe-Token. MiniMax-M2.7 hat 180K Kontext. Die DeepSeek-Seite enthält die Details, und die Preisgestaltung listet die aktuellen Tarife für alle drei.
Wenn es schiefgeht: Not Found und 401#
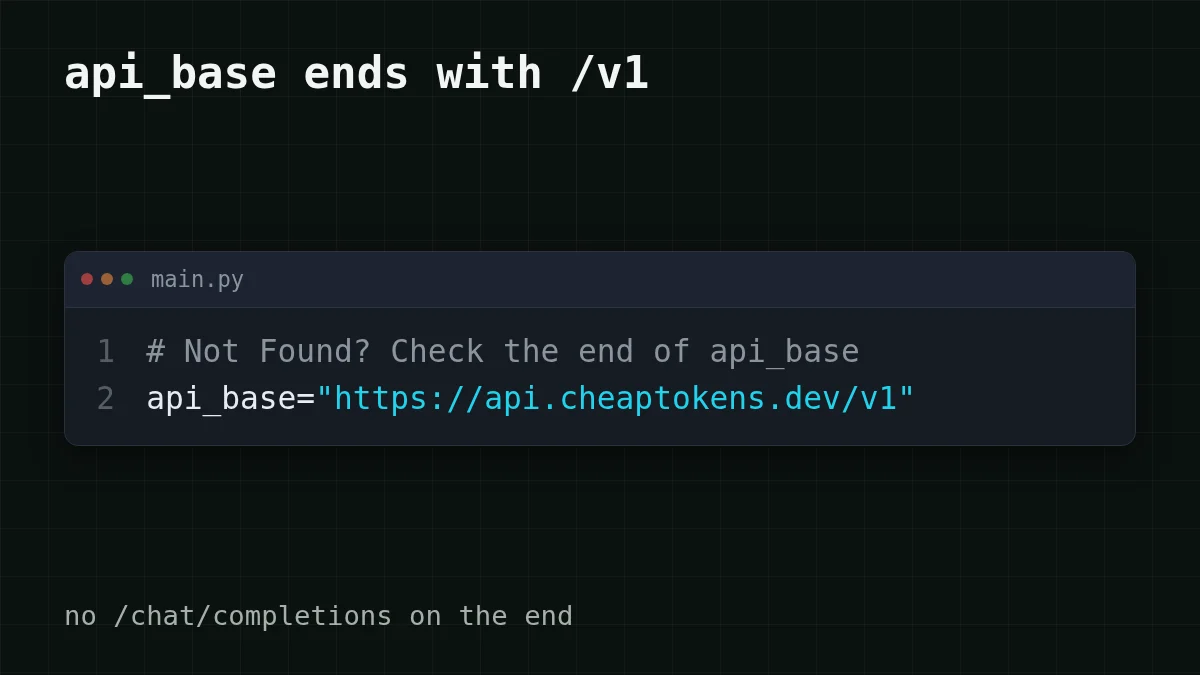
Zwei Fehler decken die meisten fehlgeschlagenen ersten Aufrufe ab. Die LiteLLM-Dokumentation rät davon ab, der Basis-URL etwas Zusätzliches hinzuzufügen, und empfiehlt bei einem Not-Found-Fehler zu prüfen, ob api_base auf /v1 endet. Eine Einschränkung: Das eigene Beispiel der Dokumentation für einen lokalen Proxy verwendet http:/ ohne /v1. Das ist ein anderer Server. Bei CheapTokens bleibt /v1.
Wähle deinen Fall
Wie sieht dein Fehler aus?
Wähle eine Option, um die Antwort zu sehen
Not Found (404)
Prüfe api_base. Es muss genau https:/ sein, mit /v1 und ohne / am Ende. LiteLLM fügt den Rest des Pfads selbst hinzu.
401 Unauthorized
Der Schlüssel fehlt, ist falsch, oder LiteLLM hat eine leere Umgebungsvariable gelesen. Gib die Länge von os. aus, nicht den Schlüssel selbst, um zu prüfen, ob er gesetzt ist, und stelle sicher, dass du nicht aus Gewohnheit einen OpenAI-Schlüssel übergeben hast.
Das Modell wird abgelehnt
Vergleiche die ID Buchstabe für Buchstabe mit der aus /v1/models. Das Präfix openai/ ist nur für LiteLLM; was danach kommt, ist die vollständige CheapTokens-ID, einschließlich des Entwicklerteils vor dem Schrägstrich.
Für den vollständigen Durchgang durch die Statuscodes siehe API 401 oder 404: falscher Schlüssel, falsche Basis-URL oder falsche Modell-ID. Wenn du zuerst die Idee hinter api_base verstehen willst, erklärt was base_url ist und wie man wechselt es in einfacher Sprache.
Kurzer Check
Deine api_base ist https://api.cheaptokens.dev und der Aufruf gibt Not Found zurück. Was änderst du zuerst?
Antwort anzeigen
Antwort: /v1 hinzufügen, sodass es https://api.cheaptokens.dev/v1 lautet
Not Found deutet auf den Pfad hin. Der Schlüssel würde 401 ergeben, und das Präfix ist das, was LiteLLM sagt, dass es die Anfrage im OpenAI-Stil verwenden soll.
Was tausend Aufrufe kosten#
Angenommen, ein Support-Bot hinter dem Proxy sendet 1.000 Anfragen pro Tag, jede mit etwa 2.000 Token Eingabe (die Frage plus Kontext) und 500 Token Ausgabe. Hier ist diese Last zu aktuellen Preisen, mit einer OpenRouter-Spalte zum Vergleich, wobei Eingabe und Ausgabe zusammen gezählt werden:
| Modell | Input $/1M | Output $/1M | Pro Anfrage | 1.000 Anfragen | OpenRouter, 1.000 Anfragen |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00006 | $0.06 | $0.121 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00008 | $0.08 | $0.173 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00018 | $0.175 | $1.20 |
2.000 Input- und 500 Output-Tokens pro Anfrage. Die Preise pro 1 Mio. Tokens sind aktuell und ändern sich zusammen mit unseren Tarifen; die OpenRouter-Spalte zeigt Referenzpreise für dieselbe Arbeitslast.
Für DeepSeek-V4-Flash kostet diese Last $0.08 pro Tag, und die Tabelle zeigt, dass es insgesamt günstiger ist als OpenRouter. Ändere die beiden Zahlen auf deine eigene durchschnittliche Anfrage und du hast dein Budget.
Das ist alles, was LiteLLM braucht: drei Werte, ein /v1 und eine vollständige Modell-ID. Füge den Schlüssel aus deinem Dashboard hinzu und führe den Python-Tab aus.


