API และ SDKคู่มือ
LiteLLM กับ api_base ที่กำหนดเอง: เรียก CheapTokens ใน Python
ใช้คำนำหน้า openai/, api_base และ id โมเดลแบบเต็มเพื่อเรียก CheapTokens จาก litellm.completion() และ LiteLLM proxy config.yaml และแก้ไข Not Found
ในหน้านี้
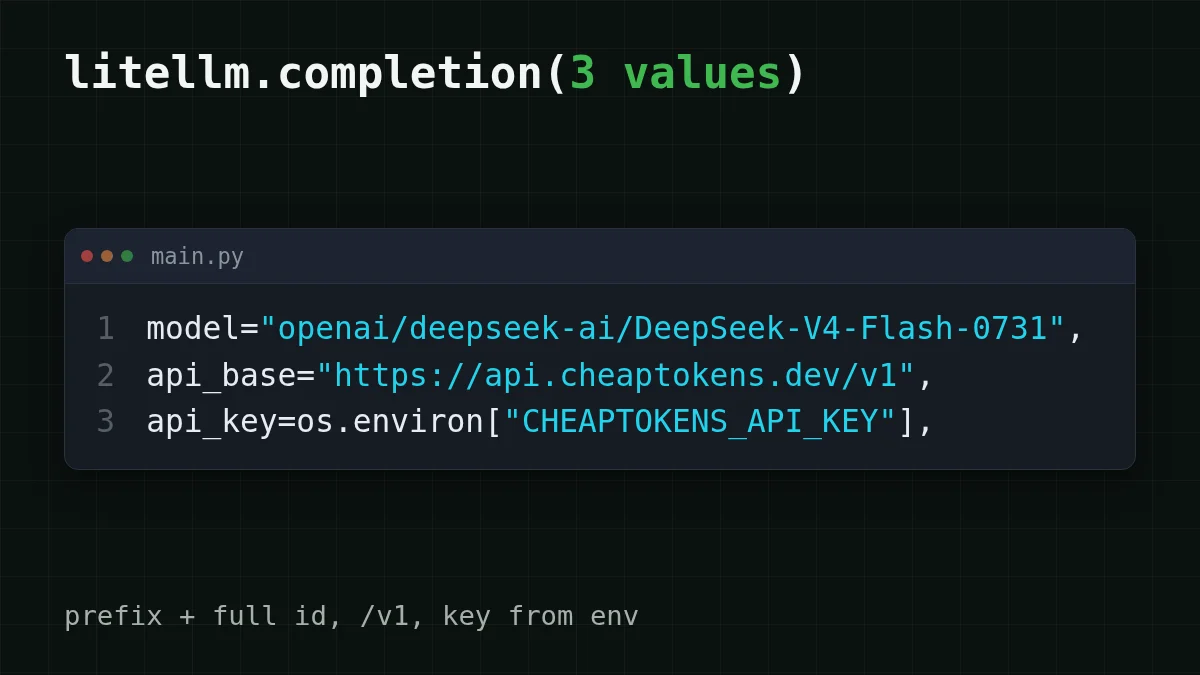
ในการส่ง LiteLLM ไปยัง CheapTokens คุณต้องเปลี่ยนสามค่า: model ใส่คำนำหน้า openai/ ไว้หน้าค่า id ของโมเดลแบบเต็ม, api_base เปลี่ยนเป็น https:/, และ api_key คือคีย์ CheapTokens ของคุณ นั่นคือการสลับทั้งหมด ทั้งสำหรับ litellm. ใน Python และสำหรับ LiteLLM proxy
สมมติว่าคุณมีโปรเจกต์ที่เรียก litellm. ด้วยโมเดล OpenAI หรือ Anthropic อยู่แล้ว และต้องการลองโมเดลที่ถูกกว่าโดยไม่ต้องแตะโค้ดส่วนที่เหลือ คำนำหน้าคือสิ่งที่ทำให้มันทำงาน: เอกสารผู้ให้บริการที่เข้ากันได้กับ OpenAI ของ LiteLLM (ตรวจสอบเมื่อ 29 ตุลาคม 2026) ระบุว่าสำหรับ endpoint ที่เข้ากันได้กับ OpenAI ใดๆ คุณตั้งค่าโมเดลด้วย openai/ เพื่อให้ LiteLLM ส่งต่อไปยังผู้ให้บริการ OpenAI จากนั้นส่ง api_base และ api_key ไปพร้อมกัน CheapTokens พูดรูปแบบ OpenAI Chat Completions ที่ https:/ ดังนั้นจึงเข้ากันได้
การเรียกเดียวกันใน Python และใน proxy#
การตั้งค่าทั้งสองแบบสั้น เลือกแท็บที่ตรงกับวิธีที่คุณรัน LiteLLM
หนึ่งโมเดล CheapTokens สองวิธีในการเรียก
Python SDK
import os
import litellm

response = litellm.completion(
    model="openai/deepseek-ai/DeepSeek-V4-Flash-0731",
    api_base="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
    messages=[{"role": "user", "content": "Explain what api_base does in one sentence."}],
    max_tokens=200,
)

print(response.choices[0].message.content)
print(response.usage)
เก็บคีย์ไว้ในตัวแปรสภาพแวดล้อม ไม่ใช่ในไฟล์
Proxy config.yaml
model_list:
  - model_name: cheap-chat
    litellm_params:
      model: openai/deepseek-ai/DeepSeek-V4-Flash-0731
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
เริ่มด้วย litellm - ไคลเอนต์ขอ cheap-chat จาก proxy และไม่เคยเห็น id โมเดลจริง
เรียก proxy
curl http://localhost:4000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "cheap-chat", "messages": [{"role": "user", "content": "Say hi"}]}'
proxy ฟังที่พอร์ต 4000 โดยค่าเริ่มต้น สลับโมเดลหลัง cheap-chat ในภายหลังและคำขอนี้จะไม่เปลี่ยน
id ของโมเดลคือส่วนที่คนมักสะดุด id ที่ CheapTokens ยอมรับคือแบบเต็ม deepseek- และ openai/ อยู่ข้างหน้า ไม่ใช่ deepseek- ไม่ใช่แค่คำนำหน้าบวกชื่อสั้น หากคุณไม่แน่ใจว่าโมเดลชื่ออะไร แสดงรายการโมเดลด้วย GET /v1/models และคัดลอก id จากคำตอบ
สิ่งที่คุณควรเห็น#
รันแท็บ Python print แรกแสดงข้อความของโมเดล response.usage ที่สองแสดงจำนวนโทเค็นสำหรับการเรียกครั้งนั้น: prompt_tokens สำหรับสิ่งที่คุณส่งไป และ completion_ สำหรับสิ่งที่โมเดลเขียน LiteLLM ส่งคืนในรูปแบบ OpenAI ดังนั้นโค้ดที่อ่าน usage อยู่แล้วยังคงทำงานได้ หากคุณต้องการเปลี่ยนตัวเลขสองตัวนั้นเป็นบิลที่สะสม การติดตามต้นทุนโทเค็นของเอเจนต์ใน Python แสดงวิธี
การเพิ่มโมเดลอื่นๆ ให้ proxy#
จุดประสงค์ของ model_name คือไคลเอนต์ของคุณเก็บ alias หนึ่งไว้ขณะที่คุณเปลี่ยนสิ่งที่อยู่ข้างหลัง model_list สามารถเก็บหลายรายการ ทั้งหมดชี้ไปที่ api_base เดียวกันและคีย์เดียวกัน เพราะยอดคงเหลือ CheapTokens หนึ่งครอบคลุมทุกโมเดล:
model_list:
  - model_name: cheap-chat
    litellm_params:
      model: openai/deepseek-ai/DeepSeek-V4-Flash-0731
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
  - model_name: cheap-glm
    litellm_params:
      model: openai/zai-org/GLM-5.3-Flash
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
  - model_name: cheap-minimax
    litellm_params:
      model: openai/MiniMaxAI/MiniMax-M2.7
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
alias ไหนสำหรับงานไหน? สำหรับการแชทและการเรียกเอเจนต์ที่คำตอบอาจยาว ให้เริ่มด้วย DeepSeek-V4-Flash: บริบท 380K เอาต์พุตสูงสุด 32,768 โทเค็นต่อคำตอบ และราคาคงที่ไม่มีช่วงพีค GLM-5.3-Flash มีบริบท 390K และเอาต์พุตสูงสุด 8,192 โทเค็น MiniMax-M2.7 มีบริบท 180K หน้า DeepSeek มีรายละเอียด และ ราคา แสดงอัตราปัจจุบันสำหรับทั้งสาม
เมื่อมันพัง: Not Found และ 401#
ข้อผิดพลาดสองอย่างครอบคลุมการเรียกครั้งแรกที่ล้มเหลวส่วนใหญ่ เอกสาร LiteLLM ระบุว่าอย่าเพิ่มอะไรพิเศษใน base URL และเมื่อเกิดข้อผิดพลาด Not Found ให้ตรวจสอบว่า api_base ลงท้ายด้วย /v1 ข้อควรระวัง: ตัวอย่างของเอกสารเองสำหรับ proxy ภายในใช้ http:/ โดยไม่มี /v1 นั่นคือเซิร์ฟเวอร์อื่น สำหรับ CheapTokens /v1 ยังคงอยู่
เลือกกรณีของคุณ
ข้อผิดพลาดของคุณเป็นแบบไหน?
เลือกตัวเลือกเพื่อดูคำตอบ
Not Found (404)
ตรวจสอบ api_base ต้องเป็น https:/ อย่างแน่นอน โดยมี /v1 และไม่มี / ต่อท้าย LiteLLM เพิ่มส่วนที่เหลือของพาธเอง
401 Unauthorized
คีย์หาย ผิด หรือ LiteLLM อ่านตัวแปรสภาพแวดล้อมว่าง พิมพ์ความยาวของ os. ไม่ใช่คีย์เอง เพื่อตรวจสอบว่าตั้งค่าแล้ว และตรวจสอบให้แน่ใจว่าคุณไม่ได้ส่งคีย์ OpenAI ตามความเคยชิน
โมเดลถูกปฏิเสธ
เปรียบเทียบ id ทีละตัวอักษรกับที่ได้จาก /v1/models คำนำหน้า openai/ ใช้สำหรับ LiteLLM เท่านั้น สิ่งที่ตามมาคือ id CheapTokens แบบเต็ม รวมถึงส่วนผู้พัฒนาก่อนเครื่องหมายทับ
สำหรับคำอธิบายรหัสสถานะทั้งหมด ดู API 401 หรือ 404: คีย์, base URL หรือ id โมเดลผิด หากคุณต้องการแนวคิดเบื้องหลัง api_base ก่อน base_url คืออะไรและวิธีสลับ อธิบายด้วยเวอร์ชันภาษาง่าย
เช็กด่วน
api_base ของคุณคือ https://api.cheaptokens.dev และการเรียกส่งคืน Not Found คุณเปลี่ยนอะไรก่อน?
แสดงคำตอบ
คำตอบ: เพิ่ม /v1 เพื่อให้อ่านเป็น https://api.cheaptokens.dev/v1
Not Found ชี้ไปที่พาธ คีย์จะให้ 401 และคำนำหน้าคือสิ่งที่บอก LiteLLM ให้ใช้คำขอแบบ OpenAI
การเรียกหนึ่งพันครั้งมีค่าใช้จ่ายเท่าไร#
สมมติว่าบอทสนับสนุนหลัง proxy ส่ง 1,000 คำขอต่อวัน แต่ละครั้งมีประมาณ 2,000 โทเค็นเข้า (คำถามบวกบริบท) และ 500 โทเค็นออก นี่คือโหลดนั้นบนราคาจริง โดยมีคอลัมน์ OpenRouter เพื่อเปรียบเทียบในยอดรวม โดยนับอินพุตและเอาต์พุตรวมกัน:
| โมเดล | Input $/1M | Output $/1M | ต่อคำขอ | 1,000 คำขอ | OpenRouter, 1,000 คำขอ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00006 | $0.06 | $0.121 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00008 | $0.08 | $0.173 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00018 | $0.175 | $1.20 |
2,000 โทเค็นอินพุตและ 500 โทเค็นเอาต์พุตต่อคำขอ ราคาต่อ 1M โทเค็นเป็นราคาปัจจุบันและเปลี่ยนแปลงไปพร้อมกับอัตราค่าบริการของเรา คอลัมน์ OpenRouter แสดงราคาอ้างอิงสำหรับปริมาณงานเดียวกัน
สำหรับ DeepSeek-V4-Flash โหลดนั้นมีค่าใช้จ่าย $0.08 ต่อวัน และตารางแสดงว่าถูกกว่า OpenRouter ในยอดรวม เปลี่ยนตัวเลขสองตัวเป็นค่าเฉลี่ยคำขอของคุณเองแล้วคุณจะได้งบประมาณ
นั่นคือทั้งหมดที่ LiteLLM ต้องการ: สามค่า หนึ่ง /v1 และ id โมเดลแบบเต็ม เพิ่มคีย์จากแดชบอร์ดของคุณและรันแท็บ Python


