APIとSDKガイド
カスタム api_base で LiteLLM を使う: Python で CheapTokens を呼び出す
openai/ プレフィックス、api_base、完全なモデル id を使って litellm.completion() と LiteLLM プロキシの config.yaml から CheapTokens を呼び出し、Not Found を修正します。
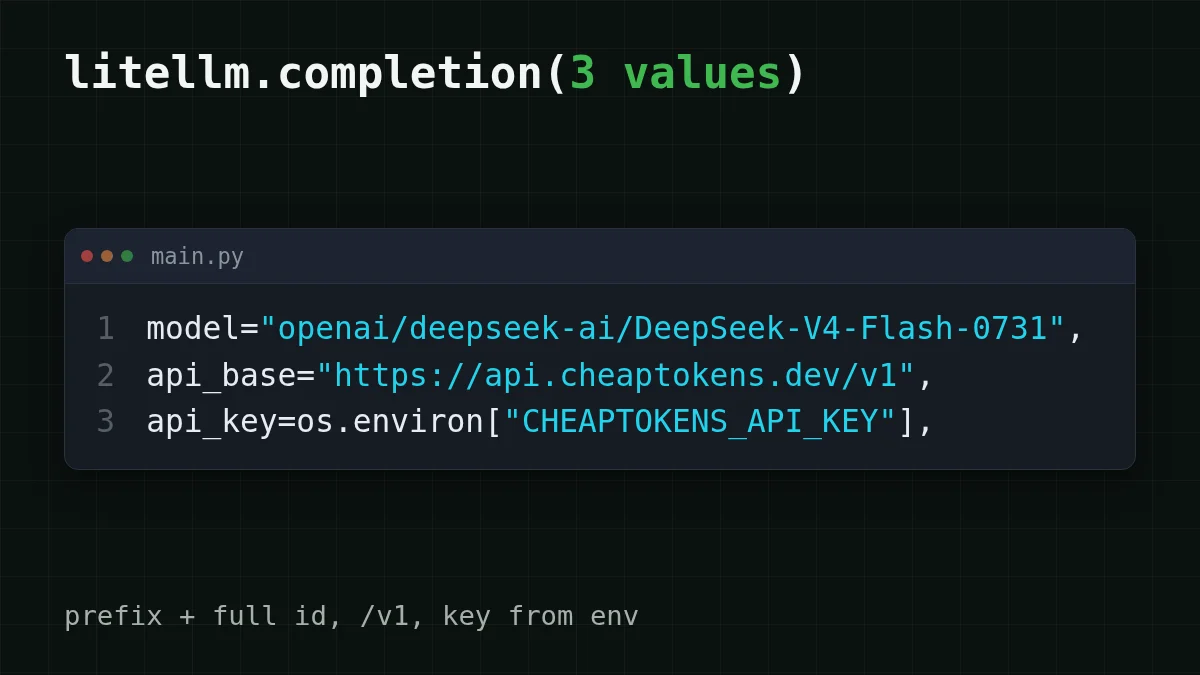
LiteLLM を CheapTokens に向けるには、3 つの値を変更します。model には完全なモデル id の前に openai/ プレフィックスを付け、api_base は https:/ にし、api_key には CheapTokens のキーを設定します。Python での litellm. でも LiteLLM プロキシでも、切り替えはこれだけです。
OpenAI または Anthropic のモデルで litellm. を呼び出しているプロジェクトが既にあり、残りのコードには触れずにもっと安いモデルを試したいとします。これを機能させるのがプレフィックスです。LiteLLM の OpenAI 互換プロバイダーのドキュメント(2026 年 10 月 29 日確認)によると、OpenAI 互換のエンドポイントではモデルを openai/ で設定して LiteLLM が OpenAI プロバイダーにルーティングするようにし、その隣に api_base と api_key を渡します。CheapTokens は https:/ で OpenAI Chat Completions 形式を話すので、これに当てはまります。
Python とプロキシでの同じ呼び出し#
どちらの設定も短いです。LiteLLM の実行方法に合うタブを選んでください。
1 つの CheapTokens モデル、2 通りの呼び出し方
Python SDK
import os
import litellm

response = litellm.completion(
    model="openai/deepseek-ai/DeepSeek-V4-Flash-0731",
    api_base="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
    messages=[{"role": "user", "content": "Explain what api_base does in one sentence."}],
    max_tokens=200,
)

print(response.choices[0].message.content)
print(response.usage)
キーはファイルではなく環境変数に入れてください。
プロキシ config.yaml
model_list:
  - model_name: cheap-chat
    litellm_params:
      model: openai/deepseek-ai/DeepSeek-V4-Flash-0731
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
litellm - で起動します。クライアントはプロキシに cheap-chat を要求し、実際のモデル id を見ることはありません。
プロキシを呼び出す
curl http://localhost:4000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "cheap-chat", "messages": [{"role": "user", "content": "Say hi"}]}'
プロキシはデフォルトでポート 4000 をリッスンします。後で cheap-chat の背後にあるモデルを差し替えても、このリクエストは変わりません。
つまずきやすいのはモデル id の部分です。CheapTokens が受け付ける id は完全なもの、つまり deepseek- で、その前に openai/ を付けます。deepseek- でも、プレフィックスに短い名前を付けただけでもありません。モデル名がわからない場合は、GET /v1/models でモデルを一覧表示し、応答から id をコピーしてください。
表示されるはずのもの#
Python タブを実行します。最初の print はモデルのテキストを表示します。2 つ目は response.usage、つまりその 1 回の呼び出しのトークン数を表示します。送信した分が prompt_tokens、モデルが書いた分が completion_ です。LiteLLM はこれらを OpenAI 形式で返すので、既に usage を読んでいるコードはそのまま動きます。この 2 つの数値を累積の請求額にしたい場合は、Python でエージェントのトークンコストを追跡する方法が参考になります。
プロキシにモデルを追加する#
model_name の狙いは、クライアントが 1 つのエイリアスを持ち続けたまま、その背後にあるものを変更できることです。1 つの CheapTokens 残高がすべてのモデルをカバーするので、model_list には同じ api_base と同じキーを指す複数のエントリを入れられます:
model_list:
  - model_name: cheap-chat
    litellm_params:
      model: openai/deepseek-ai/DeepSeek-V4-Flash-0731
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
  - model_name: cheap-glm
    litellm_params:
      model: openai/zai-org/GLM-5.3-Flash
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
  - model_name: cheap-minimax
    litellm_params:
      model: openai/MiniMaxAI/MiniMax-M2.7
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
どのエイリアスをどの用途に? 回答が長くなる可能性のあるチャットやエージェントの呼び出しには、DeepSeek-V4-Flash から始めるのがおすすめです。コンテキスト 380K、回答あたり最大 32,768 出力トークン、ピーク時間のない固定価格です。GLM-5.3-Flash はコンテキスト 390K、最大 8,192 出力トークンです。MiniMax-M2.7 はコンテキスト 180K です。DeepSeek のページに詳細があり、料金には 3 つすべての現在の料金が掲載されています。
うまくいかないとき: Not Found と 401#
最初の呼び出しの失敗のほとんどは 2 つのエラーで説明できます。LiteLLM のドキュメントでは、ベース URL に余計なものを追加しないこと、Not Found エラーの場合は api_base が /v1 で終わっているか確認することを推奨しています。1 つ注意点があります。ドキュメント自身のローカルプロキシの例では http:/ を /v1 なしで使っています。それは別のサーバーです。CheapTokens では /v1 はそのまま残ります。
ケースを選ぶ
エラーはどのように表示されますか?
オプションを選択して答えを表示
Not Found (404)
api_base を確認してください。正確に https:/ である必要があり、/v1 を含み、末尾に / は付けません。パスの残りは LiteLLM が自分で追加します。
401 Unauthorized
キーがない、間違っている、または LiteLLM が空の環境変数を読んでいます。設定されているか確認するには、キー自体ではなく os. の長さを出力してください。また、習慣で OpenAI のキーを渡していないか確認してください。
モデルが拒否される
id を /v1/models のものと 1 文字ずつ比較してください。openai/ プレフィックスは LiteLLM 専用です。その後に続くのは完全な CheapTokens の id で、スラッシュより前の開発者部分も含みます。
ステータスコードの完全な解説は API 401 または 404: キー、ベース URL、モデル id の誤りを参照してください。まず api_base の考え方を知りたい場合は、base_url とは何か、切り替え方法が平易な言葉で説明しています。
クイックチェック
api_base が https://api.cheaptokens.dev で、呼び出しが Not Found を返します。最初に何を変更しますか?
答えを表示
答え: /v1 を追加して https://api.cheaptokens.dev/v1 にする
Not Found はパスを指します。キーなら 401 になり、プレフィックスは LiteLLM に OpenAI 形式のリクエストを使うよう伝えるものです。
1,000 回の呼び出しにかかるコスト#
プロキシの背後にあるサポートボットが 1 日 1,000 リクエストを送信し、各リクエストが入力約 2,000 トークン(質問とコンテキスト)と出力 500 トークンだとします。この負荷を実際の価格に当てはめたものが以下で、比較用に OpenRouter の列もあり、合計・入力・出力を合わせて計算しています:
| モデル | 入力 $/1M | 出力 $/1M | リクエストあたり | 1,000 リクエスト | OpenRouter、1,000 リクエスト |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00006 | $0.06 | $0.121 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00008 | $0.08 | $0.173 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00018 | $0.175 | $1.20 |
リクエストあたり 2,000 入力トークンと 500 出力トークン。100万トークンあたりの価格は現行のもので、当社の料金体系に合わせて変動します。OpenRouter 列は同じワークロードの参考価格を示しています。
DeepSeek-V4-Flash ではこの負荷のコストは 1 日あたり $0.08 で、表から合計では OpenRouter より安いことがわかります。2 つの数値を自分の平均リクエストに置き換えれば、予算が算出できます。
LiteLLM に必要なのはこれだけです。3 つの値、1 つの /v1、そして完全なモデル id です。ダッシュボードからキーを追加して、Python タブを実行してください。


