API e SDKGuia
LiteLLM com um api_base personalizado: chamar o CheapTokens em Python
Use o prefixo openai/, api_base e um id de modelo completo para chamar o CheapTokens a partir de litellm.completion() e de um config.yaml do proxy LiteLLM, e corrija o Not Found.
Nesta página
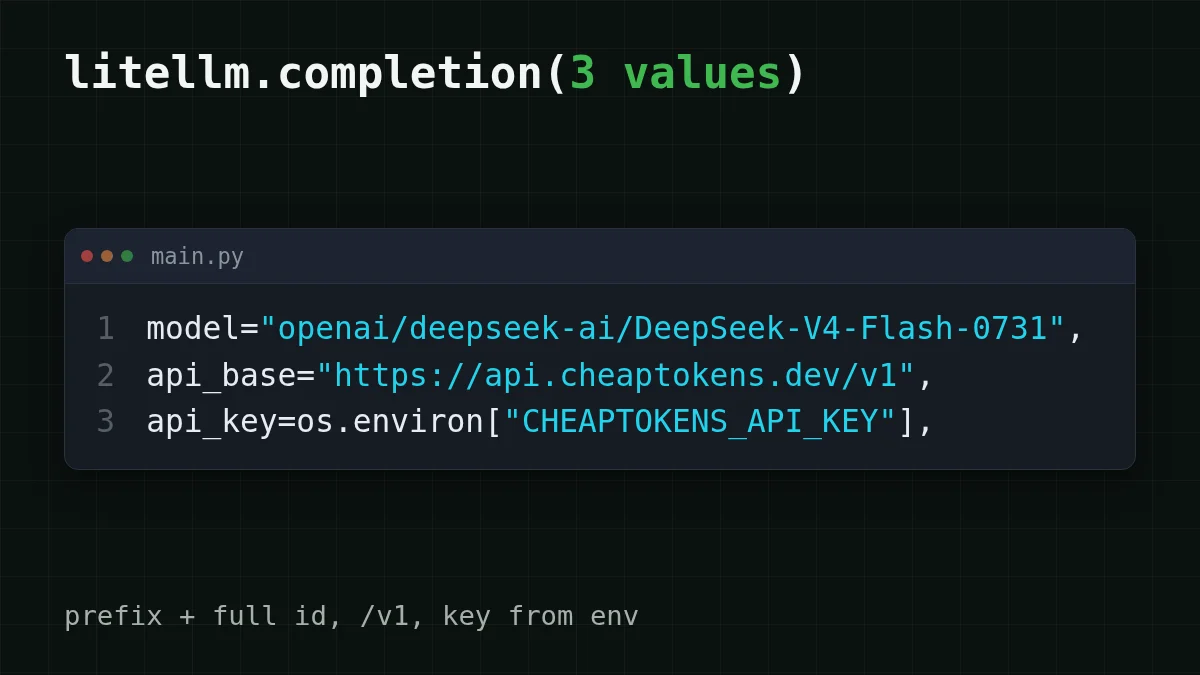
Para enviar o LiteLLM para o CheapTokens, você altera três valores: model recebe o prefixo openai/ na frente do id completo do modelo, api_base passa a ser https:/, e api_key é a sua chave do CheapTokens. Essa é toda a troca, tanto para litellm. em Python quanto para um proxy LiteLLM.
Digamos que você já tenha um projeto que chama litellm. com um modelo OpenAI ou Anthropic, e queira testar um mais barato sem mexer no restante do código. O prefixo é o que faz funcionar: a documentação do provedor compatível com OpenAI do LiteLLM (verificada em 29 de outubro de 2026) diz que, para qualquer endpoint compatível com OpenAI, você define o modelo com openai/ para que o LiteLLM roteie para o provedor OpenAI, e então passa api_base e api_key junto. O CheapTokens fala o formato OpenAI Chat Completions em https:/, então encaixa.
A mesma chamada em Python e em um proxy#
As duas configurações são curtas. Escolha a aba que corresponde a como você roda o LiteLLM.
Um modelo CheapTokens, duas formas de chamar
SDK Python
import os
import litellm

response = litellm.completion(
    model="openai/deepseek-ai/DeepSeek-V4-Flash-0731",
    api_base="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
    messages=[{"role": "user", "content": "Explain what api_base does in one sentence."}],
    max_tokens=200,
)

print(response.choices[0].message.content)
print(response.usage)
Mantenha a chave em uma variável de ambiente, não no arquivo.
config.yaml do proxy
model_list:
  - model_name: cheap-chat
    litellm_params:
      model: openai/deepseek-ai/DeepSeek-V4-Flash-0731
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
Inicie com litellm -. Os clientes pedem cheap-chat ao proxy e nunca veem o id real do modelo.
Chamar o proxy
curl http://localhost:4000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "cheap-chat", "messages": [{"role": "user", "content": "Say hi"}]}'
O proxy escuta na porta 4000 por padrão. Troque o modelo por trás de cheap-chat depois e esta requisição não muda.
O id do modelo é a parte em que as pessoas tropeçam. O id que o CheapTokens aceita é o completo, deepseek-, e openai/ vai na frente dele. Não deepseek-, nem apenas o prefixo mais um nome curto. Se você não tem certeza do nome de um modelo, liste os modelos com GET /v1/models e copie o id da resposta.
O que você deve ver#
Rode a aba Python. O primeiro print mostra o texto do modelo. O segundo mostra response.usage, as contagens de tokens daquela chamada: prompt_tokens para o que você enviou e completion_ para o que o modelo escreveu. O LiteLLM os retorna no formato OpenAI, então o código que já lê usage continua funcionando. Se você quiser transformar esses dois números em uma conta corrente, rastrear o custo de tokens de agentes em Python mostra como.
Adicionando mais modelos ao proxy#
O ponto de model_name é que seus clientes mantêm um alias enquanto você muda o que está por trás dele. Um model_list pode conter várias entradas, todas apontando para o mesmo api_base e a mesma chave, porque um saldo do CheapTokens cobre todos os modelos:
model_list:
  - model_name: cheap-chat
    litellm_params:
      model: openai/deepseek-ai/DeepSeek-V4-Flash-0731
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
  - model_name: cheap-glm
    litellm_params:
      model: openai/zai-org/GLM-5.3-Flash
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
  - model_name: cheap-minimax
    litellm_params:
      model: openai/MiniMaxAI/MiniMax-M2.7
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
Qual alias para qual tarefa? Para chamadas de chat e de agentes em que a resposta pode ser longa, o DeepSeek-V4-Flash é o indicado para começar: contexto de 380K, até 32.768 tokens de saída por resposta e preço fixo sem horários de pico. O GLM-5.3-Flash tem contexto de 390K e até 8.192 tokens de saída. O MiniMax-M2.7 tem contexto de 180K. A página do DeepSeek tem os detalhes, e preços lista as tarifas atuais dos três.
Quando quebra: Not Found e 401#
Dois erros cobrem a maioria das primeiras chamadas que falham. A documentação do LiteLLM diz para não adicionar nada extra à URL base e que, em um erro Not Found, você deve verificar se api_base termina em /v1. Uma ressalva: o próprio exemplo da documentação para um proxy local usa http:/ sem /v1. Esse é um servidor diferente. Para o CheapTokens, o /v1 permanece.
Escolha o seu caso
Como está o seu erro?
Escolha uma opção para ver a resposta
Not Found (404)
Verifique api_base. Deve ser exatamente https:/, com /v1 e sem / no final. O LiteLLM adiciona o restante do caminho sozinho.
401 Unauthorized
A chave está ausente, errada, ou o LiteLLM leu uma variável de ambiente vazia. Imprima o comprimento de os., não a chave em si, para verificar se está definida, e certifique-se de que você não passou uma chave OpenAI por hábito.
O modelo é rejeitado
Compare o id letra por letra com o de /v1/models. O prefixo openai/ é só para o LiteLLM; o que vem depois é o id completo do CheapTokens, incluindo a parte do desenvolvedor antes da barra.
Para o passo a passo completo sobre códigos de status, veja API 401 ou 404: chave, URL base ou id de modelo errados. Se você quiser primeiro a ideia por trás de api_base, o que é base_url e como trocar explica em linguagem simples.
Verificação rápida
Seu api_base é https://api.cheaptokens.dev e a chamada retorna Not Found. O que você muda primeiro?
Mostrar resposta
Resposta: Adicionar /v1 para ficar https://api.cheaptokens.dev/v1
Not Found aponta para o caminho. A chave daria 401, e o prefixo é o que diz ao LiteLLM para usar a requisição no estilo OpenAI.
Quanto custam mil chamadas#
Suponha que um bot de suporte atrás do proxy envie 1.000 requisições por dia, cada uma com cerca de 2.000 tokens de entrada (a pergunta mais o contexto) e 500 tokens de saída. Aqui está essa carga com preços atuais, com uma coluna OpenRouter para comparar no total, entrada e saída somadas:
| Modelo | Entrada $/1M | Saída $/1M | Por solicitação | 1.000 solicitações | OpenRouter, 1.000 solicitações |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00006 | $0.06 | $0.121 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00008 | $0.08 | $0.173 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00018 | $0.175 | $1.20 |
2.000 tokens de entrada e 500 tokens de saída por solicitação. Os preços por 1M de tokens são atuais e mudam junto com nossas tarifas; a coluna OpenRouter mostra preços de referência para a mesma carga de trabalho.
Para o DeepSeek-V4-Flash, essa carga custa $0.08 por dia, e a tabela mostra que é mais barato que o OpenRouter no total. Troque os dois números pela sua média de requisição e você tem seu orçamento.
É tudo o que o LiteLLM precisa: três valores, um /v1 e um id de modelo completo. Adicione a chave do seu painel e rode a aba Python.


