API & SDK가이드
커스텀 api_base로 LiteLLM 사용하기: Python에서 CheapTokens 호출
openai/ 접두사, api_base, 전체 모델 id로 litellm.completion()과 LiteLLM 프록시 config.yaml에서 CheapTokens를 호출하고 Not Found를 해결하세요.
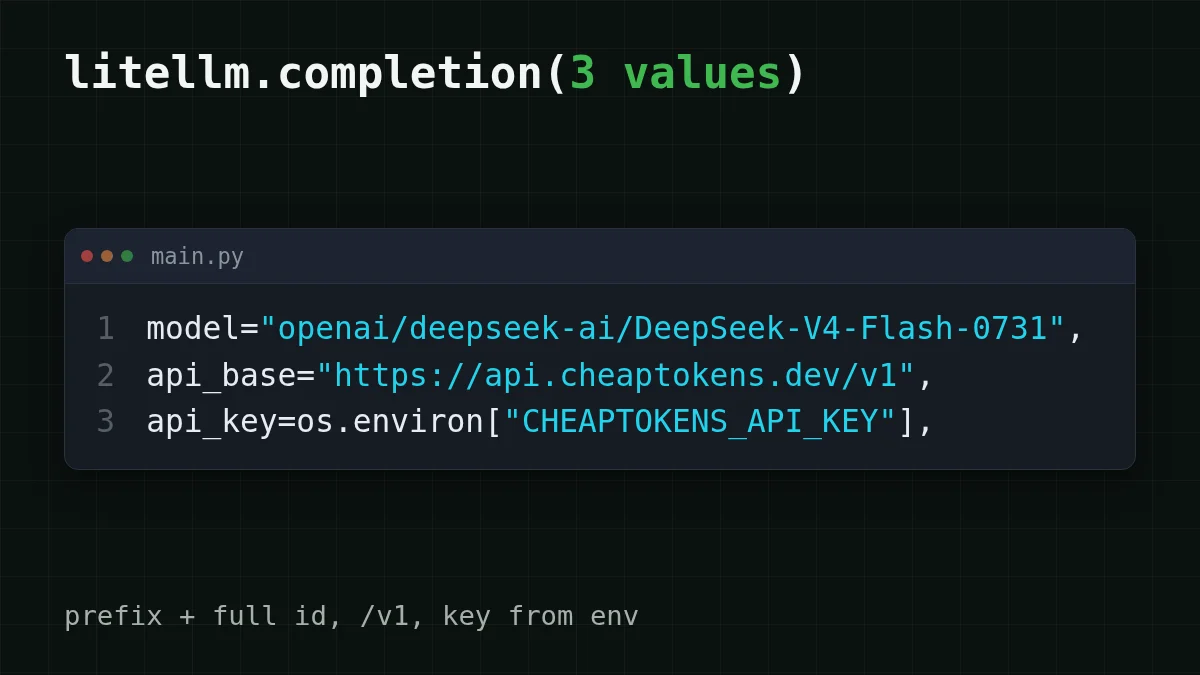
LiteLLM을 CheapTokens로 보내려면 세 가지 값을 바꾸면 됩니다. model에는 전체 모델 id 앞에 openai/ 접두사를 붙이고, api_base는 https:/가 되며, api_key에는 CheapTokens 키를 넣습니다. Python의 litellm.든 LiteLLM 프록시든 전환은 이게 전부입니다.
OpenAI나 Anthropic 모델로 litellm.를 호출하는 프로젝트가 이미 있고, 나머지 코드는 건드리지 않은 채 더 저렴한 모델을 시험해 보고 싶다고 해 봅시다. 이걸 가능하게 하는 게 바로 접두사입니다. LiteLLM의 OpenAI 호환 제공자 문서(2026년 10월 29일 확인)에 따르면 OpenAI 호환 엔드포인트에서는 모델을 openai/로 설정해 LiteLLM이 OpenAI 제공자로 라우팅되게 한 다음, 그 옆에 api_base과 api_key를 넘기라고 되어 있습니다. CheapTokens는 https:/에서 OpenAI Chat Completions 형식을 지원하므로 잘 맞습니다.
Python과 프록시에서의 동일한 호출#
두 설정 모두 짧습니다. LiteLLM을 실행하는 방식에 맞는 탭을 고르세요.
CheapTokens 모델 하나, 호출 방법 두 가지
Python SDK
import os
import litellm

response = litellm.completion(
    model="openai/deepseek-ai/DeepSeek-V4-Flash-0731",
    api_base="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
    messages=[{"role": "user", "content": "Explain what api_base does in one sentence."}],
    max_tokens=200,
)

print(response.choices[0].message.content)
print(response.usage)
키는 파일이 아니라 환경 변수에 두세요.
프록시 config.yaml
model_list:
  - model_name: cheap-chat
    litellm_params:
      model: openai/deepseek-ai/DeepSeek-V4-Flash-0731
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
litellm -로 시작하세요. 클라이언트는 프록시에 cheap-chat를 요청하며 실제 모델 id는 보지 못합니다.
프록시 호출
curl http://localhost:4000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "cheap-chat", "messages": [{"role": "user", "content": "Say hi"}]}'
프록시는 기본적으로 4000번 포트에서 수신합니다. 나중에 cheap-chat 뒤의 모델을 바꿔도 이 요청은 바뀌지 않습니다.
사람들이 자주 걸리는 부분이 모델 id입니다. CheapTokens가 받는 id는 전체 id인 deepseek-이며, 그 앞에 openai/가 붙습니다. deepseek-도 아니고, 접두사에 짧은 이름만 붙인 것도 아닙니다. 모델 이름이 확실하지 않다면 GET /v1/models로 모델 목록을 조회하고 응답에서 id를 복사하세요.
확인해야 할 결과#
Python 탭을 실행하세요. 첫 번째 print는 모델의 텍스트를 보여 줍니다. 두 번째는 response.usage, 즉 해당 호출 한 번의 토큰 수를 보여 주는데, 보낸 것에 대해 prompt_tokens, 모델이 쓴 것에 대해 completion_입니다. LiteLLM은 이를 OpenAI 형식으로 반환하므로 이미 usage를 읽는 코드는 그대로 동작합니다. 이 두 숫자를 누적 요금으로 바꾸고 싶다면 Python에서 에이전트 토큰 비용 추적하기를 참고하세요.
프록시에 모델 더 추가하기#
model_name의 핵심은 뒤에 있는 모델을 바꾸는 동안 클라이언트는 하나의 별칭을 유지한다는 점입니다. 하나의 CheapTokens 잔액이 모든 모델을 커버하므로 model_list에는 같은 api_base와 같은 키를 가리키는 여러 항목을 넣을 수 있습니다:
model_list:
  - model_name: cheap-chat
    litellm_params:
      model: openai/deepseek-ai/DeepSeek-V4-Flash-0731
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
  - model_name: cheap-glm
    litellm_params:
      model: openai/zai-org/GLM-5.3-Flash
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
  - model_name: cheap-minimax
    litellm_params:
      model: openai/MiniMaxAI/MiniMax-M2.7
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
어떤 작업에 어떤 별칭을 쓸까요? 답변이 길어질 수 있는 채팅과 에이전트 호출에는 DeepSeek-V4-Flash로 시작하는 게 좋습니다. 380K 컨텍스트, 답변당 최대 32,768 출력 토큰, 피크 시간 없는 고정 가격입니다. GLM-5.3-Flash는 390K 컨텍스트와 최대 8,192 출력 토큰을 가집니다. MiniMax-M2.7은 180K 컨텍스트입니다. 자세한 내용은 DeepSeek 페이지에 있고, 가격에는 세 모델의 현재 요금이 나와 있습니다.
문제가 생길 때: Not Found와 401#
대부분의 첫 호출 실패는 두 가지 오류로 설명됩니다. LiteLLM 문서에 따르면 base URL에 아무것도 덧붙이지 말아야 하며, Not Found 오류가 나면 api_base이 /v1로 끝나는지 확인해야 합니다. 한 가지 주의할 점: 문서 자체의 로컬 프록시 예시는 /v1 없이 http:/를 사용합니다. 그건 다른 서버입니다. CheapTokens에서는 /v1가 유지됩니다.
사례 선택하기
오류가 어떻게 나오나요?
답을 보려면 옵션을 선택하세요
Not Found (404)
api_base를 확인하세요. 정확히 https:/여야 하며, /v1가 있고 끝에 /가 없어야 합니다. 나머지 경로는 LiteLLM이 직접 붙입니다.
401 Unauthorized
키가 없거나, 틀렸거나, LiteLLM이 빈 환경 변수를 읽은 경우입니다. 키 자체가 아니라 os.의 길이를 출력해 설정 여부를 확인하고, 습관적으로 OpenAI 키를 넘기지 않았는지 확인하세요.
모델이 거부됨
id를 /v1/models에서 가져온 것과 한 글자씩 비교하세요. openai/ 접두사는 LiteLLM 전용이며, 그 뒤에는 슬래시 앞의 개발자 부분을 포함한 전체 CheapTokens id가 옵니다.
상태 코드 전체 설명은 API 401 또는 404: 잘못된 키, base URL 또는 모델 id를 참고하세요. api_base의 개념부터 알고 싶다면 base_url이란 무엇이고 어떻게 전환하는가에서 쉬운 말로 설명합니다.
빠른 확인
api_base가 https://api.cheaptokens.dev인데 호출이 Not Found를 반환합니다. 무엇을 먼저 바꾸시겠습니까?
정답 보기
정답: /v1을 추가해 https://api.cheaptokens.dev/v1가 되도록
Not Found는 경로를 가리킵니다. 키 문제라면 401이 나왔을 것이고, 접두사는 LiteLLM에 OpenAI 방식 요청을 쓰라고 알려 주는 역할입니다.
1,000회 호출 비용#
프록시 뒤의 지원 봇이 하루 1,000건의 요청을 보내고, 각 요청은 입력 약 2,000 토큰(질문과 컨텍스트)과 출력 500 토큰이라고 가정해 봅시다. 실제 가격 기준으로 이 부하를 계산한 표이며, 비교를 위해 OpenRouter 열도 함께 두었습니다(총액, 입력과 출력 합산):
| 모델 | 입력 $/1M | 출력 $/1M | 요청당 | 1,000회 요청 | OpenRouter, 1,000회 요청 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00006 | $0.06 | $0.121 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00008 | $0.08 | $0.173 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00018 | $0.175 | $1.20 |
요청당 입력 2,000개 및 출력 500개 토큰입니다. 100만 토큰당 가격은 현재 기준이며 당사 요금제에 따라 함께 변경됩니다. OpenRouter 열은 동일한 작업량에 대한 참고 가격을 보여줍니다.
DeepSeek-V4-Flash의 경우 이 부하는 하루 $0.08이며, 표에서 총액이 OpenRouter보다 저렴함을 알 수 있습니다. 두 숫자를 자신의 평균 요청으로 바꾸면 예산이 나옵니다.
LiteLLM에 필요한 건 이게 전부입니다. 세 가지 값, 하나의 /v1, 그리고 전체 모델 id입니다. 대시보드에서 키를 추가하고 Python 탭을 실행하세요.


