故障排查指南
LLM 回复上的 json.JSONDecodeError:在 Python 中提取 JSON
json.loads 在模型回复上失败?读取 exc.pos 和 finish_reason 找出原因,然后用 raw_decode 提取 JSON 并重试一次。
本页内容
你的脚本向模型请求 JSON,调用 json.,然后因 json. 而崩溃。通常模型确实回答了:它把 JSON 包在 ```json fence, put a line of chat in front of it, or ran into max_tokens halfway through. Look at exc.pos and finish_reason to tell which one it is, pull the object out with JSONDecoder. 中,如果什么都救不回来,就重试一次。
回复破坏 json.loads 的三种方式#
Python 的 json 文档(Python 3.15 文档,2026 年 11 月 2 日查阅)说 JSONDecodeError 是 ValueError 的子类,带有属性 msg、doc、pos、lineno 和 colno。这里重要的是 pos:解析失败的字符串中的索引。
假设一个脚本从客户邮件中提取字段,并要求 {"name": .。下面这三个字符串就是会破坏它的回复。把它们粘贴到 Python shell 中:
import json

fenced = '```json\n{"name": "Anna", "age": 31}\n```'
chatty = 'Sure! Here is the JSON:\n{"name": "Anna", "age": 31}'
cut = '{"name": "Anna", "age": 31'

for reply in (fenced, chatty, cut):
    try:
        json.loads(reply)
    except json.JSONDecodeError as exc:
        print(exc.pos, len(reply))
前两个在 pos 0 处失败:解析器查看了第一个字符,一个反引号或一个 S,然后放弃了。第三个在字符串末尾失败(pos 等于 len(reply)):它读取的所有内容都没问题,然后文本用完了。这个差异就是你的诊断。位置 0 意味着 JSON 可能就在那里,只是被包裹了。位置在末尾意味着答案提前停止了。
被截断的答案:解析前先检查 finish_reason#
中途停止的回复不是解析问题,而是长度问题。API 会告诉你:choice 带有 finish_reason,而 "length" 意味着答案被 max_tokens 截断了(完整说明见 AI 答案被截断?修复 finish_reason "length" 和 max_tokens)。在做任何提取之前先看它。
如果跳过这一步,会有一个讨厌的陷阱。一个寻找第一个可解析 { 的扫描器可能会从一个半完成的外部对象中拾取一个完整的内部对象,你的脚本会带着错误的数据继续运行,而且没有错误。试试看:
自己试试试试看:一个“查找第一个对象”的函数对这个被截断的回复返回什么?显示答案
取 '{"user": {"name": "Anna"}, "age": 31'。外部对象永远不会闭合,但内部的 {"name": "Anna"} 是完整的,所以下面的提取器返回 {'name': 'Anna'}。没有异常,结果错误。这就是为什么 finish_reason 检查在提取之前。
对于真正被截断的情况,修复方法是更多空间:提高 max_tokens。DeepSeek-V4-Flash 每次答案最多允许 32,768 个输出 token,GLM-5.3-Flash 最多 8,192,所以长的 JSON 列表在第一个上有更多空间。模型的详细信息在 CheapTokens 模型页面。
从文本中提取 JSON#
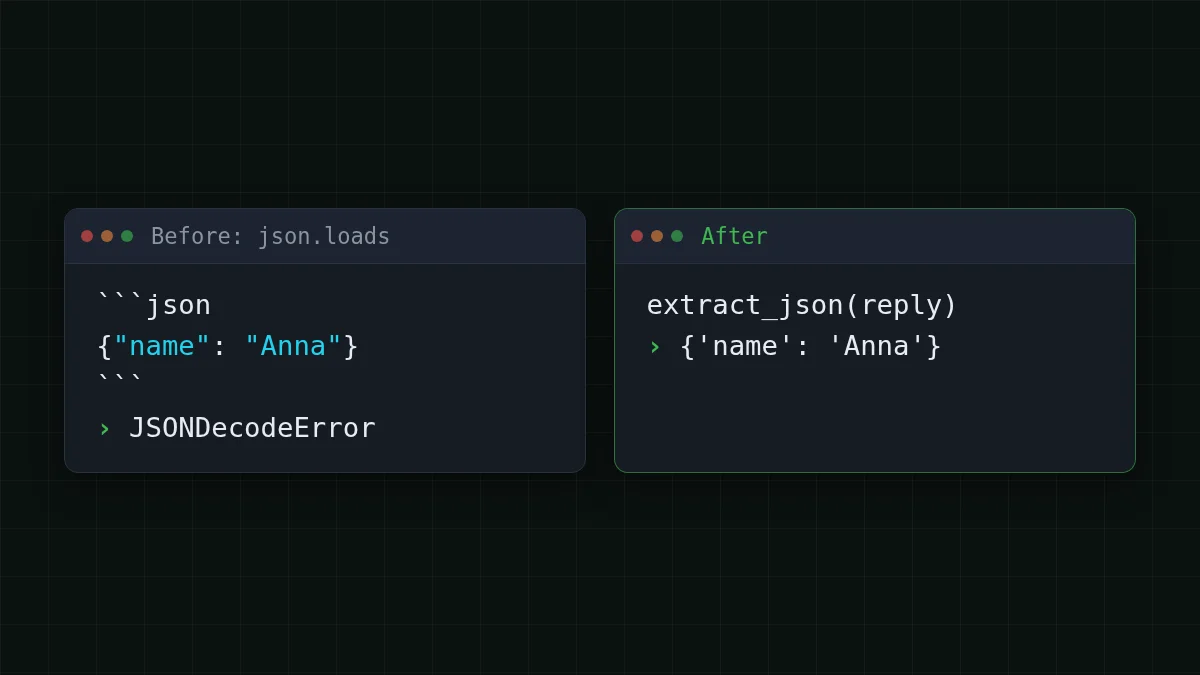
对于代码围栏和闲聊,标准库已经有工具了。根据同一个 Python 页面,JSONDecoder. 从以 JSON 文档开头的字符串中解码 JSON 文档,并返回对象以及文档结束的索引。文档说它可以用于末尾有多余数据的字符串。它要求文档从第一个字符开始,所以先切掉前面的文本:寻找一个 {,尝试从那里解码,如果失败就继续下一个 {。
import json

def extract_json(text):
    """Return the first JSON object found in text, or raise ValueError."""
    decoder = json.JSONDecoder()
    for i, ch in enumerate(text):
        if ch == '{':
            try:
                obj, _end = decoder.raw_decode(text[i:])
                return obj
            except json.JSONDecodeError:
                continue
    raise ValueError('no JSON object in the reply')
它处理围栏(前导的 ```json is skipped because it is not a {), the sentence before the object, and text after the closing brace. Expecting a list? Look for '[' instead. Don't look for both: a stray [1] 在像“see note [1]”这样的句子中是有效的 JSON,并且会胜出。
它故意不做两件事。它从不编辑文本(没有删除反引号的正则表达式,没有猜测缺失的括号),所以你不能把损坏的回复变成有效但错误的数据。而且当找不到任何东西时它会大声失败,这正是下面重试所需要的。
用更严格的提示重试一次#
如果回复被截断或完全不包含对象,再问一次。一次,不是无限循环。对于截断,给第二次尝试更多空间;否则直接说明你想要什么。这使用 OpenAI Python SDK 针对 CheapTokens 基础 URL(https:/)和文档中的完整模型 id;密钥放在环境变量中。
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
STRICT = '\n\nReply with one JSON object only. No text before or after it, no code fence.'

def ask_json(prompt, max_tokens=800):
    content = prompt
    for attempt in (1, 2):
        resp = client.chat.completions.create(
            model=MODEL,
            messages=[{'role': 'user', 'content': content}],
            max_tokens=max_tokens,
        )
        choice = resp.choices[0]
        if choice.finish_reason == 'length':
            max_tokens *= 2          # cut off: more room next time
        else:
            try:
                return extract_json(choice.message.content or '')
            except ValueError:
                pass                 # no object: try the stricter prompt
        content = prompt + STRICT
    raise ValueError('no valid JSON after one retry')
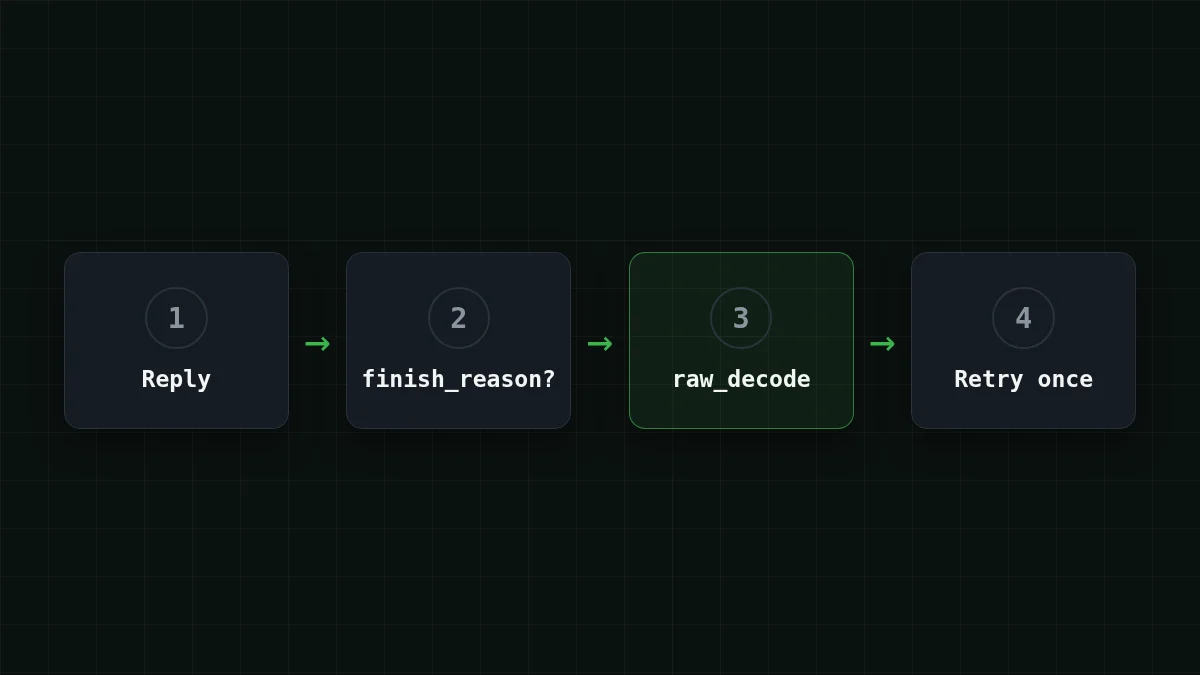
顺序是关键:先 finish_reason,其次提取,然后才重试。在第二次尝试后抛出错误,这样批处理作业可以记录该项并继续。
重试的成本很容易估算。假设一个请求有 1,200 个输入 token 和 300 个输出 token(这是一个假设,使用你自己的数字):DeepSeek-V4-Flash 上为 $0.000048,GLM-5.3-Flash 上为 $0.000036。如果 1,000 个请求中有 30 个需要第二次尝试,额外账单是 30 × 该请求,DeepSeek-V4-Flash 上为 $0.0014。价格是实时的,来自当前价格表。
排序
把修复步骤排好序
拖动项目或使用箭头
- 检查 finish_reason:如果它说 length,就停在这里
- 找到第一个 { 并切掉它之前的文本
- 用 raw_decode 解码并忽略后面的内容
- 如果什么都没找到,用更严格的提示重试一次
哪种症状,哪种修复#
上面的步骤在你脑子里直到下一个奇怪的错误出现。这就像查表:找到你在屏幕上看到的内容,然后阅读修复方法。
选择你的情况
选择你看到的内容
选择一个选项以查看答案
json.loads 在 pos 0 处失败
回复以围栏或句子开头。让它通过 extract_json;不需要重试。
pos 在字符串末尾
答案提前停止了。检查 finish_reason:如果它是 length,提高 max_tokens 并再次询问。
错误在中间某处
模型自己写了损坏的 JSON(缺少逗号、尾随逗号、未转义的引号)。不要修补它:用更严格的提示重试一次,如果再次失败就记录回复。
json.loads 有效但缺少一个键
解析没问题,内容不对。在提示中列出确切的键,并在解析后在代码中检查它们。
API 能强制有效 JSON 吗?#
有时可以。OpenAI 的结构化输出指南记录了两种模式:JSON 模式(type: json_),返回有效 JSON 但不遵循模式,以及结构化输出(type: json_、strict: true),后者遵循;OpenAI 建议尽可能使用第二种(来源:developers.openai.com,2026 年 11 月 2 日查阅)。这些是 OpenAI 自己的 API 选项。在依赖 response_format 与另一个端点之前,检查 CheapTokens 文档;上面的提取和重试适用于普通聊天补全,不需要特殊参数。更多关于请求侧选项的内容见 从 LLM API 获取有效 JSON:response_format 和重试。
在发布解析器之前,检查四件事:在解析文本之前读取 finish_reason,只有一次重试(并且第二次失败会记录项目 id),代码在解析后检查预期的键存在,以及 max_tokens 为你期望的最长 JSON 留出空间。
下次 json.loads 抛出时,先打印 exc.pos 和 finish_reason。这两个数字通常在你读一行回复之前就告诉你发生了什么。


