Вирішення проблемПосібник
json.JSONDecodeError у відповіді LLM: витягніть JSON у Python
json.loads зазнає невдачі на відповіді моделі? Прочитайте exc.pos і finish_reason, щоб знайти причину, потім витягніть JSON за допомогою raw_decode і повторіть спробу один раз.
На цій сторінці
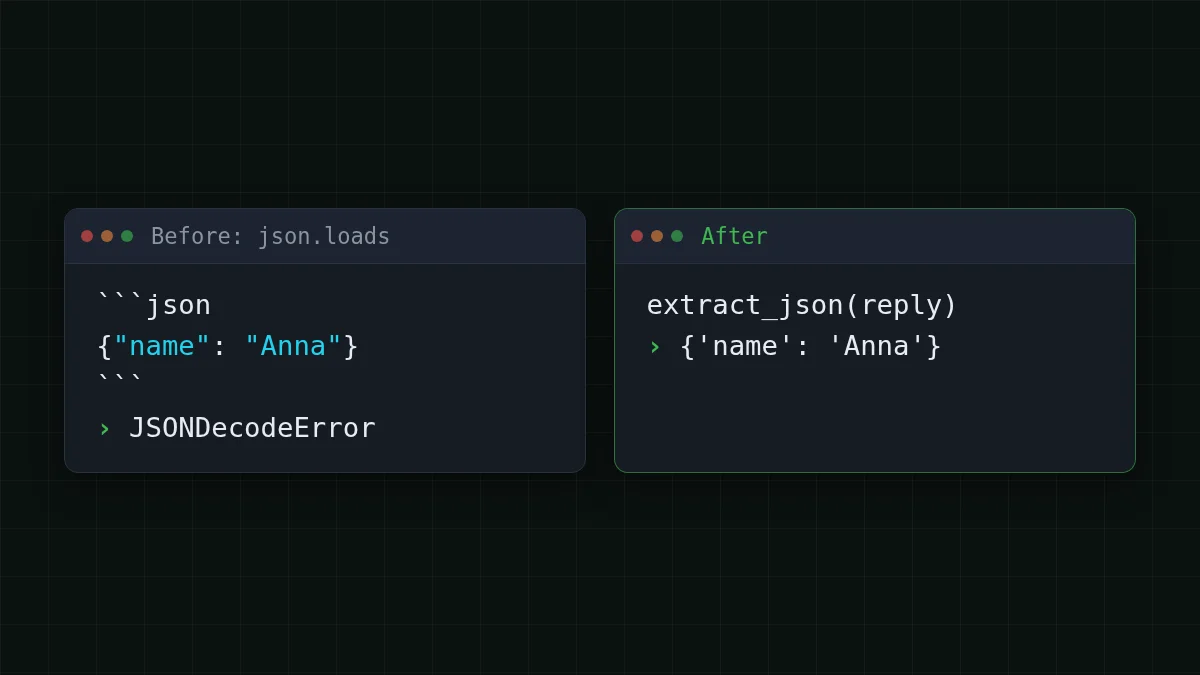
Ваш скрипт просить модель повернути JSON, викликає json. і падає з json.. Зазвичай модель таки відповіла: вона загорнула JSON у ```json fence, put a line of chat in front of it, or ran into max_tokens halfway through. Look at exc.pos and finish_reason to tell which one it is, pull the object out with JSONDecoder., і повторіть спробу один раз, якщо нічого не вдалося зберегти.
Три способи, якими відповідь ламає json.loads#
Документація Python для json (документація Python 3.15, перевірено 2 листопада 2026 року) каже, що JSONDecodeError є підкласом ValueError з атрибутами msg, doc, pos, lineno та colno. Той, що має значення тут, — це pos: індекс у рядку, де парсинг зазнав невдачі.
Припустімо, скрипт витягує поля з листів клієнтів і просить {"name": .. Ці три рядки — відповіді, які його ламають. Вставте їх у оболонку Python:
import json

fenced = '```json\n{"name": "Anna", "age": 31}\n```'
chatty = 'Sure! Here is the JSON:\n{"name": "Anna", "age": 31}'
cut = '{"name": "Anna", "age": 31'

for reply in (fenced, chatty, cut):
    try:
        json.loads(reply)
    except json.JSONDecodeError as exc:
        print(exc.pos, len(reply))
Перші два зазнають невдачі на pos 0: парсер подивився на найперший символ, зворотний апостроф або S, і здався. Третій зазнає невдачі в кінці рядка (pos дорівнює len(reply)): усе, що він прочитав, було гаразд, а потім текст закінчився. Ця різниця — ваш діагноз. Позиція 0 означає, що JSON, ймовірно, там, просто загорнутий. Позиція в кінці означає, що відповідь обірвалася рано.
Обірвані відповіді: перевіряйте finish_reason перед парсингом#
Відповідь, що обірвалася посередині, — це не проблема парсингу, а проблема довжини. API каже вам: вибір має finish_reason, і "length" означає, що відповідь була обрізана через max_tokens (повна історія в AI answer cut off? Fix finish_reason "length" and max_tokens). Подивіться на це першим, перед будь-яким витягуванням.
Є підступна пастка, якщо пропустити цей крок. Сканер, який шукає перший придатний для парсингу {, може підхопити повний внутрішній об'єкт із напівзавершеного зовнішнього, і ваш скрипт продовжить роботу з неправильними даними без помилки. Спробуйте:
Спробуйте саміСпробуйте: що повертає функція "знайти перший об'єкт" для цієї обірваної відповіді?Показати відповідь
Візьміть '{"user": {"name": "Anna"}, "age": 31'. Зовнішній об'єкт ніколи не закривається, але внутрішній {"name": "Anna"} є повним, тому екстрактор нижче повертає {'name': 'Anna'}. Без винятку, неправильний результат. Ось чому перевірка finish_reason відбувається перед витягуванням.
Виправлення для справжнього обриву — більше місця: збільште max_tokens. DeepSeek-V4-Flash дозволяє до 32 768 вихідних токенів на відповідь, GLM-5.3-Flash — до 8 192, тож довгий список JSON має більше місця на першому. Подробиці про моделі на сторінці моделей CheapTokens.
Витягніть JSON із тексту#
Для огорож і балаканини стандартна бібліотека вже має інструмент. Згідно з тією ж сторінкою Python, JSONDecoder. декодує JSON-документ із рядка, що починається з нього, і повертає об'єкт плюс індекс, де документ закінчився. Документація каже, що його можна використовувати на рядку з зайвими даними в кінці. Йому потрібно, щоб документ починався з першого символу, тому спершу відріжте провідний текст: знайдіть {, спробуйте декодувати звідти і перейдіть до наступного {, якщо це не вдасться.
import json

def extract_json(text):
    """Return the first JSON object found in text, or raise ValueError."""
    decoder = json.JSONDecoder()
    for i, ch in enumerate(text):
        if ch == '{':
            try:
                obj, _end = decoder.raw_decode(text[i:])
                return obj
            except json.JSONDecodeError:
                continue
    raise ValueError('no JSON object in the reply')
Він обробляє огорожу (провідний ```json is skipped because it is not a {), the sentence before the object, and text after the closing brace. Expecting a list? Look for '[' instead. Don't look for both: a stray [1] у реченні на кшталт "див. примітку [1]" є валідним JSON і переміг би.
Дві речі, яких він навмисно не робить. Він ніколи не редагує текст (жодного regex, що видаляє зворотні апострофи, жодного вгадування відсутніх дужок), тож ви не можете перетворити зламану відповідь на валідні, але неправильні дані. І він гучно зазнає невдачі, коли немає чого знайти, що й потрібно для повторної спроби нижче.
Повторіть спробу один раз із суворішим запитом#
Якщо відповідь була обрізана або взагалі не містить об'єкта, запитайте знову. Один раз, а не в нескінченному циклі. У разі обриву дайте другій спробі більше місця; інакше скажіть прямо, що ви хочете. Це використовує OpenAI Python SDK проти базової URL-адреси CheapTokens (https:/) і повний ідентифікатор моделі з документації; ключ лежить у змінній середовища.
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
STRICT = '\n\nReply with one JSON object only. No text before or after it, no code fence.'

def ask_json(prompt, max_tokens=800):
    content = prompt
    for attempt in (1, 2):
        resp = client.chat.completions.create(
            model=MODEL,
            messages=[{'role': 'user', 'content': content}],
            max_tokens=max_tokens,
        )
        choice = resp.choices[0]
        if choice.finish_reason == 'length':
            max_tokens *= 2          # cut off: more room next time
        else:
            try:
                return extract_json(choice.message.content or '')
            except ValueError:
                pass                 # no object: try the stricter prompt
        content = prompt + STRICT
    raise ValueError('no valid JSON after one retry')
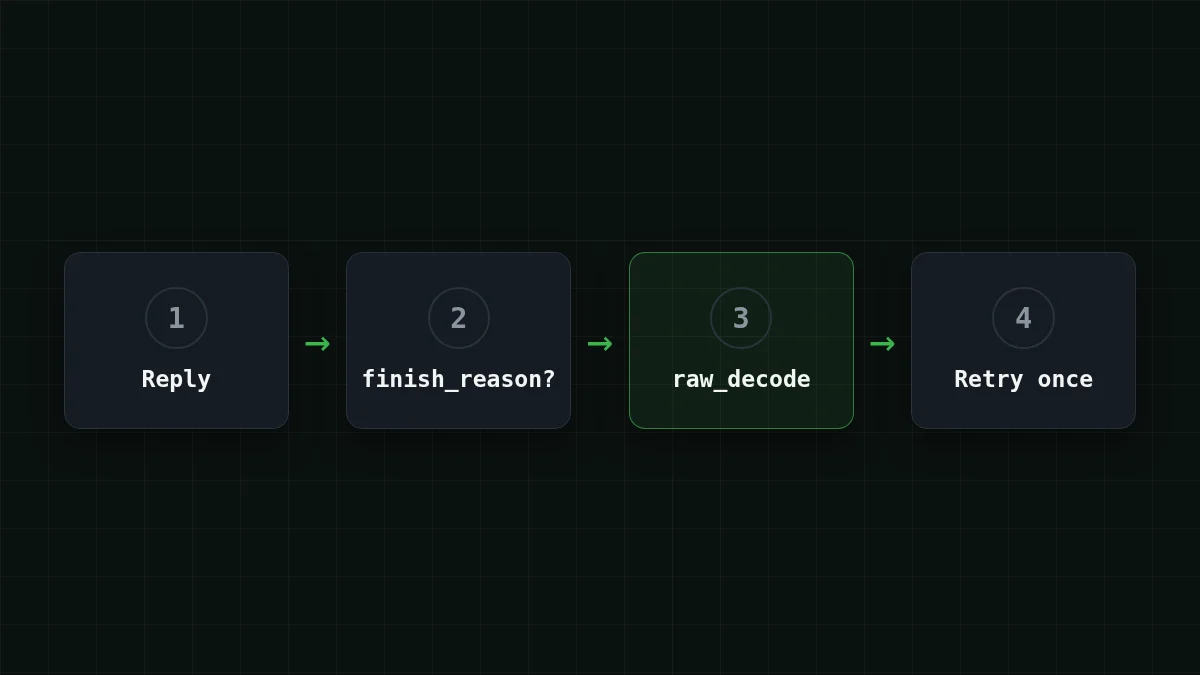
Порядок — це суть: спочатку finish_reason, потім витягування, і лише потім повторна спроба. Викличте помилку після другої спроби, щоб пакетне завдання могло залогувати цей елемент і рухатися далі.
Скільки коштує повторна спроба, легко оцінити. Припустімо, запит на 1 200 вхідних токенів і 300 вихідних токенів (припущення, використовуйте свої цифри): $0.000048 на DeepSeek-V4-Flash або $0.000036 на GLM-5.3-Flash. Якщо 30 із 1 000 запитів потребують другої спроби, додатковий рахунок — 30 × цей запит, $0.0014 на DeepSeek-V4-Flash. Ціни живі, вони беруться з поточного прайс-листа.
Розставте по порядку
Розставте кроки виправлення по порядку
Перетягніть елементи або скористайтеся стрілками
- Перевірте finish_reason: зупиніться тут, якщо там length
- Знайдіть першу { і відріжте текст перед нею
- Декодуйте за допомогою raw_decode і ігноруйте те, що йде далі
- Якщо нічого не знайдено, повторіть спробу один раз із суворішим запитом
Який симптом, яке виправлення#
Кроки вище вкладаються в голову, доки не з'явиться наступна дивна помилка. Це те саме, що довідник: знайдіть те, що бачите на екрані, і прочитайте виправлення.
Оберіть свій випадок
Виберіть те, що бачите
Виберіть варіант, щоб побачити відповідь
json.loads зазнає невдачі на pos 0
Відповідь починається з огорожі або речення. Проженіть її через extract_json; повторна спроба не потрібна.
pos у кінці рядка
Відповідь обірвалася рано. Перевірте finish_reason: якщо це length, збільште max_tokens і запитайте знову.
Помилка десь посередині
Модель сама написала зламаний JSON (пропущена кома, кінцева кома, неекранована лапка). Не виправляйте його: повторіть спробу один раз із суворішим запитом і залогуйте відповідь, якщо вона знову зазнає невдачі.
json.loads працює, але ключ відсутній
Парсинг гаразд, вміст — ні. Перелічіть точні ключі в запиті і перевірте їх у коді після парсингу.
Чи може API примусити до валідного JSON?#
Іноді. Посібник OpenAI зі структурованих виводів документує два режими: режим JSON (type: json_), який повертає валідний JSON, але не дотримується схеми, і Structured Outputs (type: json_, strict: true), який дотримується; OpenAI рекомендує другий, де можливо (джерело: developers.openai.com, перевірено 2 листопада 2026 року). Це власні опції API OpenAI. Перш ніж покладатися на response_format з іншою кінцевою точкою, перевірте документацію CheapTokens; витягування і повторна спроба вище працюють із звичайними chat completions і не потребують спеціального параметра. Більше про опції на стороні запиту в Get valid JSON from an LLM API: response_format and retries.
Перш ніж випустити парсер, перевірте чотири речі: finish_reason читається перед парсингом тексту, є лише одна повторна спроба (і друга невдача логується з ідентифікатором елемента), код перевіряє, що очікувані ключі існують після парсингу, і max_tokens залишає місце для найдовшого JSON, який ви очікуєте.
Наступного разу, коли json.loads викине, надрукуйте exc.pos і finish_reason першими. Ці два числа зазвичай кажуть вам, що сталося, ще до того, як ви прочитаєте рядок відповіді.


