json.JSONDecodeError su una risposta LLM: estrai il JSON in Python
json.loads fallisce su una risposta del modello? Leggi exc.pos e finish_reason per trovare la causa, poi estrai il JSON con raw_decode e riprova una volta.
In questa pagina
Il tuo script chiede al modello del JSON, chiama json. e muore con json.. Di solito il modello ha risposto: ha avvolto il JSON in un ```json fence, put a line of chat in front of it, or ran into max_tokens halfway through. Look at exc.pos and finish_reason to tell which one it is, pull the object out with JSONDecoder., e riprova una volta se non si riesce a salvare nulla.
Tre modi in cui una risposta rompe json.loads#
La documentazione di json di Python (documentazione di Python 3.15, consultata il 2 novembre 2026) dice che JSONDecodeError è una sottoclasse di ValueError con gli attributi msg, doc, pos, lineno e colno. Quello che conta qui è pos: l'indice nella stringa in cui il parsing è fallito.
Supponiamo che uno script estragga campi dalle email dei clienti e chieda {"name": .. Queste tre stringhe sono le risposte che lo rompono. Incollale in una shell Python:
import json

fenced = '```json\n{"name": "Anna", "age": 31}\n```'
chatty = 'Sure! Here is the JSON:\n{"name": "Anna", "age": 31}'
cut = '{"name": "Anna", "age": 31'

for reply in (fenced, chatty, cut):
    try:
        json.loads(reply)
    except json.JSONDecodeError as exc:
        print(exc.pos, len(reply))
Le prime due falliscono a pos 0: il parser ha guardato il primissimo carattere, un backtick o un S, e ha rinunciato. La terza fallisce alla fine della stringa (pos è uguale a len(reply)): tutto ciò che ha letto andava bene, poi il testo è finito. Questa differenza è la tua diagnosi. La posizione 0 significa che il JSON probabilmente c'è, è solo avvolto. La posizione alla fine significa che la risposta si è interrotta presto.
Risposte troncate: controlla finish_reason prima di fare il parsing#
Una risposta che si interrompe a metà non è un problema di parsing, è un problema di lunghezza. L'API te lo dice: la choice ha finish_reason, e "length" significa che la risposta è stata troncata da max_tokens (la storia completa è in Risposta AI troncata? Correggi finish_reason "length" e max_tokens). Guardalo per primo, prima di qualsiasi estrazione.
C'è una trappola insidiosa se salti questo passaggio. Uno scanner che cerca il primo { analizzabile può pescare un oggetto interno completo da uno esterno a metà, e il tuo script va avanti con i dati sbagliati e senza errori. Provalo:
Provalo tu stessoProvalo: cosa restituisce una funzione "trova il primo oggetto" per questa risposta troncata?Mostra risposta
Prendi '{"user": {"name": "Anna"}, "age": 31'. L'oggetto esterno non si chiude mai, ma l'interno {"name": "Anna"} è completo, quindi l'estrattore qui sotto restituisce {'name': 'Anna'}. Nessuna eccezione, risultato sbagliato. Ecco perché il controllo di finish_reason viene prima dell'estrazione.
La soluzione per un vero troncamento è più spazio: alza max_tokens. DeepSeek-V4-Flash consente fino a 32.768 token di output per risposta, GLM-5.3-Flash fino a 8.192, quindi una lunga lista JSON ha più spazio sul primo. I dettagli dei modelli sono su la pagina dei modelli CheapTokens.
Estrai il JSON dal testo#
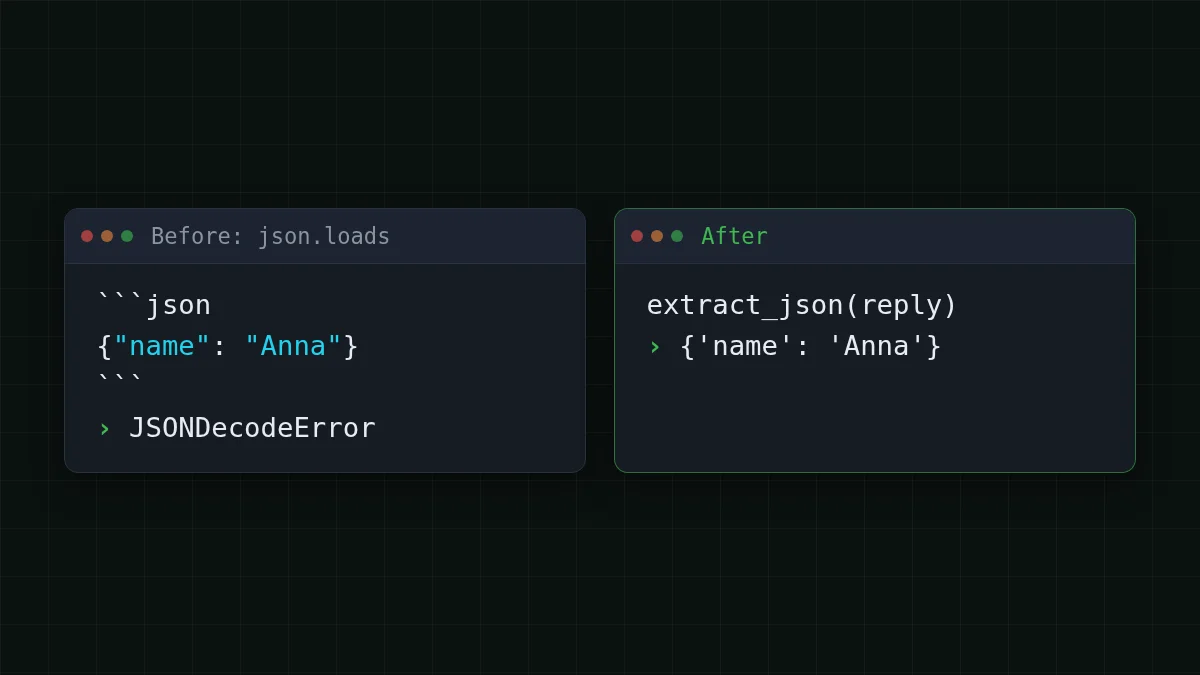
Per i fence e le chiacchiere, la libreria standard ha già lo strumento. Secondo la stessa pagina di Python, JSONDecoder. decodifica un documento JSON da una stringa che inizia con uno e restituisce l'oggetto più l'indice in cui il documento è terminato. La documentazione dice che può essere usato su una stringa con dati estranei alla fine. Richiede che il documento inizi dal primo carattere, quindi taglia prima il testo iniziale: cerca un {, prova a decodificare da lì e passa al { successivo se fallisce.
import json

def extract_json(text):
    """Return the first JSON object found in text, or raise ValueError."""
    decoder = json.JSONDecoder()
    for i, ch in enumerate(text):
        if ch == '{':
            try:
                obj, _end = decoder.raw_decode(text[i:])
                return obj
            except json.JSONDecodeError:
                continue
    raise ValueError('no JSON object in the reply')
Gestisce il fence (il ```json is skipped because it is not a {), the sentence before the object, and text after the closing brace. Expecting a list? Look for '[' instead. Don't look for both: a stray [1] in una frase come "vedi nota [1]" è JSON valido e vincerebbe.
Due cose che deliberatamente non fa. Non modifica mai il testo (niente regex che cancella i backtick, niente ipotesi sulle parentesi mancanti), quindi non puoi trasformare una risposta rotta in dati validi ma sbagliati. E fallisce in modo rumoroso quando non c'è nulla da trovare, che è ciò di cui ha bisogno il retry qui sotto.
Riprova una volta con un prompt più rigoroso#
Se la risposta è stata troncata o non contiene alcun oggetto, chiedi di nuovo. Una volta, non in un ciclo infinito. Su un troncamento, dai più spazio al secondo tentativo; altrimenti di' chiaramente cosa vuoi. Questo usa l'SDK Python di OpenAI contro la base URL di CheapTokens (https:/) e l'id completo del modello dalla documentazione; la chiave sta in una variabile d'ambiente.
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
STRICT = '\n\nReply with one JSON object only. No text before or after it, no code fence.'

def ask_json(prompt, max_tokens=800):
    content = prompt
    for attempt in (1, 2):
        resp = client.chat.completions.create(
            model=MODEL,
            messages=[{'role': 'user', 'content': content}],
            max_tokens=max_tokens,
        )
        choice = resp.choices[0]
        if choice.finish_reason == 'length':
            max_tokens *= 2          # cut off: more room next time
        else:
            try:
                return extract_json(choice.message.content or '')
            except ValueError:
                pass                 # no object: try the stricter prompt
        content = prompt + STRICT
    raise ValueError('no valid JSON after one retry')
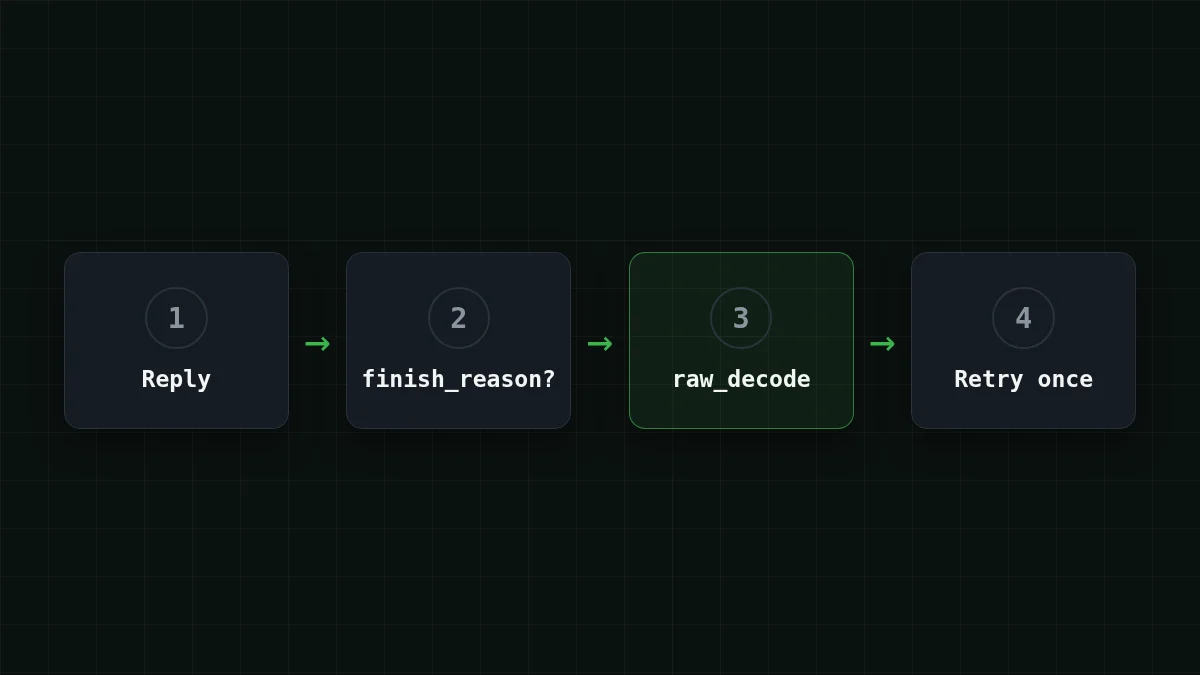
L'ordine è il punto: prima finish_reason, poi l'estrazione, e solo dopo un retry. Solleva l'errore dopo il secondo tentativo così un job batch può registrare quell'elemento e andare avanti.
Quanto costa un retry è facile da stimare. Supponi una richiesta di 1.200 token di input e 300 di output (un'ipotesi, usa i tuoi numeri): $0.000048 su DeepSeek-V4-Flash o $0.000036 su GLM-5.3-Flash. Se 30 richieste su 1.000 necessitano del secondo tentativo, il conto extra è 30 × quella richiesta, $0.0014 su DeepSeek-V4-Flash. I prezzi sono live, provengono dal listino prezzi attuale.
Metti in ordine
Metti in ordine i passaggi di riparazione
Trascina gli elementi o usa le frecce
- Controlla finish_reason: fermati qui se dice length
- Trova la prima { e taglia il testo prima di essa
- Decodifica con raw_decode e ignora ciò che segue
- Se non è stato trovato nulla, riprova una volta con il prompt più rigoroso
Quale sintomo, quale correzione#
I passaggi sopra stanno in testa fino al prossimo errore strano. Questa è la stessa cosa di una tabella di ricerca: trova ciò che vedi sullo schermo e leggi la correzione.
Scegli il tuo caso
Scegli ciò che vedi
Scegli un'opzione per vedere la risposta
json.loads fallisce a pos 0
La risposta inizia con un fence o una frase. Passala attraverso extract_json; un retry non serve.
pos è alla fine della stringa
La risposta si è interrotta presto. Controlla finish_reason: se è length, alza max_tokens e chiedi di nuovo.
L'errore è da qualche parte nel mezzo
Il modello ha scritto JSON rotto da solo (una virgola mancante, una virgola finale, una virgola non escapata). Non rattopparlo: riprova una volta con il prompt più rigoroso e registra la risposta se fallisce di nuovo.
json.loads funziona ma manca una chiave
Il parsing va bene, il contenuto no. Elenca le chiavi esatte nel prompt e controllale nel codice dopo il parsing.
L'API può forzare JSON valido?#
A volte. La guida agli structured outputs di OpenAI documenta due modalità: la modalità JSON (type: json_), che restituisce JSON valido ma non segue uno schema, e gli Structured Outputs (type: json_, strict: true), che lo fanno; OpenAI raccomanda la seconda dove possibile (fonte: developers.openai.com, consultata il 2 novembre 2026). Quelle sono le opzioni API di OpenAI. Prima di affidarti a response_format con un altro endpoint, controlla la documentazione di CheapTokens; l'estrazione e il retry sopra funzionano con normali chat completions e non richiedono parametri speciali. Altro sulle opzioni lato richiesta in Ottenere JSON valido da un'API LLM: response_format e retry.
Prima di rilasciare il parser, controlla quattro cose: finish_reason viene letto prima che il testo sia analizzato, c'è un solo retry (e il secondo fallimento è registrato con l'id dell'elemento), il codice verifica che le chiavi attese esistano dopo il parsing, e max_tokens lascia spazio al JSON più lungo che ti aspetti.
La prossima volta che json.loads lancia un'eccezione, stampa prima exc.pos e finish_reason. Quei due numeri di solito ti dicono cosa è successo prima che tu legga una riga della risposta.


