API e SDKGuida
Ottenere JSON valido da un'API LLM: response_format e nuovi tentativi
Una richiesta Python copiabile che restituisce JSON analizzabile, un wrapper json.loads che gestisce risposte vuote o troncate, e una checklist del perché il JSON si rompe.
In questa pagina
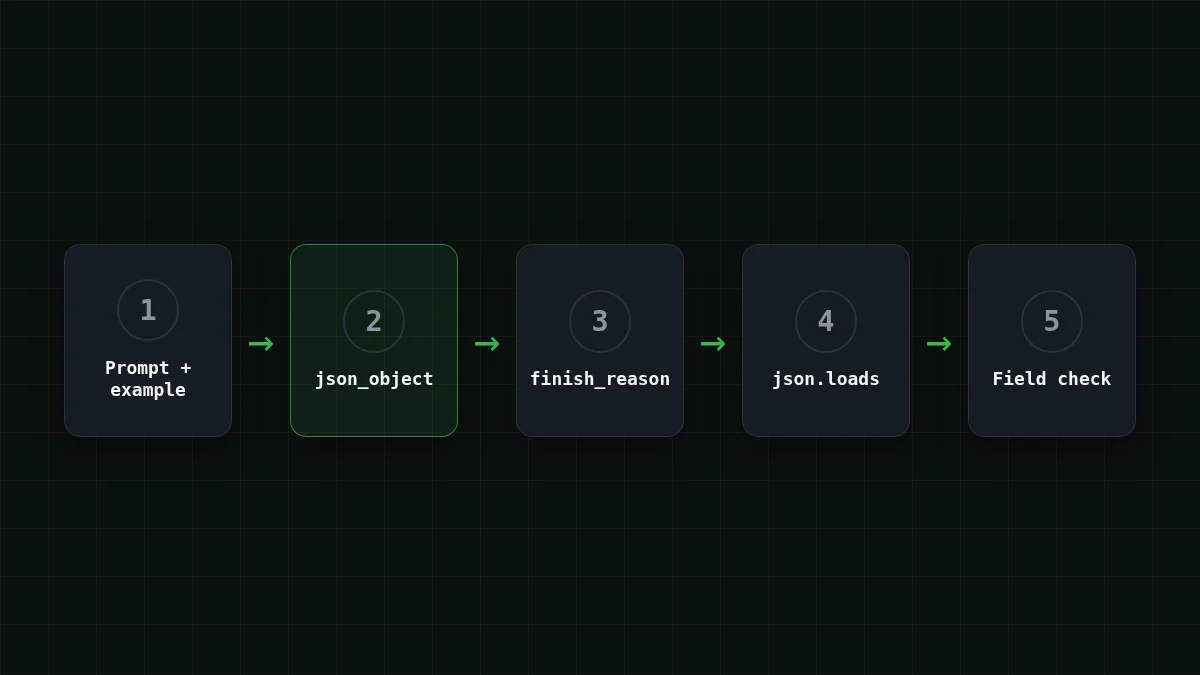
Per ottenere JSON da un modello di chat, fai tre cose: passa response_, inserisci la parola "json" e un esempio della struttura nel prompt, e imposta max_tokens abbastanza alto per l'intero oggetto. Poi non fidarti mai ciecamente della risposta: controlla che non sia vuota, verifica finish_reason, e solo allora chiama json.loads.
Questa è la versione breve. Il resto di questa guida è uno script completo per un compito molto comune: estrarre campi da un'email. Gli esempi usano l'URL di base https:/ e l'id del modello deepseek- (documentazione).
Il compito: un'email in ingresso, una riga in uscita#
Supponiamo che il tuo script legga email di supporto e debba trasformare ciascuna in un record: mittente, data, importo e cosa vuole il mittente. Prendi questa:
Ciao, sono Anna Petrova di Lumen Ltd. Il 14 ottobre ho pagato la fattura #3381 per 1.250 EUR, ma la ricevuta la mostra ancora come non pagata. Per favore risolvi entro venerdì.
Vuoi questo indietro, e nient'altro:
{"sender": "Anna Petrova", "date": "2026-10-14", "amount": 1250, "currency": "EUR", "action": "fix receipt status"}Un semplice prompt "estrai i campi" può restituirti una frase amichevole, un blocco di codice, o entrambi. Il tuo json.loads si blocca al primo backtick. Questo è il problema che response_format e un buon prompt risolvono insieme.
La stessa richiesta in Python e curl
Python
import json
import os

from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
MODEL = "deepseek-ai/DeepSeek-V4-Flash-0731"

SYSTEM = """Extract fields from the email and answer with json only.
Example of the json format:
{"sender": "Jane Roe", "date": "2026-01-31", "amount": 99.5, "currency": "USD", "action": "short phrase"}
Use null for a field that is not in the email."""

resp = client.chat.completions.create(
    model=MODEL,
    messages=[
        {"role": "system", "content": SYSTEM},
        {"role": "user", "content": email_text},
    ],
    response_format={"type": "json_object"},
    max_tokens=1000,
    temperature=0,
)
print(resp.choices[0].message.content)
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [
      {"role": "system", "content": "Extract fields from the email and answer with json only. Example: {\"sender\": \"Jane Roe\", \"amount\": 99.5}"},
      {"role": "user", "content": "Hi, this is Anna Petrova from Lumen Ltd. I paid invoice #3381 for 1,250 EUR..."}
    ],
    "response_format": {"type": "json_object"},
    "max_tokens": 1000
}'La documentazione dell'API DeepSeek per JSON Output (consultata il 27 ottobre 2026; la pagina non ha data di pubblicazione) indica le regole che questa richiesta segue: response_format impostato a json_object, la parola "json" da qualche parte nel prompt di sistema o utente, e un esempio della struttura target. Senza l'esempio il modello deve indovinare i nomi dei tuoi campi, e li indovinerà diversamente alla prossima email.
Perché l'esempio conta più del flag#
response_format chiede all'API di restituire un oggetto JSON. Non dice al modello quale oggetto. Immagina di dire a un collega "mandami un foglio di calcolo" senza specificare le colonne. Ottieni un foglio di calcolo, ma non il tuo.
L'esempio nel prompt è la riga di intestazione delle colonne. Due abitudini lo fanno funzionare meglio:
- Mostra la forma reale, inclusi i tipi:
1250è un numero,"2026-10-14"è una stringa in un formato data fisso. - Di' cosa fare quando un campo manca (
nullsopra). Altrimenti il modello inventa un valore per riempire il vuoto.
Tratta response_format come un forte suggerimento, non una garanzia. I modelli a volte restituiscono comunque una stringa vuota, o avvolgono l'oggetto in prosa. Ecco perché esiste la parte successiva.
Analizza in sicurezza: vuoto, troncato o semplicemente rotto#
Tre fallimenti si presentano in pratica, e ciascuno lascia una traccia diversa:
- Contenuto vuoto. La documentazione DeepSeek dice che la modalità JSON può occasionalmente restituire contenuto vuoto e suggerisce di riformulare il prompt. Dal tuo lato sembra che
message.contentsia""oNone, ejson.loads("")solleviExpecting value: line 1 column 1 (char 0). - Troncato.
max_tokensè esaurito a metà dell'oggetto.finish_reasonèlength, e il testo termina a metà stringa. Maggiori informazioni in perché una risposta AI si interrompe a metà frase. - Non JSON. Una frase prima dell'oggetto, o un blocco di codice attorno ad esso.
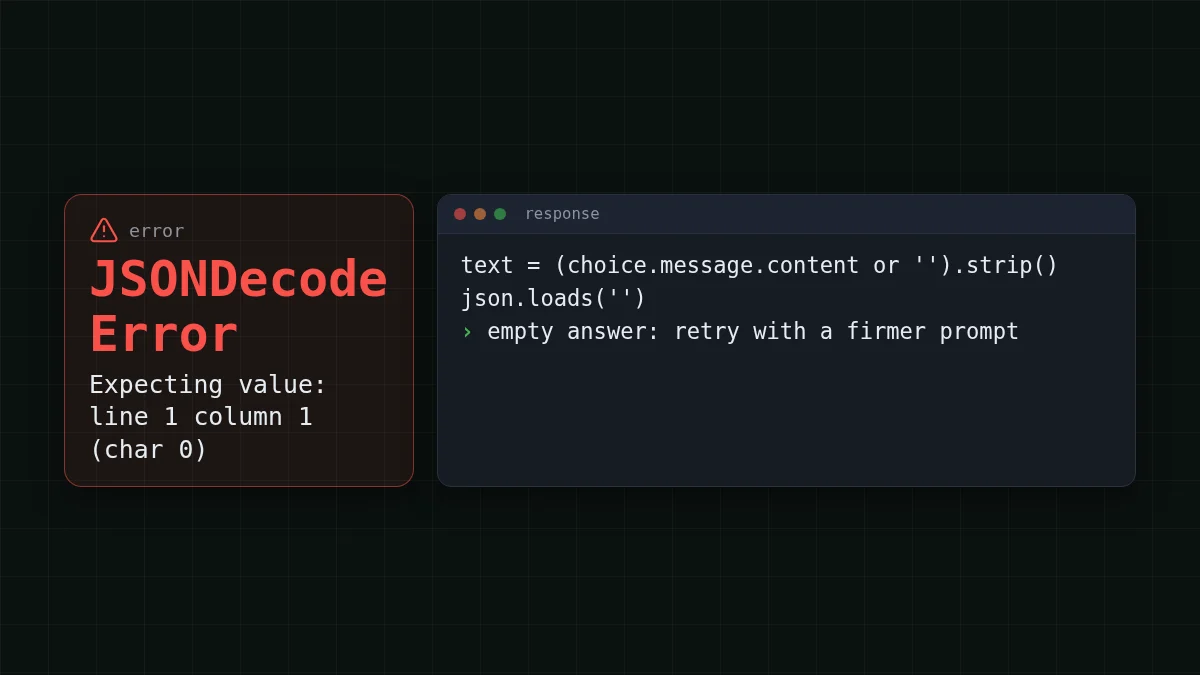
La soluzione per il primo e il terzo è un nuovo tentativo con un prompt più fermo. Per il secondo, un nuovo tentativo con lo stesso limite non cambia nulla, quindi il wrapper solleva un'eccezione e ti dice di aumentare max_tokens:
def ask_json(email_text: str, retries: int = 1) -> dict:
    user = email_text
    for attempt in range(retries + 1):
        resp = client.chat.completions.create(
            model=MODEL,
            messages=[
                {"role": "system", "content": SYSTEM},
                {"role": "user", "content": user},
            ],
            response_format={"type": "json_object"},
            max_tokens=1000,
            temperature=0,
        )
        choice = resp.choices[0]
        if choice.finish_reason == "length":
            raise ValueError("JSON cut off by max_tokens: raise the limit")
        text = (choice.message.content or "").strip()
        if text:
            try:
                return json.loads(text)
            except json.JSONDecodeError:
                pass
        # empty or not JSON: ask again, more firmly
        user = email_text + "\n\nReply with one json object only, in the format of the example."
    raise ValueError("no valid JSON after retry")
Un nuovo tentativo è sufficiente per uno script. Se fallisce due volte, registra l'id dell'email e vai avanti; una terza richiesta identica raramente aiuta.
Abbina le coppie
Quale sintomo indica quale causa?
Tocca un elemento a sinistra, poi il suo abbinamento
- finish_reason è "length"max_tokens è troppo piccolo per l'oggetto
- content è una stringa vuotala modalità JSON non ha restituito nulla; riformula il prompt e riprova
- JSONDecodeError su un carattere che è un backtickil modello ha avvolto il JSON in un blocco di codice
- I nomi dei campi differiscono tra le emailil prompt non ha un esempio della struttura
Controlla la forma, non solo la sintassi#
json.loads prova solo che il testo è JSON valido. Non prova che abbia i campi che hai richiesto. Aggiungi un controllo economico subito dopo l'analisi:
REQUIRED = {"sender", "date", "amount", "currency", "action"}

data = ask_json(email_text)
missing = REQUIRED - data.keys()
if missing:
    raise ValueError(f"missing fields: {sorted(missing)}")
Da qui il dict va direttamente in una riga di database o in un foglio di calcolo. Se hai bisogno che il modello chiami le tue funzioni invece di riempire un record fisso, quello è uno strumento diverso: vedi function calling in Python.
Quanto costa un batch di email#
Un'estrazione breve è il tipo economico di richiesta: qualche centinaio di token in ingresso, qualche decina in uscita. Supponi 1.000 email al giorno a circa 400 token di input (prompt, esempio ed email) e circa 80 token di output (il JSON). Su DeepSeek-V4-Flash sono $0.014 al giorno, e la tabella mostra lo stesso carico sugli altri modelli:
| Modello | Input $/1M | Output $/1M | Per richiesta | 1000 richieste | OpenRouter, 1000 richieste |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000011 | $0.0112 | $0.0226 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000014 | $0.014 | $0.0315 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000032 | $0.032 | $0.216 |
400 token di input e 80 token di output per richiesta. I prezzi per 1M di token sono attuali e cambiano insieme alle nostre tariffe; la colonna OpenRouter mostra i prezzi di riferimento per lo stesso carico di lavoro.
In totale, con input e output contati insieme, DeepSeek-V4-Flash risulta più economico del prezzo di riferimento di OpenRouter per questo carico. Consente anche fino a 32.768 token di output per risposta, quindi un lungo elenco di voci non verrà troncato come accadrebbe con un limite piccolo, e il prezzo è lo stesso a qualsiasi ora. GLM-5.3-Flash (zai-) è un'altra opzione allo stesso indirizzo API: fino a 8.192 token di output, che sono più che sufficienti per un record per email. I prezzi attuali sono sulla pagina dei prezzi; la pagina del modello DeepSeek ha i dettagli per il modello usato qui.
Verifica rapida#
Verifica rapida
Il tuo JSON è troncato a metà di una stringa. Cosa guardi per primo?
Mostra risposta
Risposta: finish_reason e max_tokens
Un oggetto troncato termina con finish_reason impostato a length. Il limite è stato raggiunto, quindi aumenta max_tokens; cambiare la temperatura o l'indirizzo non aiuta.
Se non hai ancora inviato una richiesta, inizia con la tua prima richiesta API, poi torna e sostituisci con il codice sopra.


