API y SDKGuía
Obtén JSON válido de una API de LLM: response_format y reintentos
Una solicitud de Python copiable que devuelve JSON parseable, un wrapper de json.loads que maneja respuestas vacías o cortadas, y una lista de verificación de por qué se rompe el JSON.
En esta página
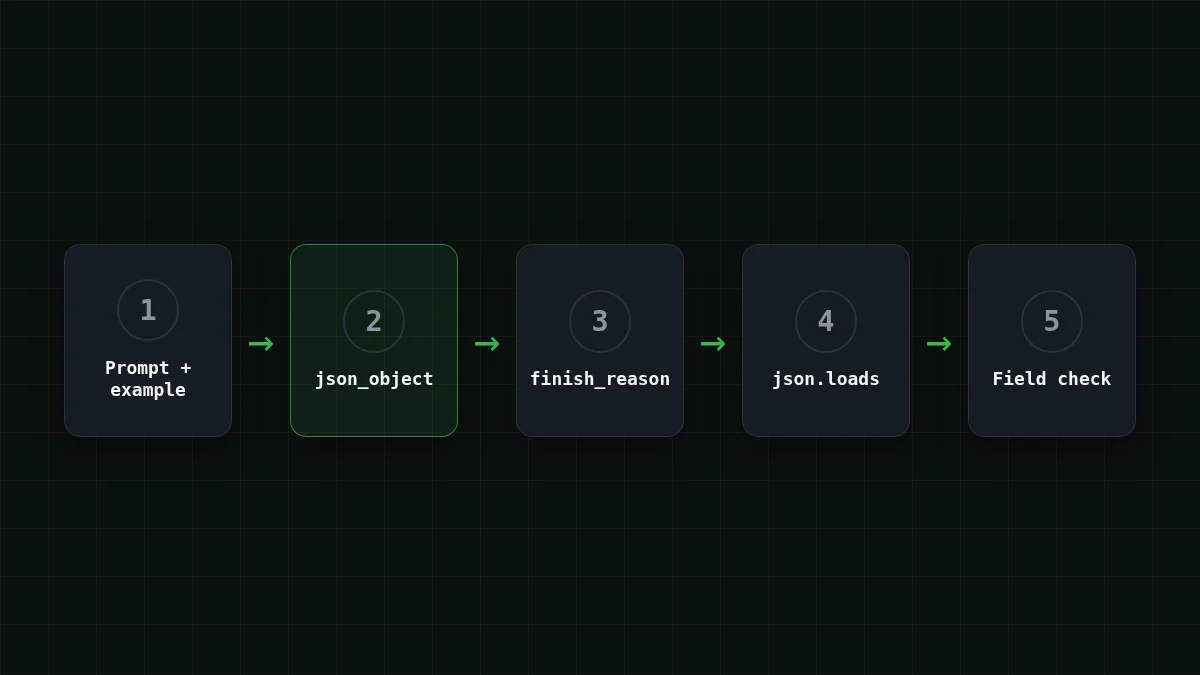
Para obtener JSON de un modelo de chat, haz tres cosas: pasa response_, pon la palabra "json" y un ejemplo de la estructura en el prompt, y establece max_tokens lo suficientemente alto para todo el objeto. Luego nunca confíes ciegamente en la respuesta: verifica que no esté vacía, comprueba finish_reason, y solo entonces llama a json.loads.
Esa es la versión corta. El resto de esta guía es un script completo para una tarea muy común: extraer campos de un correo electrónico. Los ejemplos usan la URL base https:/ y el id del modelo deepseek- (docs).
La tarea: un correo de entrada, una fila de salida#
Digamos que tu script lee correos de soporte y tiene que convertir cada uno en un registro: remitente, fecha, importe y lo que quiere el remitente. Toma este:
Hola, soy Anna Petrova de Lumen Ltd. El 14 de octubre pagué la factura #3381 por 1.250 EUR, pero el recibo todavía aparece como impago. Por favor, arréglalo antes del viernes.
Quieres esto de vuelta, y nada más:
{"sender": "Anna Petrova", "date": "2026-10-14", "amount": 1250, "currency": "EUR", "action": "fix receipt status"}Un prompt simple de "extrae los campos" puede devolverte una frase amigable, un bloque de código, o ambos. Tu json.loads se atasca con la primera comilla invertida. Ese es el problema que response_format y un buen prompt resuelven juntos.
La misma solicitud en Python y curl
Python
import json
import os

from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
MODEL = "deepseek-ai/DeepSeek-V4-Flash-0731"

SYSTEM = """Extract fields from the email and answer with json only.
Example of the json format:
{"sender": "Jane Roe", "date": "2026-01-31", "amount": 99.5, "currency": "USD", "action": "short phrase"}
Use null for a field that is not in the email."""

resp = client.chat.completions.create(
    model=MODEL,
    messages=[
        {"role": "system", "content": SYSTEM},
        {"role": "user", "content": email_text},
    ],
    response_format={"type": "json_object"},
    max_tokens=1000,
    temperature=0,
)
print(resp.choices[0].message.content)
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [
      {"role": "system", "content": "Extract fields from the email and answer with json only. Example: {\"sender\": \"Jane Roe\", \"amount\": 99.5}"},
      {"role": "user", "content": "Hi, this is Anna Petrova from Lumen Ltd. I paid invoice #3381 for 1,250 EUR..."}
    ],
    "response_format": {"type": "json_object"},
    "max_tokens": 1000
}'La referencia de la API de DeepSeek para JSON Output (consultada el 27 de octubre de 2026; la página no tiene fecha de publicación) establece las reglas que sigue esta solicitud: response_format establecido en json_object, la palabra "json" en algún lugar del prompt del sistema o del usuario, y un ejemplo de la estructura objetivo. Sin el ejemplo, el modelo tiene que adivinar los nombres de tus campos, y adivinará de forma diferente en el próximo correo.
Por qué el ejemplo importa más que el flag#
response_format pide a la API que devuelva un objeto JSON. No le dice al modelo qué objeto. Piensa en ello como decirle a un colega "envíame una hoja de cálculo" sin decir qué columnas. Obtienes una hoja de cálculo, pero no la tuya.
El ejemplo en el prompt es la fila de encabezados de columnas. Dos hábitos hacen que funcione mejor:
- Muestra la forma real, incluidos los tipos:
1250es un número,"2026-10-14"es una cadena en un formato de fecha fijo. - Di qué hacer cuando falta un campo (
nullarriba). De lo contrario, el modelo inventa un valor para llenar el vacío.
Trata response_format como una sugerencia fuerte, no como una garantía. Los modelos a veces todavía devuelven una cadena vacía, o envuelven el objeto en prosa. Por eso existe la siguiente parte.
Parseo seguro: vacío, cortado o simplemente roto#
Tres fallos aparecen en la práctica, y cada uno deja una huella diferente:
- Contenido vacío. Los docs de DeepSeek dicen que el modo JSON puede ocasionalmente devolver contenido vacío y sugieren reformular el prompt. De tu lado se ve como
message.contentsiendo""oNone, yjson.loads("")lanzandoExpecting value: line 1 column 1 (char 0). - Cortado.
max_tokensse agotó en medio del objeto.finish_reasoneslength, y el texto termina a mitad de cadena. Más sobre esto en por qué una respuesta de IA se detiene a mitad de frase. - No es JSON. Una frase antes del objeto, o un bloque de código alrededor de él.
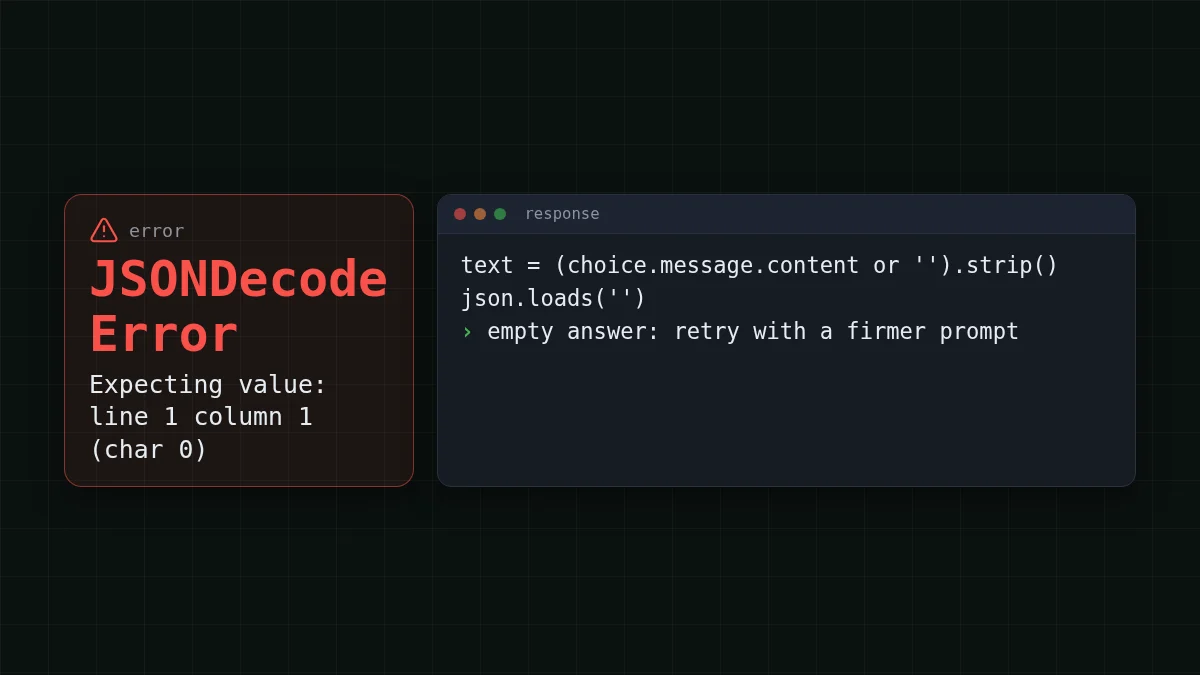
La solución para el primero y el tercero es un reintento con un prompt más firme. Para el segundo, un reintento con el mismo límite no cambia nada, así que el wrapper lanza una excepción y te dice que aumentes max_tokens:
def ask_json(email_text: str, retries: int = 1) -> dict:
    user = email_text
    for attempt in range(retries + 1):
        resp = client.chat.completions.create(
            model=MODEL,
            messages=[
                {"role": "system", "content": SYSTEM},
                {"role": "user", "content": user},
            ],
            response_format={"type": "json_object"},
            max_tokens=1000,
            temperature=0,
        )
        choice = resp.choices[0]
        if choice.finish_reason == "length":
            raise ValueError("JSON cut off by max_tokens: raise the limit")
        text = (choice.message.content or "").strip()
        if text:
            try:
                return json.loads(text)
            except json.JSONDecodeError:
                pass
        # empty or not JSON: ask again, more firmly
        user = email_text + "\n\nReply with one json object only, in the format of the example."
    raise ValueError("no valid JSON after retry")
Un reintento es suficiente para un script. Si falla dos veces, registra el id del correo y sigue adelante; una tercera solicitud idéntica rara vez ayuda.
Emparejar los pares
¿Qué síntoma apunta a qué causa?
Toca un elemento de la izquierda, luego su par
- finish_reason es "length"max_tokens es demasiado pequeño para el objeto
- content es una cadena vacíael modo JSON no devolvió nada; reformula el prompt y reintenta
- JSONDecodeError en un carácter que es una comilla invertidael modelo envolvió el JSON en un bloque de código
- Los nombres de los campos difieren entre correosel prompt no tiene un ejemplo de la estructura
Verifica la forma, no solo la sintaxis#
json.loads solo prueba que el texto es JSON válido. No prueba que tenga los campos que pediste. Añade una comprobación barata justo después del parseo:
REQUIRED = {"sender", "date", "amount", "currency", "action"}

data = ask_json(email_text)
missing = REQUIRED - data.keys()
if missing:
    raise ValueError(f"missing fields: {sorted(missing)}")
A partir de aquí el dict va directamente a una fila de base de datos o a una hoja de cálculo. Si necesitas que el modelo llame a tus propias funciones en lugar de rellenar un registro fijo, esa es otra herramienta: consulta function calling en Python.
Cuánto cuesta un lote de correos#
Una extracción corta es el tipo de solicitud barata: unos cientos de tokens de entrada, unas docenas de salida. Supón 1.000 correos al día con unos 400 tokens de entrada (prompt, ejemplo y correo) y unos 80 tokens de salida (el JSON). En DeepSeek-V4-Flash eso es $0.014 por día, y la tabla muestra la misma carga en los otros modelos:
| Modelo | Entrada $/1M | Salida $/1M | Por solicitud | 1000 solicitudes | OpenRouter, 1000 solicitudes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000011 | $0.0112 | $0.0226 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000014 | $0.014 | $0.0315 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000032 | $0.032 | $0.216 |
400 tokens de entrada y 80 tokens de salida por solicitud. Los precios por 1M de tokens son actuales y cambian junto con nuestras tarifas; la columna de OpenRouter muestra precios de referencia para la misma carga de trabajo.
En total, contando entrada y salida juntas, DeepSeek-V4-Flash sale más barato que el precio de referencia de OpenRouter para esta carga. También permite hasta 32.768 tokens de salida por respuesta, así que una lista larga de partidas no se cortará como lo haría con un límite pequeño, y el precio es el mismo a cualquier hora. GLM-5.3-Flash (zai-) es otra opción en la misma dirección de API: hasta 8.192 tokens de salida, que es más que suficiente para un registro por correo. Los precios actuales están en la página de precios; la página del modelo DeepSeek tiene los detalles del modelo usado aquí.
Comprobación rápida#
Verificación rápida
Tu JSON está cortado en medio de una cadena. ¿Qué miras primero?
Mostrar respuesta
Respuesta: finish_reason y max_tokens
Un objeto cortado termina con finish_reason establecido en length. Se alcanzó el límite, así que aumenta max_tokens; cambiar la temperatura o la dirección no ayuda.
Si aún no has enviado una solicitud, empieza con tu primera solicitud a la API, luego vuelve y sustituye el código de arriba.


