API e SDKGuia
Obtenha JSON válido de uma API de LLM: response_format e novas tentativas
Uma requisição Python copiável que retorna JSON parseável, um wrapper de json.loads que lida com respostas vazias ou cortadas, e uma checklist de por que o JSON quebra.
Nesta página
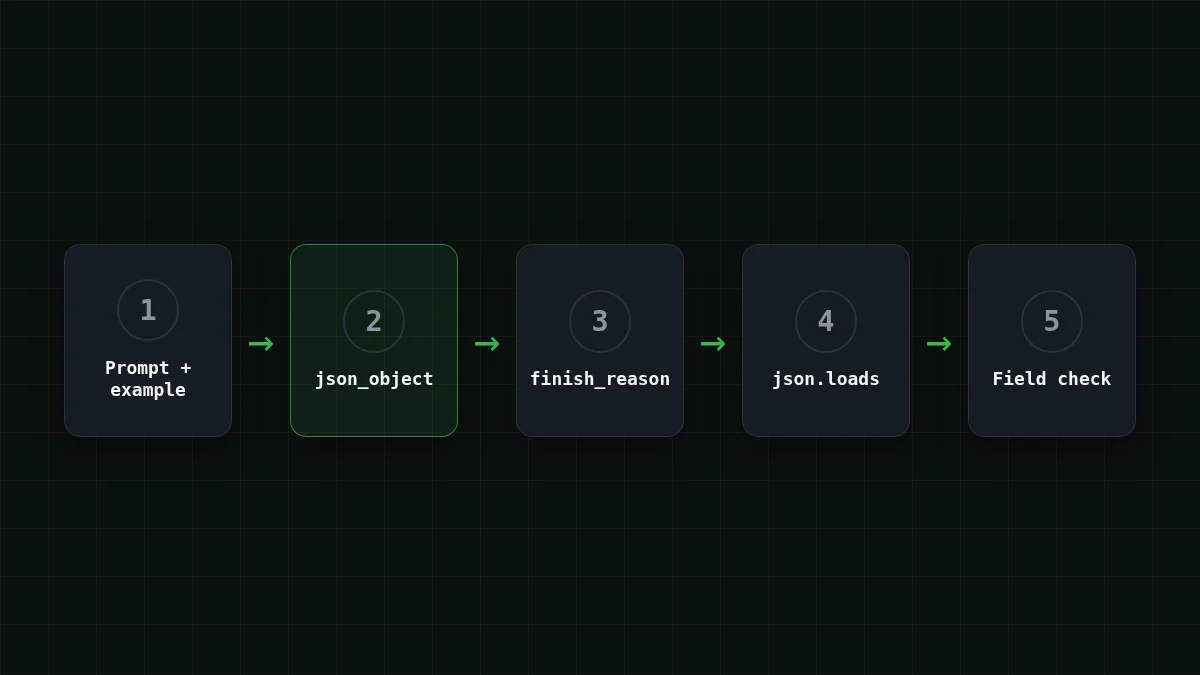
Para obter JSON de um modelo de chat, faça três coisas: passe response_, coloque a palavra "json" e um exemplo da estrutura no prompt, e defina max_tokens alto o suficiente para o objeto inteiro. Depois nunca confie na resposta cegamente: verifique se não está vazia, verifique finish_reason, e só então chame json.loads.
Essa é a versão curta. O resto deste guia é um script completo para uma tarefa muito comum: extrair campos de um e-mail. Os exemplos usam a URL base https:/ e o id do modelo deepseek- (docs).
A tarefa: entra um e-mail, sai uma linha#
Digamos que seu script lê e-mails de suporte e precisa transformar cada um em um registro: remetente, data, valor e o que o remetente quer. Pegue este:
Olá, aqui é Anna Petrova da Lumen Ltd. Em 14 de outubro paguei a fatura #3381 de 1.250 EUR, mas o recibo ainda mostra como não paga. Por favor, corrija antes de sexta-feira.
Você quer isto de volta, e nada mais:
{"sender": "Anna Petrova", "date": "2026-10-14", "amount": 1250, "currency": "EUR", "action": "fix receipt status"}Um prompt simples de "extraia os campos" pode te dar uma frase amigável, um bloco de código, ou ambos. Seu json.loads quebra na primeira crase. Esse é o problema que response_format e um bom prompt resolvem juntos.
A mesma requisição em Python e curl
Python
import json
import os

from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
MODEL = "deepseek-ai/DeepSeek-V4-Flash-0731"

SYSTEM = """Extract fields from the email and answer with json only.
Example of the json format:
{"sender": "Jane Roe", "date": "2026-01-31", "amount": 99.5, "currency": "USD", "action": "short phrase"}
Use null for a field that is not in the email."""

resp = client.chat.completions.create(
    model=MODEL,
    messages=[
        {"role": "system", "content": SYSTEM},
        {"role": "user", "content": email_text},
    ],
    response_format={"type": "json_object"},
    max_tokens=1000,
    temperature=0,
)
print(resp.choices[0].message.content)
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [
      {"role": "system", "content": "Extract fields from the email and answer with json only. Example: {\"sender\": \"Jane Roe\", \"amount\": 99.5}"},
      {"role": "user", "content": "Hi, this is Anna Petrova from Lumen Ltd. I paid invoice #3381 for 1,250 EUR..."}
    ],
    "response_format": {"type": "json_object"},
    "max_tokens": 1000
}'A referência da API DeepSeek para JSON Output (verificada em 27 de outubro de 2026; a página não tem data de publicação) declara as regras que esta requisição segue: response_format definido como json_object, a palavra "json" em algum lugar no prompt de sistema ou de usuário, e um exemplo da estrutura alvo. Sem o exemplo, o modelo precisa adivinhar os nomes dos seus campos, e vai adivinhar de forma diferente no próximo e-mail.
Por que o exemplo importa mais que a flag#
response_format pede à API que retorne um objeto JSON. Não diz ao modelo qual objeto. Pense nisso como dizer a um colega "me manda uma planilha" sem dizer quais colunas. Você recebe uma planilha, só não a sua.
O exemplo no prompt é a linha de cabeçalho das colunas. Dois hábitos fazem isso funcionar melhor:
- Mostre a forma real, incluindo os tipos:
1250é um número,"2026-10-14"é uma string em um formato de data fixo. - Diga o que fazer quando um campo estiver faltando (
nullacima). Caso contrário, o modelo inventa um valor para preencher a lacuna.
Trate response_format como uma dica forte, não uma garantia. Os modelos às vezes ainda retornam uma string vazia, ou envolvem o objeto em texto corrido. É por isso que a próxima parte existe.
Faça o parse com segurança: vazio, cortado ou simplesmente quebrado#
Três falhas aparecem na prática, e cada uma deixa um rastro diferente:
- Conteúdo vazio. A documentação da DeepSeek diz que o modo JSON pode ocasionalmente retornar conteúdo vazio e sugere reformular o prompt. Do seu lado, isso aparece como
message.contentsendo""ouNone, ejson.loads("")levantandoExpecting value: line 1 column 1 (char 0). - Cortado.
max_tokensacabou no meio do objeto.finish_reasonélength, e o texto termina no meio de uma string. Mais sobre isso em por que uma resposta de IA para no meio da frase. - Não é JSON. Uma frase antes do objeto, ou uma cerca em volta dele.
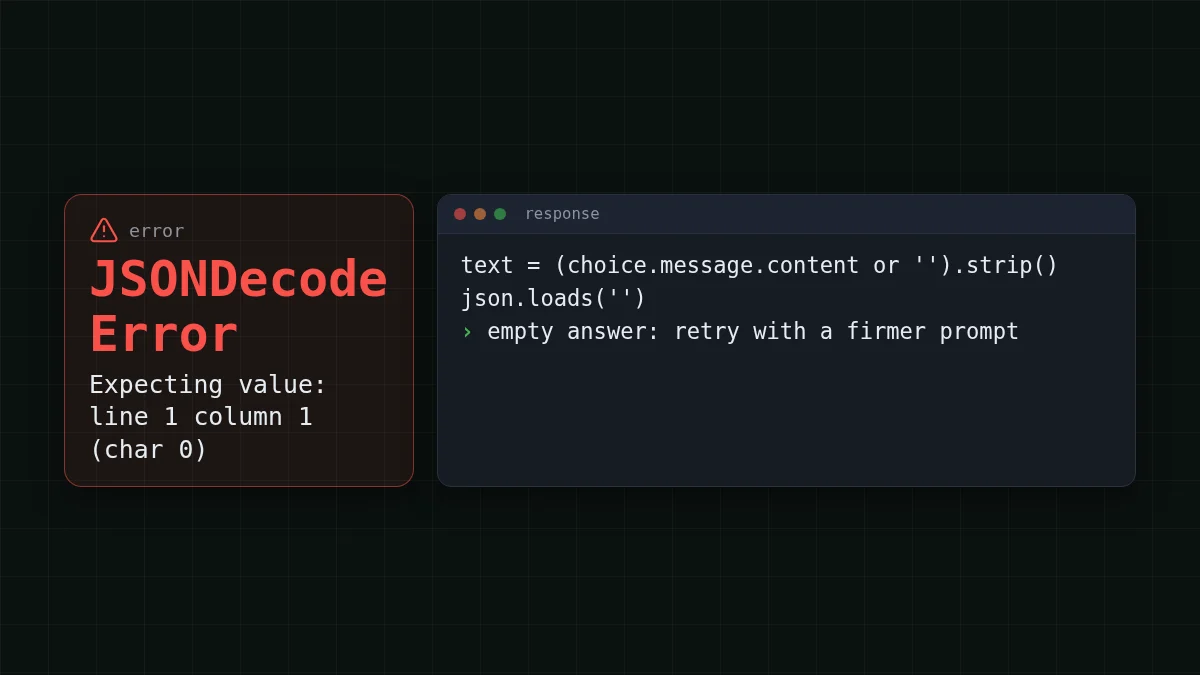
A correção para o primeiro e o terceiro é uma nova tentativa com um prompt mais firme. Para o segundo, uma nova tentativa com o mesmo limite não muda nada, então o wrapper levanta uma exceção e te diz para aumentar max_tokens:
def ask_json(email_text: str, retries: int = 1) -> dict:
    user = email_text
    for attempt in range(retries + 1):
        resp = client.chat.completions.create(
            model=MODEL,
            messages=[
                {"role": "system", "content": SYSTEM},
                {"role": "user", "content": user},
            ],
            response_format={"type": "json_object"},
            max_tokens=1000,
            temperature=0,
        )
        choice = resp.choices[0]
        if choice.finish_reason == "length":
            raise ValueError("JSON cut off by max_tokens: raise the limit")
        text = (choice.message.content or "").strip()
        if text:
            try:
                return json.loads(text)
            except json.JSONDecodeError:
                pass
        # empty or not JSON: ask again, more firmly
        user = email_text + "\n\nReply with one json object only, in the format of the example."
    raise ValueError("no valid JSON after retry")
Uma nova tentativa é suficiente para um script. Se falhar duas vezes, registre o id do e-mail e siga em frente; uma terceira requisição idêntica raramente ajuda.
Emparelhar os pares
Qual sintoma aponta para qual causa?
Toque num item à esquerda, depois no seu par
- finish_reason é "length"max_tokens é pequeno demais para o objeto
- content é uma string vaziao modo JSON não retornou nada; reformule o prompt e tente de novo
- JSONDecodeError em um caractere que é uma craseo modelo envolveu o JSON em uma cerca de código
- Os nomes dos campos diferem entre e-mailso prompt não tem exemplo da estrutura
Verifique a forma, não só a sintaxe#
json.loads só prova que o texto é JSON válido. Não prova que ele tem os campos que você pediu. Adicione uma verificação barata logo após o parse:
REQUIRED = {"sender", "date", "amount", "currency", "action"}

data = ask_json(email_text)
missing = REQUIRED - data.keys()
if missing:
    raise ValueError(f"missing fields: {sorted(missing)}")
A partir daqui o dict vai direto para uma linha de banco de dados ou uma planilha. Se você precisa que o modelo chame suas próprias funções em vez de preencher um registro fixo, essa é outra ferramenta: veja function calling em Python.
Quanto custa um lote de e-mails#
Uma extração curta é o tipo barato de requisição: algumas centenas de tokens na entrada, algumas dezenas na saída. Suponha 1.000 e-mails por dia a cerca de 400 tokens de entrada (prompt, exemplo e e-mail) e cerca de 80 tokens de saída (o JSON). No DeepSeek-V4-Flash isso dá $0.014 por dia, e a tabela mostra a mesma carga nos outros modelos:
| Modelo | Entrada $/1M | Saída $/1M | Por solicitação | 1.000 solicitações | OpenRouter, 1.000 solicitações |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000011 | $0.0112 | $0.0226 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000014 | $0.014 | $0.0315 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000032 | $0.032 | $0.216 |
400 tokens de entrada e 80 tokens de saída por solicitação. Os preços por 1M de tokens são atuais e mudam junto com nossas tarifas; a coluna OpenRouter mostra preços de referência para a mesma carga de trabalho.
No total, com entrada e saída contadas juntas, o DeepSeek-V4-Flash sai mais barato que o preço de referência do OpenRouter para essa carga. Ele também permite até 32.768 tokens de saída por resposta, então uma lista longa de itens não será cortada como seria com um limite pequeno, e o preço é o mesmo em qualquer horário. O GLM-5.3-Flash (zai-) é outra opção no mesmo endereço de API: até 8.192 tokens de saída, o que é suficiente para um registro por e-mail. Os preços atuais estão na página de preços; a página do modelo DeepSeek tem os detalhes do modelo usado aqui.
Verificação rápida#
Verificação rápida
Seu JSON está cortado no meio de uma string. O que você olha primeiro?
Mostrar resposta
Resposta: finish_reason e max_tokens
Um objeto cortado termina com finish_reason definido como length. O limite foi atingido, então aumente max_tokens; mudar a temperatura ou o endereço não ajuda.
Se você ainda não enviou uma requisição, comece com sua primeira requisição à API, depois volte e troque pelo código acima.


