API & SDKAnleitung
Gültiges JSON von einer LLM-API erhalten: response_format und Retries
Eine kopierbare Python-Anfrage, die parsebares JSON zurückgibt, ein json.loads-Wrapper, der leere oder abgeschnittene Antworten behandelt, und eine Checkliste, warum JSON bricht.
Auf dieser Seite
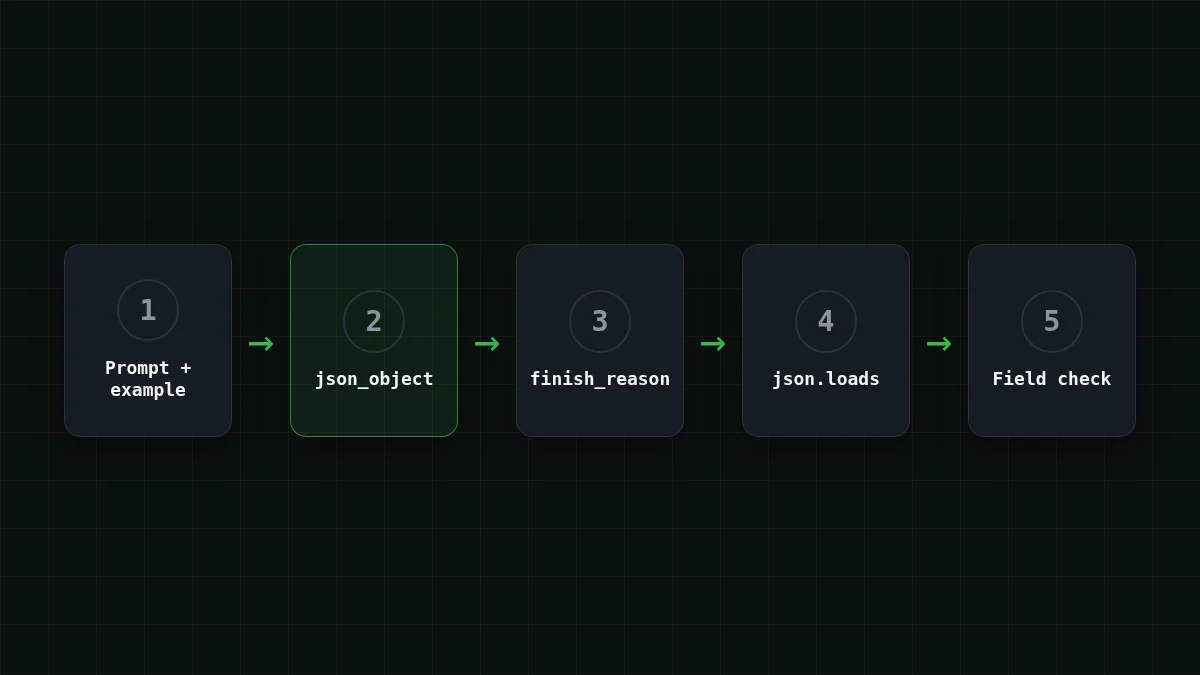
Um JSON aus einem Chat-Modell zu bekommen, sind drei Dinge nötig: response_ übergeben, das Wort "json" und ein Beispiel der Struktur in den Prompt schreiben und max_tokens hoch genug für das gesamte Objekt setzen. Dann niemals blind der Antwort vertrauen: prüfen, dass sie nicht leer ist, finish_reason prüfen und erst dann json.loads aufrufen.
Das ist die Kurzfassung. Der Rest dieses Leitfadens ist ein vollständiges Skript für eine sehr häufige Aufgabe: Felder aus einer E-Mail extrahieren. Die Beispiele verwenden die Basis-URL https:/ und die Modell-ID deepseek- (Dokumentation).
Die Aufgabe: eine E-Mail rein, eine Zeile raus#
Angenommen, dein Skript liest Support-E-Mails und muss jede in einen Datensatz umwandeln: Absender, Datum, Betrag und was der Absender möchte. Nimm diese hier:
Hallo, hier ist Anna Petrova von Lumen Ltd. Am 14. Oktober habe ich Rechnung #3381 über 1.250 EUR bezahlt, aber die Quittung zeigt sie immer noch als unbezahlt an. Bitte beheben Sie das vor Freitag.
Du möchtest genau das zurückbekommen und nichts anderes:
{"sender": "Anna Petrova", "date": "2026-10-14", "amount": 1250, "currency": "EUR", "action": "fix receipt status"}Ein einfacher Prompt wie "extrahiere die Felder" kann dir einen freundlichen Satz, einen Code-Fence oder beides liefern. Dein json.loads erstickt am ersten Backtick. Das ist das Problem, das response_format und ein guter Prompt gemeinsam lösen.
Dieselbe Anfrage in Python und curl
Python
import json
import os

from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
MODEL = "deepseek-ai/DeepSeek-V4-Flash-0731"

SYSTEM = """Extract fields from the email and answer with json only.
Example of the json format:
{"sender": "Jane Roe", "date": "2026-01-31", "amount": 99.5, "currency": "USD", "action": "short phrase"}
Use null for a field that is not in the email."""

resp = client.chat.completions.create(
    model=MODEL,
    messages=[
        {"role": "system", "content": SYSTEM},
        {"role": "user", "content": email_text},
    ],
    response_format={"type": "json_object"},
    max_tokens=1000,
    temperature=0,
)
print(resp.choices[0].message.content)
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [
      {"role": "system", "content": "Extract fields from the email and answer with json only. Example: {\"sender\": \"Jane Roe\", \"amount\": 99.5}"},
      {"role": "user", "content": "Hi, this is Anna Petrova from Lumen Ltd. I paid invoice #3381 for 1,250 EUR..."}
    ],
    "response_format": {"type": "json_object"},
    "max_tokens": 1000
}'Die DeepSeek-API-Referenz für JSON Output (geprüft am 27. Oktober 2026; die Seite hat kein Veröffentlichungsdatum) nennt die Regeln, denen diese Anfrage folgt: response_format auf json_object gesetzt, das Wort "json" irgendwo im System- oder Benutzer-Prompt und ein Beispiel der Zielstruktur. Ohne das Beispiel muss das Modell deine Feldnamen erraten, und es wird bei der nächsten E-Mail anders raten.
Warum das Beispiel wichtiger ist als das Flag#
response_format fordert die API auf, ein JSON-Objekt zurückzugeben. Es sagt dem Modell nicht, welches Objekt. Stell es dir vor, als würdest du einem Kollegen sagen: "Schick mir eine Tabelle", ohne zu sagen, welche Spalten. Du bekommst eine Tabelle, nur nicht deine.
Das Beispiel im Prompt ist die Kopfzeile der Spalten. Zwei Gewohnheiten machen es besser:
- Zeige die echte Form, einschließlich Typen:
1250ist eine Zahl,"2026-10-14"ist ein String in einem festen Datumsformat. - Sag, was zu tun ist, wenn ein Feld fehlt (
nulloben). Sonst erfindet das Modell einen Wert, um die Lücke zu füllen.
Behandle response_format als starken Hinweis, nicht als Garantie. Modelle geben manchmal trotzdem einen leeren String zurück oder verpacken das Objekt in Prosa. Deshalb gibt es den nächsten Teil.
Sicher parsen: leer, abgeschnitten oder einfach kaputt#
Drei Fehler treten in der Praxis auf, und jeder hinterlässt eine andere Spur:
- Leerer Inhalt. Die DeepSeek-Dokumentation sagt, dass der JSON-Modus gelegentlich leeren Inhalt zurückgeben kann und empfiehlt, den Prompt umzuformulieren. Auf deiner Seite sieht es so aus, dass
message.content""oderNoneist undjson.loads("")Expecting value: line 1 column 1 (char 0)auslöst. - Abgeschnitten.
max_tokensging mitten im Objekt aus.finish_reasonistlength, und der Text endet mitten im String. Mehr dazu in warum eine KI-Antwort mitten im Satz aufhört. - Kein JSON. Ein Satz vor dem Objekt oder ein Fence darum.
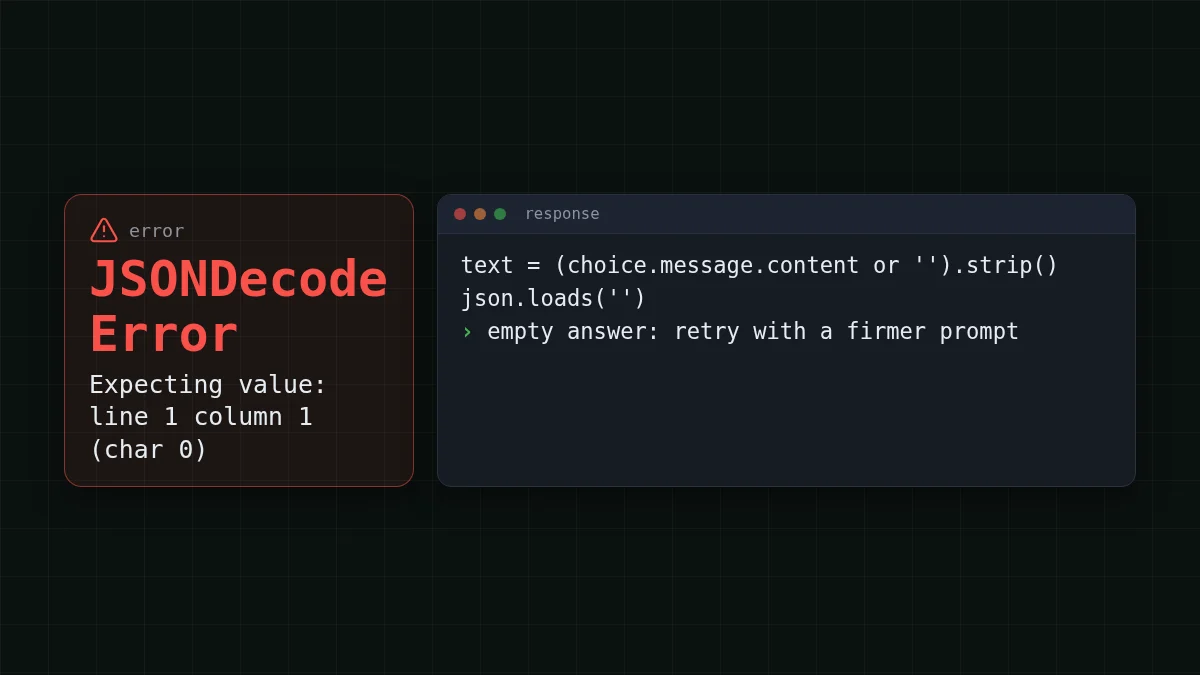
Die Lösung für den ersten und dritten Fall ist ein Retry mit einem festeren Prompt. Für den zweiten ändert ein Retry mit demselben Limit nichts, also wirft der Wrapper und sagt dir, du sollst max_tokens erhöhen:
def ask_json(email_text: str, retries: int = 1) -> dict:
    user = email_text
    for attempt in range(retries + 1):
        resp = client.chat.completions.create(
            model=MODEL,
            messages=[
                {"role": "system", "content": SYSTEM},
                {"role": "user", "content": user},
            ],
            response_format={"type": "json_object"},
            max_tokens=1000,
            temperature=0,
        )
        choice = resp.choices[0]
        if choice.finish_reason == "length":
            raise ValueError("JSON cut off by max_tokens: raise the limit")
        text = (choice.message.content or "").strip()
        if text:
            try:
                return json.loads(text)
            except json.JSONDecodeError:
                pass
        # empty or not JSON: ask again, more firmly
        user = email_text + "\n\nReply with one json object only, in the format of the example."
    raise ValueError("no valid JSON after retry")
Ein Retry reicht für ein Skript. Wenn es zweimal fehlschlägt, protokolliere die E-Mail-ID und mach weiter; eine dritte identische Anfrage hilft selten.
Paare zuordnen
Welches Symptom weist auf welche Ursache hin?
Tippe auf ein Element links, dann auf sein Paar
- finish_reason ist "length"max_tokens ist zu klein für das Objekt
- content ist ein leerer StringDer JSON-Modus gab nichts zurück; formuliere den Prompt um und versuche es erneut
- JSONDecodeError bei einem Zeichen, das ein Backtick istDas Modell hat das JSON in einen Code-Fence verpackt
- Feldnamen unterscheiden sich zwischen E-MailsDer Prompt enthält kein Beispiel der Struktur
Prüfe die Form, nicht nur die Syntax#
json.loads beweist nur, dass der Text gültiges JSON ist. Es beweist nicht, dass er die Felder enthält, die du angefordert hast. Füge direkt nach dem Parsen eine günstige Prüfung hinzu:
REQUIRED = {"sender", "date", "amount", "currency", "action"}

data = ask_json(email_text)
missing = REQUIRED - data.keys()
if missing:
    raise ValueError(f"missing fields: {sorted(missing)}")
Von hier aus geht das Dict direkt in eine Datenbankzeile oder eine Tabelle. Wenn du möchtest, dass das Modell deine eigenen Funktionen aufruft, anstatt einen festen Datensatz zu füllen, ist das ein anderes Werkzeug: siehe Function Calling in Python.
Was ein Stapel E-Mails kostet#
Eine kurze Extraktion ist die günstige Art von Anfrage: ein paar hundert Tokens rein, ein paar Dutzend raus. Angenommen, 1.000 E-Mails pro Tag bei etwa 400 Input-Tokens (Prompt, Beispiel und E-Mail) und etwa 80 Output-Tokens (das JSON). Bei DeepSeek-V4-Flash sind das $0.014 pro Tag, und die Tabelle zeigt dieselbe Last auf den anderen Modellen:
| Modell | Input $/1M | Output $/1M | Pro Anfrage | 1.000 Anfragen | OpenRouter, 1.000 Anfragen |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000011 | $0.0112 | $0.0226 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000014 | $0.014 | $0.0315 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000032 | $0.032 | $0.216 |
400 Input- und 80 Output-Tokens pro Anfrage. Die Preise pro 1 Mio. Tokens sind aktuell und ändern sich zusammen mit unseren Tarifen; die OpenRouter-Spalte zeigt Referenzpreise für dieselbe Arbeitslast.
Insgesamt, Input und Output zusammengerechnet, ist DeepSeek-V4-Flash für diese Last günstiger als der Referenzpreis von OpenRouter. Es erlaubt außerdem bis zu 32.768 Output-Tokens pro Antwort, sodass eine lange Liste von Positionen nicht abgeschnitten wird, wie es bei einem kleinen Limit der Fall wäre, und der Preis ist zu jeder Stunde gleich. GLM-5.3-Flash (zai-) ist eine weitere Option unter derselben API-Adresse: bis zu 8.192 Output-Tokens, was für einen Datensatz pro E-Mail reichlich ist. Aktuelle Preise findest du auf der Preisseite; die DeepSeek-Modellseite enthält die Details zum hier verwendeten Modell.
Kurze Prüfung#
Kurzer Check
Dein JSON ist mitten in einem String abgeschnitten. Was schaust du dir zuerst an?
Antwort anzeigen
Antwort: finish_reason und max_tokens
Ein abgeschnittenes Objekt endet mit finish_reason auf length. Das Limit wurde erreicht, also erhöhe max_tokens; die Temperatur oder die Adresse zu ändern hilft nicht.
Wenn du noch keine Anfrage gesendet hast, beginne mit deiner ersten API-Anfrage und komm dann zurück und tausche den obigen Code ein.


