API i SDKPrzewodnik
Uzyskaj poprawny JSON z API LLM: response_format i ponowne próby
Kopiowalne żądanie w Pythonie, które zwraca parsowalny JSON, wrapper json.loads obsługujący puste lub ucięte odpowiedzi oraz lista kontrolna przyczyn psucia się JSON-a.
Na tej stronie
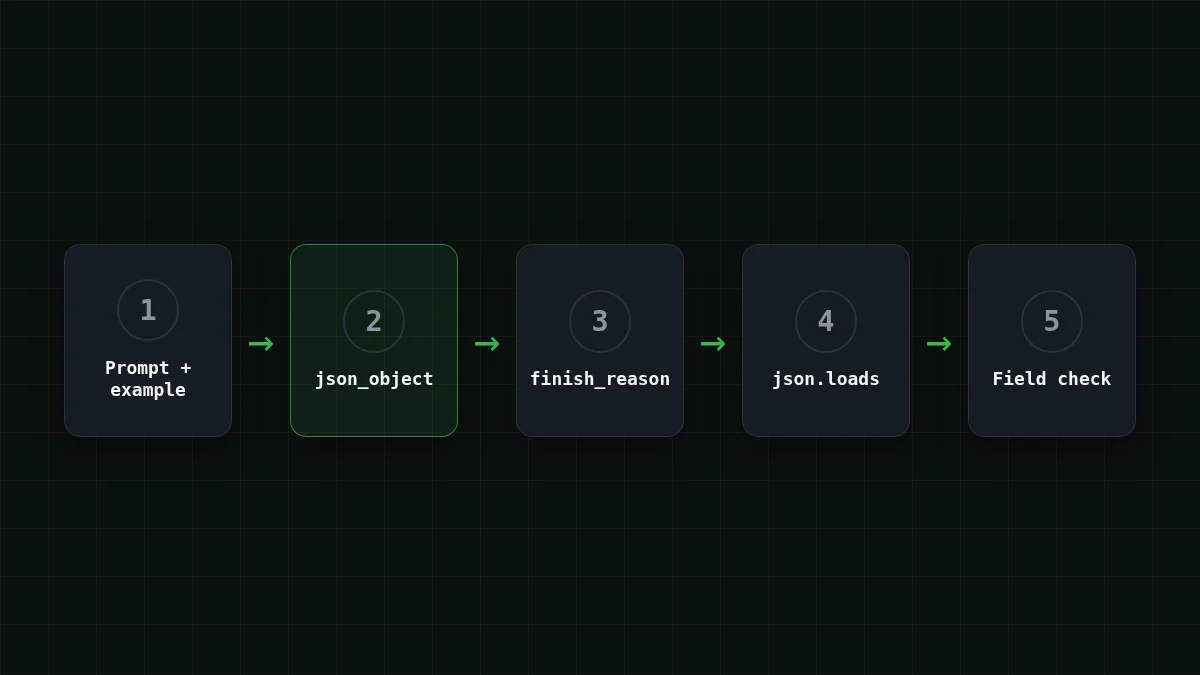
Aby uzyskać JSON z modelu czatu, zrób trzy rzeczy: przekaż response_, umieść słowo "json" i przykład struktury w prompcie oraz ustaw max_tokens wystarczająco wysoko dla całego obiektu. Potem nigdy nie ufaj odpowiedzi bezwarunkowo: sprawdź, czy nie jest pusta, sprawdź finish_reason, i dopiero wtedy wywołaj json.loads.
To krótka wersja. Reszta tego przewodnika to jeden kompletny skrypt do bardzo częstego zadania: wyciągania pól z e-maila. Przykłady używają bazowego URL-a https:/ i identyfikatora modelu deepseek- (dokumentacja).
Zadanie: e-mail na wejściu, wiersz na wyjściu#
Załóżmy, że twój skrypt czyta e-maile od wsparcia i musi zamienić każdy z nich w rekord: nadawca, data, kwota i czego chce nadawca. Weź ten:
Cześć, tu Anna Petrova z Lumen Ltd. 14 października zapłaciłam fakturę #3381 na 1 250 EUR, ale paragon nadal pokazuje ją jako nieopłaconą. Proszę o naprawienie tego przed piątkiem.
Chcesz dostać to z powrotem i nic więcej:
{"sender": "Anna Petrova", "date": "2026-10-14", "amount": 1250, "currency": "EUR", "action": "fix receipt status"}Zwykły prompt "wyciągnij pola" może zwrócić uprzejme zdanie, blok kodu albo jedno i drugie. Twój json.loads dławi się na pierwszym backticku. To problem, który response_format i dobry prompt rozwiązują razem.
To samo żądanie w Pythonie i curl
Python
import json
import os

from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
MODEL = "deepseek-ai/DeepSeek-V4-Flash-0731"

SYSTEM = """Extract fields from the email and answer with json only.
Example of the json format:
{"sender": "Jane Roe", "date": "2026-01-31", "amount": 99.5, "currency": "USD", "action": "short phrase"}
Use null for a field that is not in the email."""

resp = client.chat.completions.create(
    model=MODEL,
    messages=[
        {"role": "system", "content": SYSTEM},
        {"role": "user", "content": email_text},
    ],
    response_format={"type": "json_object"},
    max_tokens=1000,
    temperature=0,
)
print(resp.choices[0].message.content)
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [
      {"role": "system", "content": "Extract fields from the email and answer with json only. Example: {\"sender\": \"Jane Roe\", \"amount\": 99.5}"},
      {"role": "user", "content": "Hi, this is Anna Petrova from Lumen Ltd. I paid invoice #3381 for 1,250 EUR..."}
    ],
    "response_format": {"type": "json_object"},
    "max_tokens": 1000
}'Dokumentacja API DeepSeek dla JSON Output (sprawdzona 27 października 2026; strona nie ma daty publikacji) podaje zasady, których trzyma się to żądanie: response_format ustawione na json_object, słowo "json" gdzieś w prompcie systemowym lub użytkownika oraz przykład docelowej struktury. Bez przykładu model musi zgadywać nazwy twoich pól i zgadnie inaczej przy następnym e-mailu.
Dlaczego przykład ma większe znaczenie niż flaga#
response_format prosi API o zwrócenie obiektu JSON. Nie mówi modelowi którego obiektu. Pomyśl o tym jak o powiedzeniu koledze "wyślij mi arkusz kalkulacyjny" bez podania kolumn. Dostaniesz arkusz, tylko nie swój.
Przykład w prompcie to wiersz nagłówków kolumn. Dwa nawyki sprawiają, że działa lepiej:
- Pokazuj prawdziwy kształt, łącznie z typami:
1250to liczba,"2026-10-14"to ciąg znaków w ustalonym formacie daty. - Powiedz, co zrobić, gdy brakuje pola (
nullpowyżej). W przeciwnym razie model wymyśli wartość, żeby wypełnić lukę.
Traktuj response_format jako silną podpowiedź, nie gwarancję. Modele czasami nadal zwracają pusty ciąg znaków albo owijają obiekt w prozę. Dlatego istnieje następna część.
Parsuj bezpiecznie: puste, ucięte albo po prostu zepsute#
W praktyce pojawiają się trzy awarie, a każda zostawia inny ślad:
- Pusta treść. Dokumentacja DeepSeek mówi, że tryb JSON może czasami zwrócić pustą treść i sugeruje przeformułowanie promptu. Po twojej stronie wygląda to tak, że
message.contentjest""lubNone, ajson.loads("")zgłaszaExpecting value: line 1 column 1 (char 0). - Ucięte.
max_tokensskończyło się w środku obiektu.finish_reasontolength, a tekst kończy się w połowie ciągu znaków. Więcej na ten temat w dlaczego odpowiedź AI urywa się w połowie zdania. - To nie JSON. Zdanie przed obiektem albo blok kodu wokół niego.
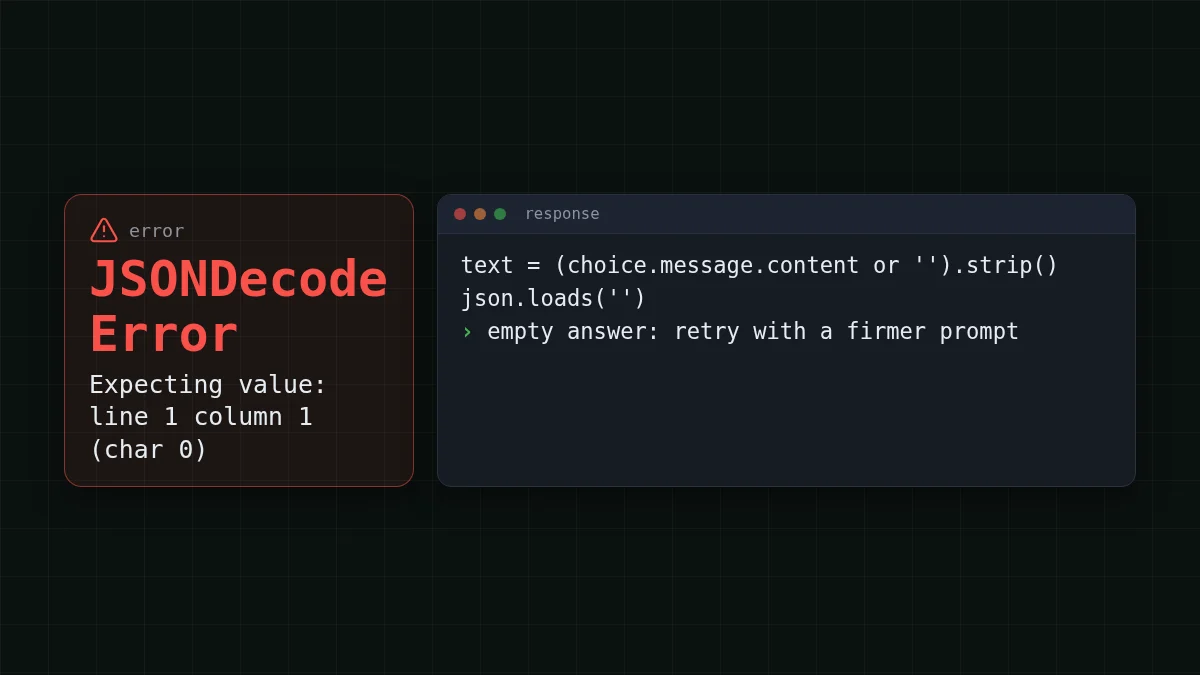
Poprawką na pierwszą i trzecią awarię jest ponowna próba z mocniejszym promptem. W przypadku drugiej ponowna próba z tym samym limitem nic nie zmienia, więc wrapper zgłasza wyjątek i mówi ci, żeby zwiększyć max_tokens:
def ask_json(email_text: str, retries: int = 1) -> dict:
    user = email_text
    for attempt in range(retries + 1):
        resp = client.chat.completions.create(
            model=MODEL,
            messages=[
                {"role": "system", "content": SYSTEM},
                {"role": "user", "content": user},
            ],
            response_format={"type": "json_object"},
            max_tokens=1000,
            temperature=0,
        )
        choice = resp.choices[0]
        if choice.finish_reason == "length":
            raise ValueError("JSON cut off by max_tokens: raise the limit")
        text = (choice.message.content or "").strip()
        if text:
            try:
                return json.loads(text)
            except json.JSONDecodeError:
                pass
        # empty or not JSON: ask again, more firmly
        user = email_text + "\n\nReply with one json object only, in the format of the example."
    raise ValueError("no valid JSON after retry")
Jedna ponowna próba wystarczy dla skryptu. Jeśli zawiedzie dwa razy, zaloguj identyfikator e-maila i idź dalej; trzecie identyczne żądanie rzadko pomaga.
Dopasuj pary
Który objaw wskazuje na którą przyczynę?
Dotknij element po lewej, a następnie jego parę
- finish_reason to "length"max_tokens jest za małe dla obiektu
- content to pusty ciąg znakówtryb JSON nic nie zwrócił; przeformułuj prompt i spróbuj ponownie
- JSONDecodeError na znaku, który jest backtickiemmodel owinął JSON w blok kodu
- Nazwy pól różnią się między e-mailamiprompt nie ma przykładu struktury
Sprawdź kształt, nie tylko składnię#
json.loads dowodzi tylko, że tekst jest poprawnym JSON-em. Nie dowodzi, że ma pola, o które prosiłeś. Dodaj tanie sprawdzenie zaraz po parsowaniu:
REQUIRED = {"sender", "date", "amount", "currency", "action"}

data = ask_json(email_text)
missing = REQUIRED - data.keys()
if missing:
    raise ValueError(f"missing fields: {sorted(missing)}")
Stąd słownik trafia prosto do wiersza w bazie danych albo arkusza kalkulacyjnego. Jeśli potrzebujesz, żeby model wywoływał twoje własne funkcje zamiast wypełniać stały rekord, to inne narzędzie: zobacz wywoływanie funkcji w Pythonie.
Ile kosztuje partia e-maili#
Krótkie wyciąganie to tani rodzaj żądania: kilkaset tokenów na wejściu, kilkadziesiąt na wyjściu. Załóż 1 000 e-maili dziennie przy około 400 tokenach wejściowych (prompt, przykład i e-mail) i około 80 tokenach wyjściowych (JSON). Na DeepSeek-V4-Flash to $0.014 dziennie, a tabela pokazuje to samo obciążenie na pozostałych modelach:
| Model | Wejście $/1M | Wyjście $/1M | Za żądanie | 1000 żądań | OpenRouter, 1000 żądań |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000011 | $0.0112 | $0.0226 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000014 | $0.014 | $0.0315 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000032 | $0.032 | $0.216 |
400 tokenów wejściowych i 80 tokenów wyjściowych na żądanie. Ceny za 1 mln tokenów są aktualne i zmieniają się wraz z naszymi taryfami; kolumna OpenRouter pokazuje ceny referencyjne dla tego samego obciążenia.
W sumie, licząc wejście i wyjście razem, DeepSeek-V4-Flash wypada taniej niż referencyjna cena OpenRouter dla tego obciążenia. Pozwala też na maksymalnie 32 768 tokenów wyjściowych na odpowiedź, więc długa lista pozycji nie zostanie ucięta tak, jak stałoby się to przy małym limicie, a cena jest taka sama o każdej porze. GLM-5.3-Flash (zai-) to kolejna opcja pod tym samym adresem API: do 8 192 tokenów wyjściowych, co w zupełności wystarczy na jeden rekord na e-mail. Aktualne ceny są na stronie z cennikiem; strona modelu DeepSeek zawiera szczegóły modelu użytego tutaj.
Szybkie sprawdzenie#
Szybkie sprawdzenie
Twój JSON jest ucięty w środku ciągu znaków. Na co patrzysz najpierw?
Pokaż odpowiedź
Odpowiedź: finish_reason i max_tokens
Ucięty obiekt kończy się z finish_reason ustawionym na length. Limit został osiągnięty, więc zwiększ max_tokens; zmiana temperatury lub adresu nie pomoże.
Jeśli jeszcze nie wysłałeś żądania, zacznij od twojego pierwszego żądania API, a potem wróć i wstaw powyższy kod.


