API & SDKGuide
Obtenir du JSON valide d'une API LLM : response_format et nouvelles tentatives
Une requête Python copiable qui renvoie du JSON parsable, un wrapper json.loads qui gère les réponses vides ou tronquées, et une liste de vérification des causes de rupture du JSON.
Sur cette page
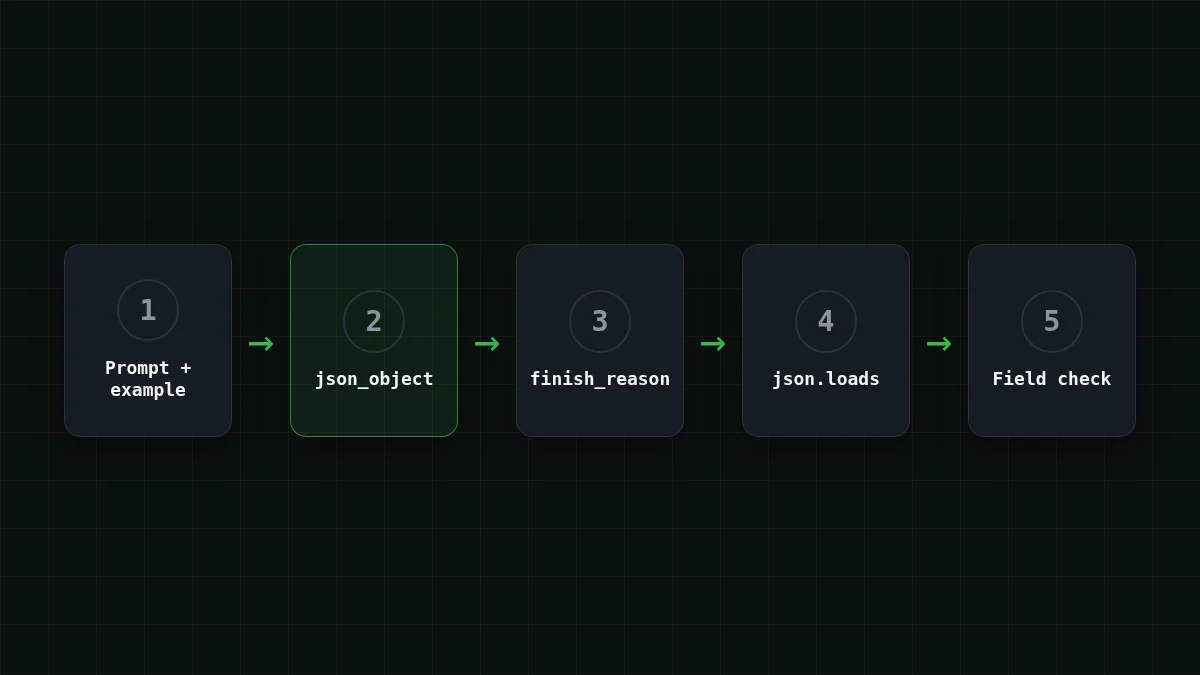
Pour obtenir du JSON d'un modèle de chat, faites trois choses : passez response_, mettez le mot « json » et un exemple de la structure dans le prompt, et réglez max_tokens suffisamment haut pour tout l'objet. Ensuite, ne faites jamais aveuglément confiance à la réponse : vérifiez qu'elle n'est pas vide, vérifiez finish_reason, et seulement alors appelez json.loads.
C'est la version courte. Le reste de ce guide est un script complet pour une tâche très courante : extraire des champs d'un e-mail. Les exemples utilisent l'URL de base https:/ et l'identifiant de modèle deepseek- (docs).
La tâche : un e-mail en entrée, une ligne en sortie#
Supposons que votre script lise des e-mails de support et doive transformer chacun en un enregistrement : expéditeur, date, montant et ce que l'expéditeur veut. Prenez celui-ci :
Bonjour, je suis Anna Petrova de Lumen Ltd. Le 14 octobre, j'ai payé la facture n° 3381 pour 1 250 EUR, mais le reçu indique toujours qu'elle est impayée. Merci de corriger cela avant vendredi.
Vous voulez ceci en retour, et rien d'autre :
{"sender": "Anna Petrova", "date": "2026-10-14", "amount": 1250, "currency": "EUR", "action": "fix receipt status"}Un simple prompt « extraire les champs » peut vous donner une phrase amicale, un bloc de code, ou les deux. Votre json.loads s'étouffe sur le premier backtick. C'est le problème que response_format et un bon prompt résolvent ensemble.
La même requête en Python et curl
Python
import json
import os

from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
MODEL = "deepseek-ai/DeepSeek-V4-Flash-0731"

SYSTEM = """Extract fields from the email and answer with json only.
Example of the json format:
{"sender": "Jane Roe", "date": "2026-01-31", "amount": 99.5, "currency": "USD", "action": "short phrase"}
Use null for a field that is not in the email."""

resp = client.chat.completions.create(
    model=MODEL,
    messages=[
        {"role": "system", "content": SYSTEM},
        {"role": "user", "content": email_text},
    ],
    response_format={"type": "json_object"},
    max_tokens=1000,
    temperature=0,
)
print(resp.choices[0].message.content)
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [
      {"role": "system", "content": "Extract fields from the email and answer with json only. Example: {\"sender\": \"Jane Roe\", \"amount\": 99.5}"},
      {"role": "user", "content": "Hi, this is Anna Petrova from Lumen Ltd. I paid invoice #3381 for 1,250 EUR..."}
    ],
    "response_format": {"type": "json_object"},
    "max_tokens": 1000
}'La référence de l'API DeepSeek pour la sortie JSON (consultée le 27 octobre 2026 ; la page n'a pas de date de publication) énonce les règles que cette requête suit : response_format défini sur json_object, le mot « json » quelque part dans le prompt système ou utilisateur, et un exemple de la structure cible. Sans l'exemple, le modèle doit deviner vos noms de champs, et il devinera différemment pour l'e-mail suivant.
Pourquoi l'exemple compte plus que le flag#
response_format demande à l'API de renvoyer un objet JSON. Cela ne dit pas au modèle quel objet. Voyez cela comme dire à un collègue « envoie-moi un tableur » sans préciser les colonnes. Vous obtenez un tableur, mais pas le vôtre.
L'exemple dans le prompt est la ligne d'en-tête des colonnes. Deux habitudes le rendent plus efficace :
- Montrez la forme réelle, y compris les types :
1250est un nombre,"2026-10-14"est une chaîne dans un format de date fixe. - Dites quoi faire quand un champ est manquant (
nullci-dessus). Sinon, le modèle invente une valeur pour combler le vide.
Considérez response_format comme un indice fort, pas une garantie. Les modèles renvoient parfois encore une chaîne vide, ou enveloppent l'objet dans de la prose. C'est pourquoi la partie suivante existe.
Parser en toute sécurité : vide, tronqué ou juste cassé#
Trois échecs se produisent en pratique, et chacun laisse une trace différente :
- Contenu vide. La documentation DeepSeek indique que le mode JSON peut parfois renvoyer un contenu vide et suggère de reformuler le prompt. De votre côté, cela ressemble à
message.contentqui est""ouNone, etjson.loads("")levantExpecting value: line 1 column 1 (char 0). - Tronqué.
max_tokenss'est épuisé au milieu de l'objet.finish_reasonestlength, et le texte se termine au milieu d'une chaîne. Plus d'informations dans pourquoi une réponse IA s'arrête au milieu d'une phrase. - Pas du JSON. Une phrase avant l'objet, ou un bloc de code autour.
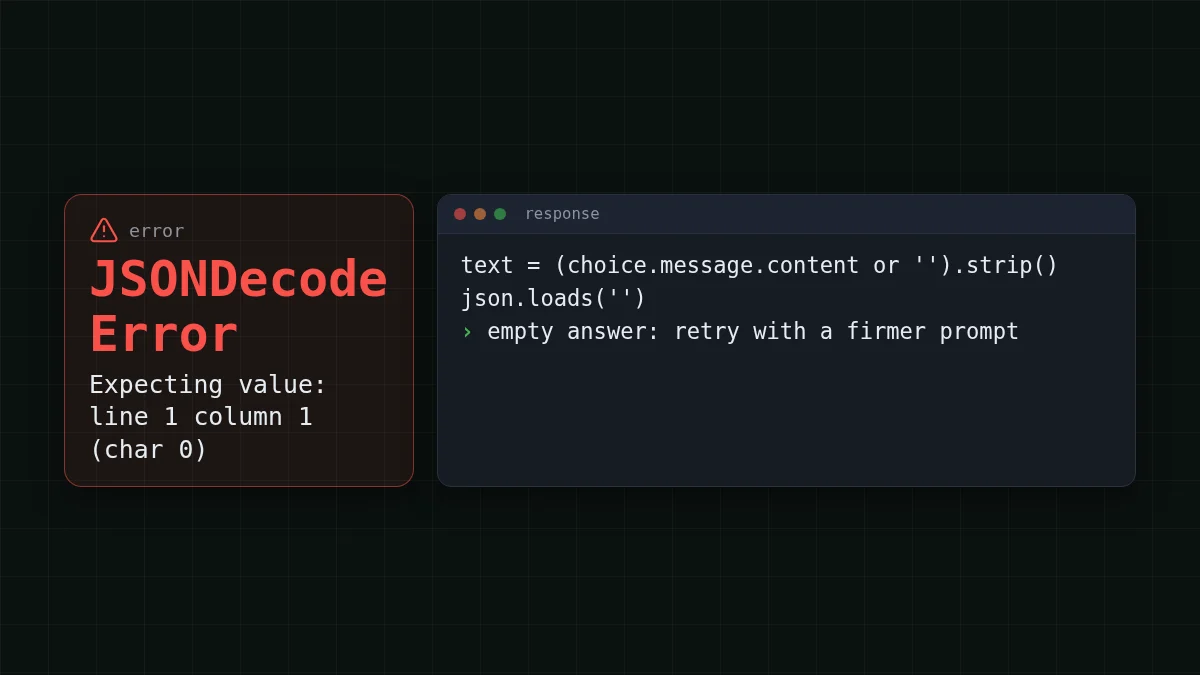
La solution pour le premier et le troisième est une nouvelle tentative avec un prompt plus ferme. Pour le deuxième, une nouvelle tentative avec la même limite ne change rien, donc le wrapper lève une exception et vous dit d'augmenter max_tokens :
def ask_json(email_text: str, retries: int = 1) -> dict:
    user = email_text
    for attempt in range(retries + 1):
        resp = client.chat.completions.create(
            model=MODEL,
            messages=[
                {"role": "system", "content": SYSTEM},
                {"role": "user", "content": user},
            ],
            response_format={"type": "json_object"},
            max_tokens=1000,
            temperature=0,
        )
        choice = resp.choices[0]
        if choice.finish_reason == "length":
            raise ValueError("JSON cut off by max_tokens: raise the limit")
        text = (choice.message.content or "").strip()
        if text:
            try:
                return json.loads(text)
            except json.JSONDecodeError:
                pass
        # empty or not JSON: ask again, more firmly
        user = email_text + "\n\nReply with one json object only, in the format of the example."
    raise ValueError("no valid JSON after retry")
Une nouvelle tentative suffit pour un script. Si cela échoue deux fois, enregistrez l'identifiant de l'e-mail et passez à autre chose ; une troisième requête identique aide rarement.
Associer les paires
Quel symptôme indique quelle cause ?
Touchez un élément à gauche, puis sa paire
- finish_reason est « length »max_tokens est trop petit pour l'objet
- content est une chaîne videle mode JSON n'a rien renvoyé ; reformulez le prompt et réessayez
- JSONDecodeError sur un caractère qui est un backtickle modèle a enveloppé le JSON dans un bloc de code
- Les noms de champs diffèrent entre les e-mailsle prompt n'a pas d'exemple de la structure
Vérifiez la forme, pas seulement la syntaxe#
json.loads prouve seulement que le texte est un JSON valide. Cela ne prouve pas qu'il contient les champs demandés. Ajoutez une vérification peu coûteuse juste après le parsing :
REQUIRED = {"sender", "date", "amount", "currency", "action"}

data = ask_json(email_text)
missing = REQUIRED - data.keys()
if missing:
    raise ValueError(f"missing fields: {sorted(missing)}")
À partir de là, le dict va directement dans une ligne de base de données ou un tableur. Si vous avez besoin que le modèle appelle vos propres fonctions au lieu de remplir un enregistrement fixe, c'est un autre outil : voir l'appel de fonctions en Python.
Combien coûte un lot d'e-mails#
Une extraction courte est le type de requête le moins cher : quelques centaines de tokens en entrée, quelques dizaines en sortie. Supposons 1 000 e-mails par jour à environ 400 tokens d'entrée (prompt, exemple et e-mail) et environ 80 tokens de sortie (le JSON). Sur DeepSeek-V4-Flash, cela fait $0.014 par jour, et le tableau montre la même charge sur les autres modèles :
| Modèle | Entrée $/1M | Sortie $/1M | Par requête | 1 000 requêtes | OpenRouter, 1 000 requêtes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000011 | $0.0112 | $0.0226 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000014 | $0.014 | $0.0315 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000032 | $0.032 | $0.216 |
400 tokens d'entrée et 80 tokens de sortie par requête. Les prix par million de tokens sont actuels et évoluent avec nos tarifs ; la colonne OpenRouter indique des prix de référence pour la même charge de travail.
Au total, en comptant l'entrée et la sortie ensemble, DeepSeek-V4-Flash revient moins cher que le prix de référence d'OpenRouter pour cette charge. Il autorise également jusqu'à 32 768 tokens de sortie par réponse, donc une longue liste d'articles ne sera pas tronquée comme elle le serait avec une petite limite, et le prix est le même à toute heure. GLM-5.3-Flash (zai-) est une autre option à la même adresse d'API : jusqu'à 8 192 tokens de sortie, ce qui est largement suffisant pour un enregistrement par e-mail. Les prix actuels sont sur la page de tarification ; la page du modèle DeepSeek contient les détails du modèle utilisé ici.
Vérification rapide#
Vérification rapide
Votre JSON est tronqué au milieu d'une chaîne. Que regardez-vous en premier ?
Afficher la réponse
Réponse: finish_reason et max_tokens
Un objet tronqué se termine avec finish_reason défini sur length. La limite a été atteinte, donc augmentez max_tokens ; changer la température ou l'adresse n'aide pas.
Si vous n'avez pas encore envoyé de requête, commencez par votre première requête API, puis revenez et remplacez par le code ci-dessus.


