การแก้ไขปัญหาคู่มือ
json.JSONDecodeError ในการตอบกลับของ LLM: ดึง JSON ใน Python
json.loads ล้มเหลวในการตอบกลับของโมเดล? อ่าน exc.pos และ finish_reason เพื่อหาสาเหตุ แล้วดึง JSON ด้วย raw_decode และลองอีกครั้งหนึ่งครั้ง
ในหน้านี้
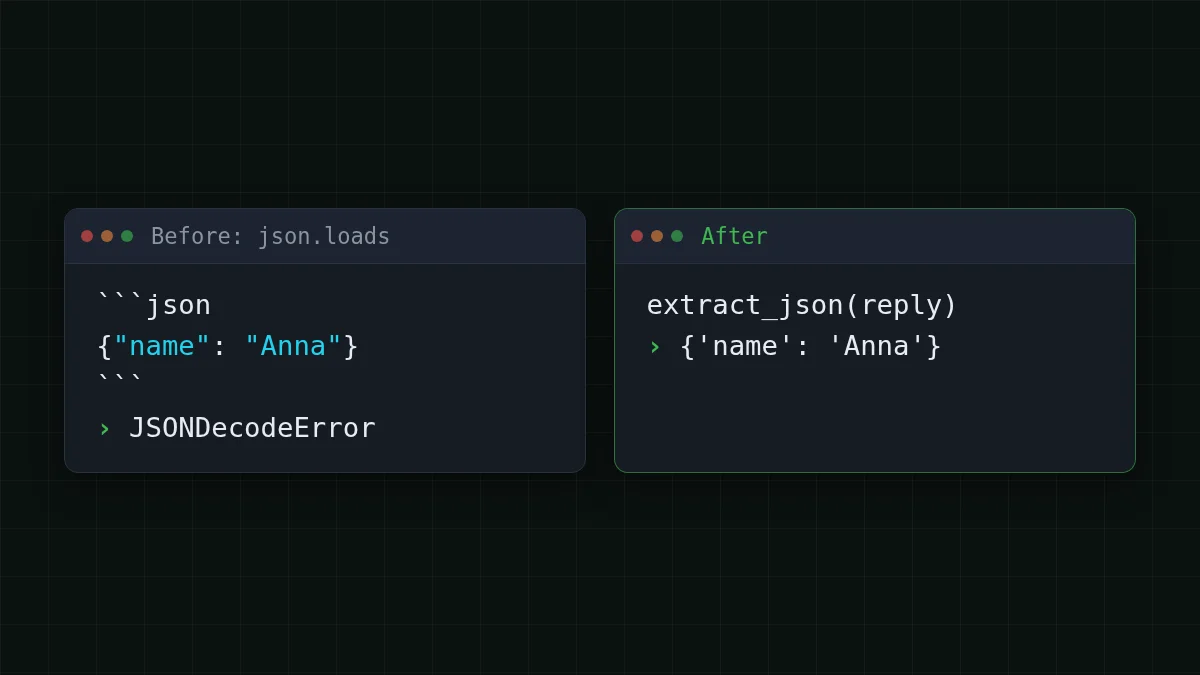
สคริปต์ของคุณขอ JSON จากโมเดล เรียก json. แล้วพังด้วย json. โดยปกติแล้วโมเดลตอบมาแล้ว: มันห่อ JSON ด้วย ```json fence, put a line of chat in front of it, or ran into max_tokens halfway through. Look at exc.pos and finish_reason to tell which one it is, pull the object out with JSONDecoder. และลองอีกครั้งหากไม่มีอะไรที่บันทึกได้
สามวิธีที่การตอบกลับทำให้ json.loads พัง#
เอกสาร json ของ Python (เอกสาร Python 3.15 ตรวจสอบเมื่อ 2 พฤศจิกายน 2026) กล่าวว่า JSONDecodeError เป็นคลาสย่อยของ ValueError ที่มีแอตทริบิวต์ msg, doc, pos, lineno และ colno สิ่งที่สำคัญตรงนี้คือ pos: ดัชนีในสตริงที่การแยกวิเคราะห์ล้มเหลว
สมมติว่าสคริปต์ดึงฟิลด์จากอีเมลลูกค้าและขอ {"name": . สตริงสามอันนี้คือการตอบกลับที่ทำให้มันพัง วางลงในเชลล์ Python:
import json

fenced = '```json\n{"name": "Anna", "age": 31}\n```'
chatty = 'Sure! Here is the JSON:\n{"name": "Anna", "age": 31}'
cut = '{"name": "Anna", "age": 31'

for reply in (fenced, chatty, cut):
    try:
        json.loads(reply)
    except json.JSONDecodeError as exc:
        print(exc.pos, len(reply))
สองอันแรกล้มเหลวที่ pos 0: ตัวแยกวิเคราะห์ดูอักขระตัวแรกสุด ซึ่งเป็น backtick หรือ S แล้วยอมแพ้ อันที่สามล้มเหลวที่ท้ายสตริง (pos เท่ากับ len(reply)): ทุกอย่างที่อ่านมาถูกต้อง แล้วข้อความก็หมด นั่นคือความแตกต่างที่ใช้วินิจฉัย ตำแหน่ง 0 หมายความว่า JSON น่าจะอยู่ตรงนั้น แค่ถูกห่อหุ้ม ตำแหน่งที่ท้ายหมายความว่าคำตอบหยุดก่อนกำหนด
คำตอบที่ถูกตัด: ตรวจสอบ finish_reason ก่อนแยกวิเคราะห์#
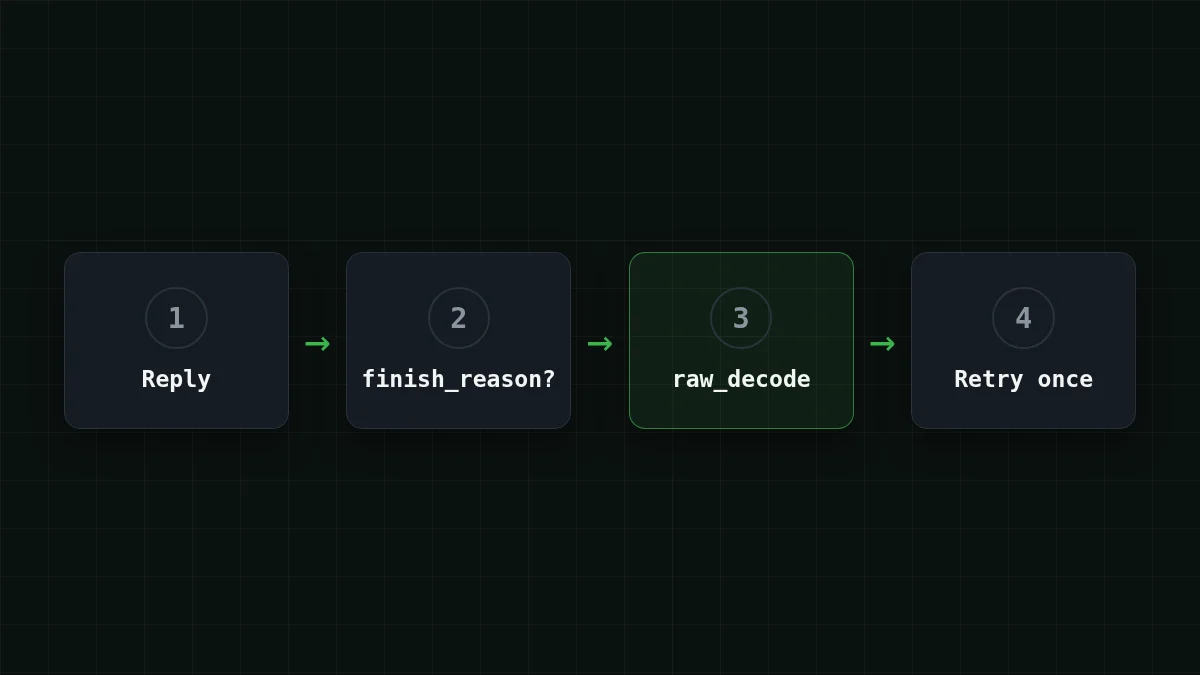
การตอบกลับที่หยุดกลางคันไม่ใช่ปัญหาเรื่องการแยกวิเคราะห์ แต่เป็นปัญหาเรื่องความยาว API บอกคุณว่า: ตัวเลือกมี finish_reason และ "length" หมายความว่าคำตอบถูกตัดด้วย max_tokens (เรื่องเต็มอยู่ใน AI answer cut off? Fix finish_reason "length" and max_tokens) ดูมันก่อน ก่อนการดึงข้อมูลใดๆ
มีกับดักร้ายถ้าคุณข้ามขั้นตอนนั้น ตัวสแกนที่ตามหาวัตถุ { แรกที่แยกวิเคราะห์ได้อาจคว้าวัตถุภายในที่สมบูรณ์จากวัตถุภายนอกที่ยังไม่เสร็จ แล้วสคริปต์ของคุณก็ดำเนินการต่อด้วยข้อมูลผิดและไม่มีข้อผิดพลาด ลองดู:
ลองด้วยตัวเองลองดู: ฟังก์ชัน "หาวัตถุแรก" คืนค่าอะไรสำหรับคำตอบที่ถูกตัดนี้?แสดงคำตอบ
ใช้ '{"user": {"name": "Anna"}, "age": 31' วัตถุภายนอกไม่เคยปิด แต่ {"name": "Anna"} ภายในสมบูรณ์ ดังนั้นตัวดึงข้อมูลด้านล่างคืนค่า {'name': 'Anna'} ไม่มีข้อยกเว้น ผลลัพธ์ผิด นั่นคือเหตุผลที่การตรวจสอบ finish_reason มาก่อนการดึงข้อมูล
การแก้ไขสำหรับการตัดจริงคือเพิ่มพื้นที่: เพิ่ม max_tokens DeepSeek-V4-Flash อนุญาตสูงสุด 32,768 โทเค็นเอาต์พุตต่อคำตอบ GLM-5.3-Flash สูงสุด 8,192 ดังนั้นรายการ JSON ยาวจึงมีพื้นที่มากกว่าบนตัวแรก รายละเอียดของโมเดลอยู่ที่ หน้ารุ่นของ CheapTokens
ดึง JSON ออกจากข้อความ#
สำหรับรั้วและคำพูดพล่าม ไลบรารีมาตรฐานมีเครื่องมืออยู่แล้ว ตามหน้า Python เดียวกัน JSONDecoder. ถอดรหัสเอกสาร JSON จากสตริงที่เริ่มต้นด้วยเอกสารนั้นและคืนวัตถุพร้อมดัชนีที่เอกสารสิ้นสุด เอกสารกล่าวว่าสามารถใช้กับสตริงที่มีข้อมูลเกินท้ายได้ มันต้องการให้เอกสารเริ่มที่อักขระตัวแรก ดังนั้นตัดข้อความนำหน้าออกก่อน: มองหา { ลองถอดรหัสจากตรงนั้น และเลื่อนไป { ถัดไปหากล้มเหลว
import json

def extract_json(text):
    """Return the first JSON object found in text, or raise ValueError."""
    decoder = json.JSONDecoder()
    for i, ch in enumerate(text):
        if ch == '{':
            try:
                obj, _end = decoder.raw_decode(text[i:])
                return obj
            except json.JSONDecodeError:
                continue
    raise ValueError('no JSON object in the reply')
มันจัดการรั้วได้ (```json is skipped because it is not a นำหน้า{), the sentence before the object, and text after the closing brace. Expecting a list? Look for '[' instead. Don't look for both: a stray [1] ในประโยคอย่าง "see note [1]" เป็น JSON ที่ถูกต้องและจะชนะ
สองสิ่งที่มันจงใจไม่ทำ มันไม่เคยแก้ไขข้อความ (ไม่มี regex ที่ลบ backtick ไม่มีการเดาวงเล็บที่หายไป) ดังนั้นคุณไม่สามารถเปลี่ยนการตอบกลับที่พังให้เป็นข้อมูลที่ถูกต้องแต่ผิดได้ และมันล้มเหลวอย่างชัดเจนเมื่อไม่มีอะไรให้หา ซึ่งเป็นสิ่งที่การลองใหม่ด้านล่างต้องการ
ลองอีกครั้งหนึ่งครั้งด้วยพรอมต์ที่เข้มงวดขึ้น#
หากการตอบกลับถูกตัดหรือไม่มีวัตถุเลย ถามอีกครั้ง ครั้งเดียว ไม่ใช่วงวนไม่สิ้นสุด เมื่อถูกตัด ให้ความพยายามครั้งที่สองมีพื้นที่มากขึ้น มิฉะนั้นบอกตรงๆ ว่าคุณต้องการอะไร สิ่งนี้ใช้ OpenAI Python SDK กับ base URL ของ CheapTokens (https:/) และ model id เต็มจากเอกสาร คีย์อยู่ในตัวแปรสภาพแวดล้อม
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
STRICT = '\n\nReply with one JSON object only. No text before or after it, no code fence.'

def ask_json(prompt, max_tokens=800):
    content = prompt
    for attempt in (1, 2):
        resp = client.chat.completions.create(
            model=MODEL,
            messages=[{'role': 'user', 'content': content}],
            max_tokens=max_tokens,
        )
        choice = resp.choices[0]
        if choice.finish_reason == 'length':
            max_tokens *= 2          # cut off: more room next time
        else:
            try:
                return extract_json(choice.message.content or '')
            except ValueError:
                pass                 # no object: try the stricter prompt
        content = prompt + STRICT
    raise ValueError('no valid JSON after one retry')
ลำดับคือประเด็น: finish_reason ก่อน การดึงข้อมูลที่สอง และจากนั้นจึงลองใหม่ ยกข้อผิดพลาดหลังความพยายามครั้งที่สองเพื่อให้งานแบบแบตช์สามารถบันทึกรายการนั้นและดำเนินการต่อ
ค่าใช้จ่ายของการลองใหม่นั้นประเมินได้ง่าย สมมติว่าคำขอ 1,200 โทเค็นอินพุตและ 300 โทเค็นเอาต์พุต (สมมติฐาน ใช้ตัวเลขของคุณเอง): $0.000048 บน DeepSeek-V4-Flash หรือ $0.000036 บน GLM-5.3-Flash หาก 30 จาก 1,000 คำขอต้องใช้ความพยายามครั้งที่สอง บิลเพิ่มเติมคือ 30 × คำขอนั้น $0.0014 บน DeepSeek-V4-Flash ราคาเป็นแบบเรียลไทม์ มาจากรายการราคาปัจจุบัน
เรียงลำดับ
เรียงลำดับขั้นตอนการซ่อม
ลากรายการหรือใช้ลูกศร
- ตรวจสอบ finish_reason: หยุดตรงนี้หากมันบอกว่า length
- หา { ตัวแรกและตัดข้อความก่อนหน้ามัน
- ถอดรหัสด้วย raw_decode และเพิกเฉยต่อสิ่งที่ตามมา
- หากไม่พบอะไร ลองอีกครั้งหนึ่งครั้งด้วยพรอมต์ที่เข้มงวดขึ้น
อาการไหน การแก้ไขไหน#
ขั้นตอนข้างต้นพอจำได้จนกว่าข้อผิดพลาดแปลกๆ ครั้งต่อไปจะปรากฏ นี่คือสิ่งเดียวกับการค้นหา: หาสิ่งที่คุณเห็นบนหน้าจอและอ่านการแก้ไข
เลือกกรณีของคุณ
เลือกสิ่งที่คุณเห็น
เลือกตัวเลือกเพื่อดูคำตอบ
json.loads ล้มเหลวที่ pos 0
การตอบกลับเริ่มด้วยรั้วหรือประโยค รันผ่าน extract_json; ไม่จำเป็นต้องลองใหม่
pos อยู่ที่ท้ายสตริง
คำตอบหยุดก่อนกำหนด ตรวจสอบ finish_reason: หากเป็น length ให้เพิ่ม max_tokens และถามอีกครั้ง
ข้อผิดพลาดอยู่ตรงกลาง
โมเดลเขียน JSON ที่พังเอง (ลูกน้ำหาย ลูกน้ำเกิน เครื่องหมายคำพูดที่ไม่ถูก escape) อย่าแพตช์: ลองอีกครั้งหนึ่งครั้งด้วยพรอมต์ที่เข้มงวดขึ้นและบันทึกการตอบกลับหากล้มเหลวอีก
json.loads ทำงานแต่คีย์หาย
การแยกวิเคราะห์ดี เนื้อหาไม่ดี ระบุคีย์ที่แน่นอนในพรอมต์และตรวจสอบในโค้ดหลังการแยกวิเคราะห์
API บังคับ JSON ที่ถูกต้องได้ไหม?#
บางครั้งได้ คู่มือ structured outputs ของ OpenAI ระบุสองโหมด: JSON mode (type: json_) ซึ่งคืน JSON ที่ถูกต้องแต่ไม่ทำตามสคีมา และ Structured Outputs (type: json_, strict: true) ซึ่งทำตาม; OpenAI แนะนำแบบที่สองเมื่อเป็นไปได้ (แหล่ง: developers.openai.com ตรวจสอบเมื่อ 2 พฤศจิกายน 2026) นั่นคือตัวเลือก API ของ OpenAI เอง ก่อนพึ่งพา response_format กับเอนด์พอยต์อื่น ตรวจสอบ เอกสาร CheapTokens; การดึงข้อมูลและการลองใหม่ข้างต้นทำงานกับ chat completions ธรรมดาและไม่ต้องใช้พารามิเตอร์พิเศษ เพิ่มเติมเกี่ยวกับตัวเลือกฝั่งคำขอใน Get valid JSON from an LLM API: response_format and retries
ก่อนส่งตัวแยกวิเคราะห์ ตรวจสอบสี่สิ่ง: finish_reason ถูกอ่านก่อนข้อความถูกแยกวิเคราะห์ มีการลองใหม่เพียงครั้งเดียว (และความล้มเหลวครั้งที่สองถูกบันทึกพร้อม id รายการ) โค้ดตรวจสอบว่าคีย์ที่คาดหวังมีอยู่หลังการแยกวิเคราะห์ และ max_tokens เหลือที่ว่างสำหรับ JSON ที่ยาวที่สุดที่คุณคาดหวัง
ครั้งต่อไปที่ json.loads โยน พิมพ์ exc.pos และ finish_reason ก่อน ตัวเลขสองตัวนั้นมักบอกคุณว่าเกิดอะไรขึ้นก่อนที่คุณจะอ่านการตอบกลับสักบรรทัด


