Khắc phục sự cốHướng dẫn
json.JSONDecodeError trên một câu trả lời LLM: trích xuất JSON trong Python
json.loads thất bại trên một câu trả lời của model? Đọc exc.pos và finish_reason để tìm nguyên nhân, sau đó trích xuất JSON với raw_decode và thử lại một lần.
Trên trang này
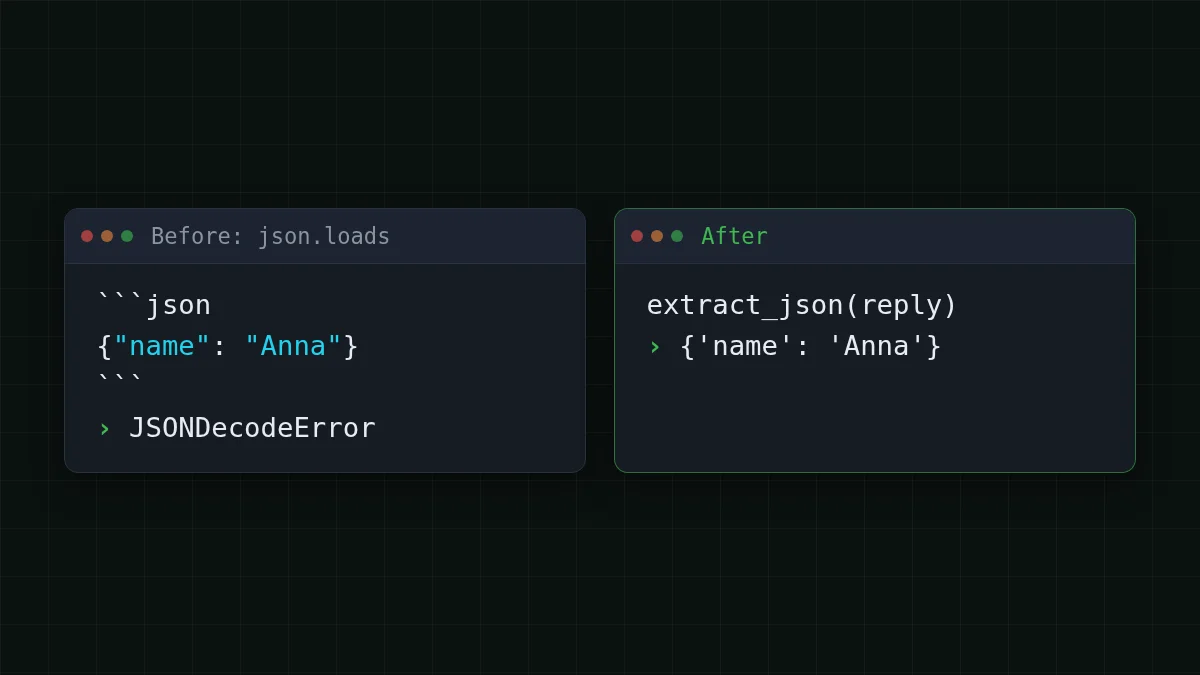
Script của bạn yêu cầu model trả về JSON, gọi json. và chết với json.. Thường thì model đã trả lời: nó bọc JSON trong một ```json fence, put a line of chat in front of it, or ran into max_tokens halfway through. Look at exc.pos and finish_reason to tell which one it is, pull the object out with JSONDecoder., và thử lại một lần nếu không thể lưu được gì.
Ba cách một câu trả lời phá vỡ json.loads#
Tài liệu json của Python (tài liệu Python 3.15, kiểm tra ngày 2 tháng 11 năm 2026) nói rằng JSONDecodeError là lớp con của ValueError với các thuộc tính msg, doc, pos, lineno và colno. Thuộc tính quan trọng ở đây là pos: chỉ số trong chuỗi nơi việc phân tích cú pháp thất bại.
Giả sử một script trích xuất các trường từ email khách hàng và yêu cầu {"name": .. Ba chuỗi này là những câu trả lời phá vỡ nó. Dán chúng vào một shell Python:
import json

fenced = '```json\n{"name": "Anna", "age": 31}\n```'
chatty = 'Sure! Here is the JSON:\n{"name": "Anna", "age": 31}'
cut = '{"name": "Anna", "age": 31'

for reply in (fenced, chatty, cut):
    try:
        json.loads(reply)
    except json.JSONDecodeError as exc:
        print(exc.pos, len(reply))
Hai chuỗi đầu tiên thất bại tại pos 0: bộ phân tích cú pháp đã nhìn vào ký tự đầu tiên, một dấu backtick hoặc một S, và bỏ cuộc. Chuỗi thứ ba thất bại ở cuối chuỗi (pos bằng len(reply)): mọi thứ nó đọc đều ổn, rồi văn bản hết. Sự khác biệt đó là chẩn đoán của bạn. Vị trí 0 có nghĩa là JSON có lẽ ở đó, chỉ là bị bọc. Vị trí ở cuối có nghĩa là câu trả lời dừng sớm.
Câu trả lời bị cắt: kiểm tra finish_reason trước khi phân tích cú pháp#
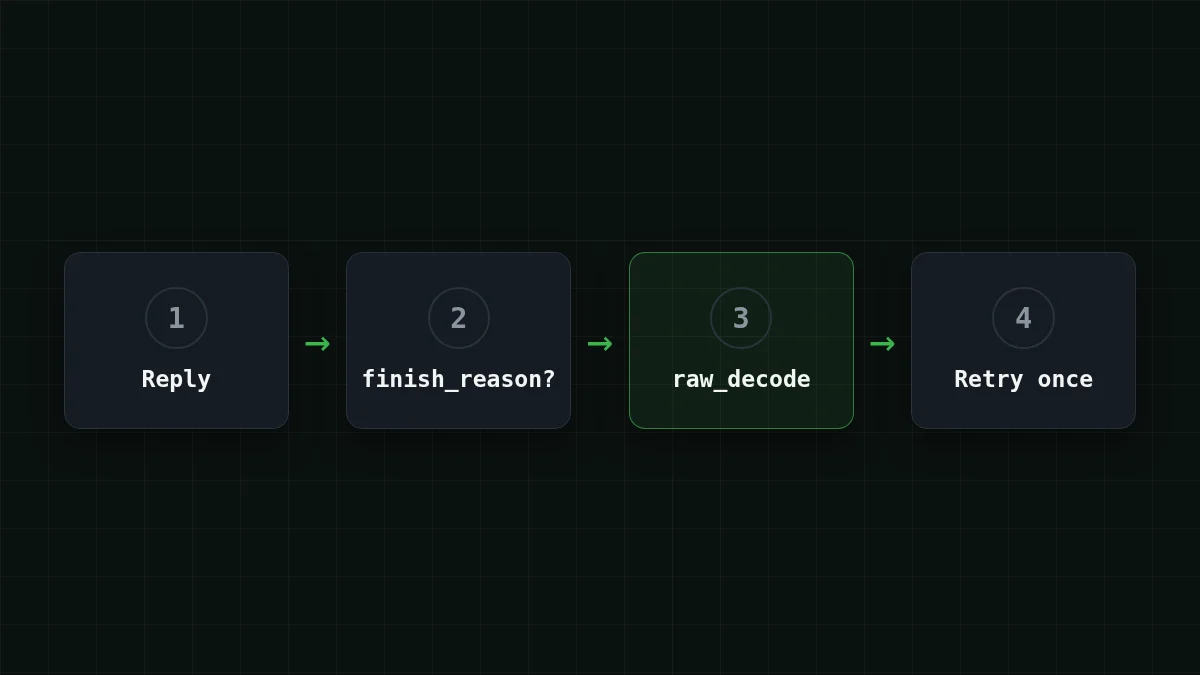
Một câu trả lời dừng giữa chừng không phải là vấn đề phân tích cú pháp, mà là vấn đề độ dài. API cho bạn biết: lựa chọn có finish_reason, và "length" có nghĩa là câu trả lời đã bị cắt bởi max_tokens (toàn bộ câu chuyện trong Câu trả lời AI bị cắt? Sửa finish_reason "length" và max_tokens). Hãy xem nó trước, trước bất kỳ trích xuất nào.
Có một cái bẫy khó chịu nếu bạn bỏ qua bước đó. Một bộ quét tìm kiếm { có thể phân tích được đầu tiên có thể nhặt một đối tượng bên trong hoàn chỉnh từ một đối tượng bên ngoài chưa hoàn thành, và script của bạn tiếp tục với dữ liệu sai và không có lỗi. Hãy thử:
Tự mình thử xemThử: hàm "tìm đối tượng đầu tiên" trả về gì cho câu trả lời bị cắt này?Hiện đáp án
Lấy '{"user": {"name": "Anna"}, "age": 31'. Đối tượng bên ngoài không bao giờ đóng, nhưng {"name": "Anna"} bên trong hoàn chỉnh, vì vậy bộ trích xuất bên dưới trả về {'name': 'Anna'}. Không có ngoại lệ, kết quả sai. Đó là lý do kiểm tra finish_reason đến trước khi trích xuất.
Cách khắc phục cho một cắt thực sự là thêm chỗ: tăng max_tokens. DeepSeek-V4-Flash cho phép tối đa 32.768 token đầu ra mỗi câu trả lời, GLM-5.3-Flash tối đa 8.192, vì vậy một danh sách JSON dài có nhiều chỗ hơn trên cái đầu tiên. Chi tiết của các model có trên trang model của CheapTokens.
Kéo JSON ra khỏi văn bản#
Đối với hàng rào và lời nói thêm, thư viện chuẩn đã có công cụ. Theo cùng trang Python, JSONDecoder. giải mã một tài liệu JSON từ một chuỗi bắt đầu bằng một tài liệu và trả về đối tượng cộng với chỉ số nơi tài liệu kết thúc. Tài liệu nói rằng nó có thể được sử dụng trên một chuỗi có dữ liệu thừa ở cuối. Nó cần tài liệu bắt đầu từ ký tự đầu tiên, vì vậy hãy cắt văn bản dẫn đầu trước: tìm một {, thử giải mã từ đó, và chuyển sang { tiếp theo nếu thất bại.
import json

def extract_json(text):
    """Return the first JSON object found in text, or raise ValueError."""
    decoder = json.JSONDecoder()
    for i, ch in enumerate(text):
        if ch == '{':
            try:
                obj, _end = decoder.raw_decode(text[i:])
                return obj
            except json.JSONDecodeError:
                continue
    raise ValueError('no JSON object in the reply')
Nó xử lý hàng rào (dấu ```json is skipped because it is not a {), the sentence before the object, and text after the closing brace. Expecting a list? Look for '[' instead. Don't look for both: a stray [1] trong một câu như "xem ghi chú [1]" là JSON hợp lệ và sẽ thắng.
Hai điều nó cố ý không làm. Nó không bao giờ chỉnh sửa văn bản (không có regex xóa dấu backtick, không đoán dấu ngoặc bị thiếu), vì vậy bạn không thể biến một câu trả lời bị hỏng thành dữ liệu hợp lệ nhưng sai. Và nó thất bại ồn ào khi không có gì để tìm, đó là điều mà lần thử lại bên dưới cần.
Thử lại một lần với lời nhắc chặt chẽ hơn#
Nếu câu trả lời bị cắt hoặc không chứa đối tượng nào cả, hãy hỏi lại. Một lần, không phải trong một vòng lặp vô tận. Khi bị cắt, cho lần thử thứ hai thêm chỗ; nếu không, nói rõ ràng những gì bạn muốn. Điều này sử dụng SDK Python của OpenAI với URL cơ sở CheapTokens (https:/) và id model đầy đủ từ tài liệu; khóa nằm trong một biến môi trường.
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
STRICT = '\n\nReply with one JSON object only. No text before or after it, no code fence.'

def ask_json(prompt, max_tokens=800):
    content = prompt
    for attempt in (1, 2):
        resp = client.chat.completions.create(
            model=MODEL,
            messages=[{'role': 'user', 'content': content}],
            max_tokens=max_tokens,
        )
        choice = resp.choices[0]
        if choice.finish_reason == 'length':
            max_tokens *= 2          # cut off: more room next time
        else:
            try:
                return extract_json(choice.message.content or '')
            except ValueError:
                pass                 # no object: try the stricter prompt
        content = prompt + STRICT
    raise ValueError('no valid JSON after one retry')
Thứ tự là điểm mấu chốt: finish_reason trước, trích xuất thứ hai, và chỉ sau đó mới thử lại. Nâng cao lỗi sau lần thử thứ hai để một công việc hàng loạt có thể ghi lại mục đó và tiếp tục.
Chi phí của một lần thử lại rất dễ ước tính. Giả sử một yêu cầu 1.200 token đầu vào và 300 token đầu ra (một giả định, hãy sử dụng số của riêng bạn): $0.000048 trên DeepSeek-V4-Flash hoặc $0.000036 trên GLM-5.3-Flash. Nếu 30 trong 1.000 yêu cầu cần lần thử thứ hai, hóa đơn thêm là 30 × yêu cầu đó, $0.0014 trên DeepSeek-V4-Flash. Giá cả trực tiếp, chúng đến từ danh sách giá hiện tại.
Sắp xếp thứ tự
Đặt các bước sửa chữa theo thứ tự
Kéo các mục hoặc dùng mũi tên
- Kiểm tra finish_reason: dừng ở đây nếu nó nói length
- Tìm { đầu tiên và cắt văn bản trước nó
- Giải mã với raw_decode và bỏ qua những gì theo sau
- Nếu không tìm thấy gì, thử lại một lần với lời nhắc chặt chẽ hơn
Triệu chứng nào, cách khắc phục nào#
Các bước trên phù hợp trong đầu bạn cho đến khi lỗi kỳ lạ tiếp theo xuất hiện. Đây là điều tương tự như một bảng tra cứu: tìm những gì bạn thấy trên màn hình và đọc cách khắc phục.
Chọn trường hợp của bạn
Chọn những gì bạn thấy
Chọn một tùy chọn để xem đáp án
json.loads thất bại tại pos 0
Câu trả lời bắt đầu bằng một hàng rào hoặc một câu. Chạy nó qua extract_json; không cần thử lại.
pos ở cuối chuỗi
Câu trả lời dừng sớm. Kiểm tra finish_reason: nếu nó là length, tăng max_tokens và hỏi lại.
Lỗi ở đâu đó ở giữa
Model đã viết JSON bị hỏng (thiếu dấu phẩy, dấu phẩy thừa, dấu ngoặc kép không thoát). Đừng vá nó: thử lại một lần với lời nhắc chặt chẽ hơn và ghi lại câu trả lời nếu nó thất bại lần nữa.
json.loads hoạt động nhưng thiếu một khóa
Phân tích cú pháp ổn, nội dung không. Liệt kê các khóa chính xác trong lời nhắc và kiểm tra chúng trong mã sau khi phân tích cú pháp.
API có thể buộc JSON hợp lệ không?#
Đôi khi. Hướng dẫn đầu ra có cấu trúc của OpenAI ghi lại hai chế độ: chế độ JSON (type: json_), trả về JSON hợp lệ nhưng không tuân theo lược đồ, và Đầu ra có cấu trúc (type: json_, strict: true), tuân theo; OpenAI khuyến nghị cái thứ hai khi có thể (nguồn: developers.openai.com, kiểm tra ngày 2 tháng 11 năm 2026). Đó là các tùy chọn API riêng của OpenAI. Trước khi dựa vào response_format với một điểm cuối khác, hãy kiểm tra tài liệu CheapTokens; việc trích xuất và thử lại ở trên hoạt động với các hoàn thành trò chuyện đơn giản và không cần tham số đặc biệt. Thêm về các tùy chọn phía yêu cầu trong Lấy JSON hợp lệ từ một API LLM: response_format và thử lại.
Trước khi bạn gửi bộ phân tích cú pháp, hãy kiểm tra bốn điều: finish_reason được đọc trước khi văn bản được phân tích cú pháp, chỉ có một lần thử lại (và lần thất bại thứ hai được ghi lại với id mục), mã kiểm tra rằng các khóa mong đợi tồn tại sau khi phân tích cú pháp, và max_tokens để lại chỗ cho JSON dài nhất bạn mong đợi.
Lần tới khi json.loads ném, hãy in exc.pos và finish_reason trước. Hai con số đó thường cho bạn biết điều gì đã xảy ra trước khi bạn đọc một dòng của câu trả lời.


