json.JSONDecodeError em uma resposta de LLM: extraia o JSON em Python
json.loads falha em uma resposta de modelo? Leia exc.pos e finish_reason para encontrar a causa, depois extraia o JSON com raw_decode e tente novamente uma vez.
Nesta página
Seu script pede JSON ao modelo, chama json. e morre com json.. Normalmente o modelo respondeu: ele envolveu o JSON em um ```json fence, put a line of chat in front of it, or ran into max_tokens halfway through. Look at exc.pos and finish_reason to tell which one it is, pull the object out with JSONDecoder., e tente novamente uma vez se nada puder ser salvo.
Três formas de uma resposta quebrar o json.loads#
A documentação do json do Python (docs do Python 3.15, verificada em 2 de novembro de 2026) diz que JSONDecodeError é uma subclasse de ValueError com os atributos msg, doc, pos, lineno e colno. O que importa aqui é pos: o índice na string onde o parsing falhou.
Digamos que um script extraia campos de e-mails de clientes e peça {"name": .. Estas três strings são as respostas que o quebram. Cole-as em um shell Python:
import json

fenced = '```json\n{"name": "Anna", "age": 31}\n```'
chatty = 'Sure! Here is the JSON:\n{"name": "Anna", "age": 31}'
cut = '{"name": "Anna", "age": 31'

for reply in (fenced, chatty, cut):
    try:
        json.loads(reply)
    except json.JSONDecodeError as exc:
        print(exc.pos, len(reply))
As duas primeiras falham na posição pos 0: o parser olhou o primeiro caractere, uma crase ou um S, e desistiu. A terceira falha no fim da string (pos é igual a len(reply)): tudo o que ele leu estava certo, e então o texto acabou. Essa diferença é o seu diagnóstico. Posição 0 significa que o JSON provavelmente está lá, só que envolto. Posição no fim significa que a resposta parou cedo.
Respostas cortadas: verifique finish_reason antes de fazer o parsing#
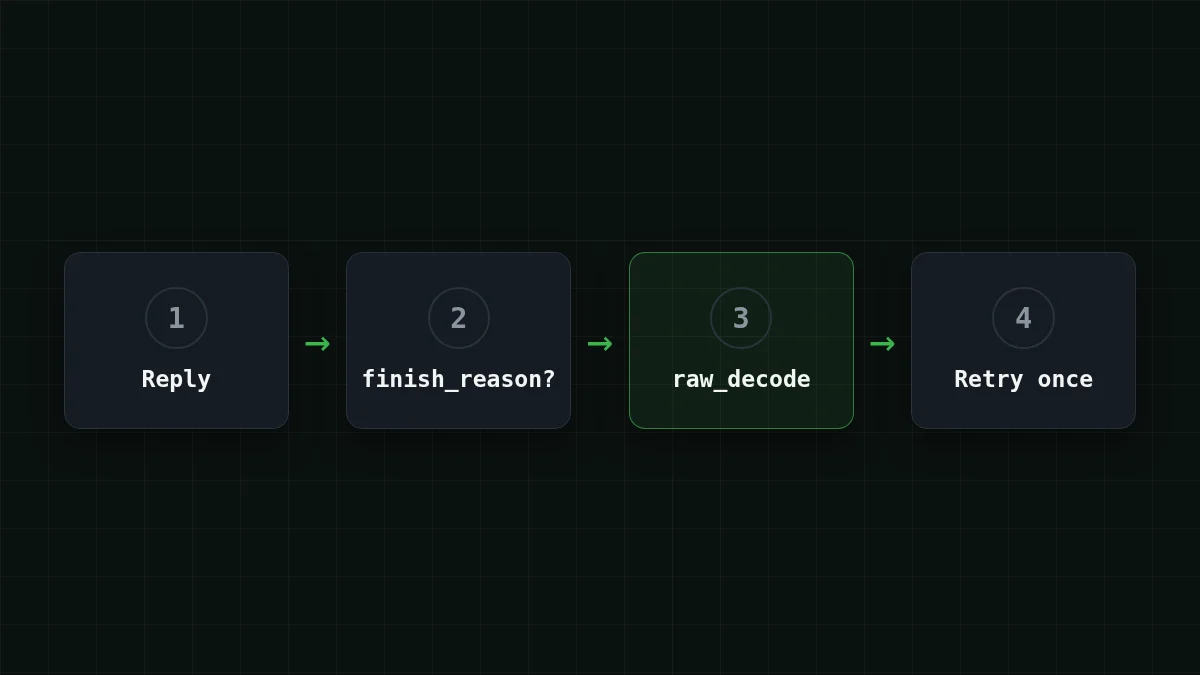
Uma resposta que para no meio não é um problema de parsing, é um problema de comprimento. A API te avisa: a escolha tem finish_reason, e "length" significa que a resposta foi cortada por max_tokens (a história completa está em Resposta da IA cortada? Corrija finish_reason "length" e max_tokens). Olhe isso primeiro, antes de qualquer extração.
Há uma armadilha desagradável se você pular essa etapa. Um scanner que procura o primeiro { parseável pode pegar um objeto interno completo de um objeto externo pela metade, e seu script segue com os dados errados e sem erro. Experimente:
Experimente você mesmoExperimente: o que uma função "encontre o primeiro objeto" retorna para esta resposta cortada?Mostrar resposta
Pegue '{"user": {"name": "Anna"}, "age": 31'. O objeto externo nunca fecha, mas o {"name": "Anna"} interno está completo, então o extrator abaixo retorna {'name': 'Anna'}. Nenhuma exceção, resultado errado. É por isso que a verificação de finish_reason vem antes da extração.
A correção para um corte real é mais espaço: aumente max_tokens. O DeepSeek-V4-Flash permite até 32.768 tokens de saída por resposta, o GLM-5.3-Flash até 8.192, então uma lista JSON longa tem mais espaço no primeiro. Detalhes dos modelos estão na página de modelos do CheapTokens.
Extraia o JSON do texto#
Para cercas e conversa fiada, a biblioteca padrão já tem a ferramenta. Segundo a mesma página do Python, JSONDecoder. decodifica um documento JSON de uma string que começa com um e retorna o objeto mais o índice onde o documento terminou. A documentação diz que ele pode ser usado em uma string com dados extras no final. Ele precisa que o documento comece no primeiro caractere, então corte o texto inicial primeiro: procure um {, tente decodificar a partir dali e passe para o próximo { se falhar.
import json

def extract_json(text):
    """Return the first JSON object found in text, or raise ValueError."""
    decoder = json.JSONDecoder()
    for i, ch in enumerate(text):
        if ch == '{':
            try:
                obj, _end = decoder.raw_decode(text[i:])
                return obj
            except json.JSONDecodeError:
                continue
    raise ValueError('no JSON object in the reply')
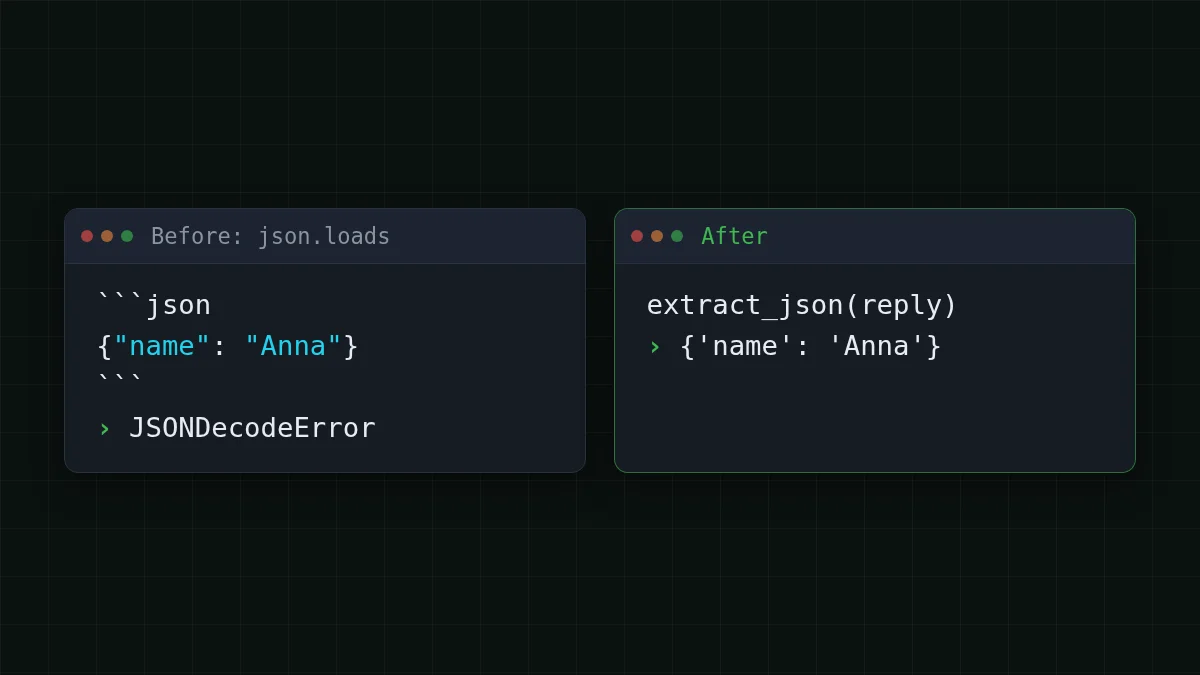
Ele lida com a cerca (o ```json is skipped because it is not a {), the sentence before the object, and text after the closing brace. Expecting a list? Look for '[' instead. Don't look for both: a stray [1] em uma frase como "veja a nota [1]" é JSON válido e venceria.
Duas coisas que ele deliberadamente não faz. Ele nunca edita o texto (nenhum regex que apaga crases, nenhum chute em colchetes faltando), então você não pode transformar uma resposta quebrada em dados válidos mas errados. E ele falha ruidosamente quando não há nada para encontrar, que é o que o retry abaixo precisa.
Tente novamente uma vez com um prompt mais estrito#
Se a resposta foi cortada ou não contém nenhum objeto, pergunte de novo. Uma vez, não em um loop infinito. Em um corte, dê mais espaço à segunda tentativa; caso contrário, diga claramente o que você quer. Isso usa o SDK Python da OpenAI contra a base URL do CheapTokens (https:/) e o id completo do modelo da documentação; a chave fica em uma variável de ambiente.
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
STRICT = '\n\nReply with one JSON object only. No text before or after it, no code fence.'

def ask_json(prompt, max_tokens=800):
    content = prompt
    for attempt in (1, 2):
        resp = client.chat.completions.create(
            model=MODEL,
            messages=[{'role': 'user', 'content': content}],
            max_tokens=max_tokens,
        )
        choice = resp.choices[0]
        if choice.finish_reason == 'length':
            max_tokens *= 2          # cut off: more room next time
        else:
            try:
                return extract_json(choice.message.content or '')
            except ValueError:
                pass                 # no object: try the stricter prompt
        content = prompt + STRICT
    raise ValueError('no valid JSON after one retry')
A ordem é o ponto: finish_reason primeiro, extração depois, e só então um retry. Levante o erro após a segunda tentativa para que um job em lote possa registrar aquele item e seguir em frente.
O custo de um retry é fácil de estimar. Suponha uma requisição de 1.200 tokens de entrada e 300 tokens de saída (uma suposição, use seus próprios números): $0.000048 no DeepSeek-V4-Flash ou $0.000036 no GLM-5.3-Flash. Se 30 de 1.000 requisições precisarem da segunda tentativa, a conta extra é 30 × aquela requisição, $0.0014 no DeepSeek-V4-Flash. Os preços são ao vivo, vêm da lista de preços atual.
Colocar em ordem
Coloque as etapas de reparo em ordem
Arraste os itens ou use as setas
- Verifique finish_reason: pare aqui se disser length
- Encontre o primeiro { e corte o texto antes dele
- Decodifique com raw_decode e ignore o que vem depois
- Se nada foi encontrado, tente novamente uma vez com o prompt mais estrito
Qual sintoma, qual correção#
As etapas acima cabem na sua cabeça até o próximo erro estranho aparecer. Isto é a mesma coisa que uma consulta: encontre o que você vê na tela e leia a correção.
Escolha o seu caso
Escolha o que você vê
Escolha uma opção para ver a resposta
json.loads falha na posição 0
A resposta começa com uma cerca ou uma frase. Passe-a por extract_json; um retry não é necessário.
pos está no fim da string
A resposta parou cedo. Verifique finish_reason: se for length, aumente max_tokens e pergunte de novo.
O erro está em algum lugar no meio
O modelo escreveu JSON quebrado ele mesmo (uma vírgula faltando, uma vírgula sobrando, uma aspa não escapada). Não remende: tente novamente uma vez com o prompt mais estrito e registre a resposta se falhar de novo.
json.loads funciona mas falta uma chave
O parsing está certo, o conteúdo não. Liste as chaves exatas no prompt e verifique-as no código após o parsing.
A API pode forçar JSON válido?#
Às vezes. O guia de structured outputs da OpenAI documenta dois modos: modo JSON (type: json_), que retorna JSON válido mas não segue um schema, e Structured Outputs (type: json_, strict: true), que segue; a OpenAI recomenda o segundo quando possível (fonte: developers.openai.com, verificada em 2 de novembro de 2026). Essas são opções da própria API da OpenAI. Antes de confiar em response_format com outro endpoint, verifique a documentação do CheapTokens; a extração e o retry acima funcionam com chat completions simples e não precisam de parâmetro especial. Mais sobre as opções do lado da requisição em Obtenha JSON válido de uma API de LLM: response_format e retries.
Antes de publicar o parser, verifique quatro coisas: finish_reason é lido antes de o texto ser parseado, há apenas um retry (e a segunda falha é registrada com o id do item), o código verifica que as chaves esperadas existem após o parsing, e max_tokens deixa espaço para o JSON mais longo que você espera.
Da próxima vez que json.loads lançar, imprima exc.pos e finish_reason primeiro. Esses dois números geralmente te dizem o que aconteceu antes de você ler uma linha da resposta.


