UnicodeEncodeError ao imprimir uma resposta de LLM em Python: 3 correções
print(reply) quebra com cirílico ou emoji? Veja por que o Python falha com saída redirecionada ou uma página de código legada, e corrija com modo UTF-8, reconfigure ou encoding=.
Nesta página
Sua requisição passou, o modelo respondeu, e então o Python morreu em print(reply). A API não tem culpa. A resposta está correta; o lugar para onde você a imprime não consegue representar alguns de seus caracteres. A correção mais rápida é ativar o modo UTF-8 com PYTHONUTF8=1. Se preferir manter isso dentro do script, chame sys. no topo, e ao salvar uma resposta em arquivo, passe encoding="utf-8" para open().
Como o erro aparece#
Digamos que você faça uma pergunta a um modelo em russo e imprima a resposta. Este é o script inteiro, usando a chamada simples de requests do nosso guia de primeira requisição:
import os, requests

r = requests.post(
    "https://api.cheaptokens.dev/v1/chat/completions",
    headers={"Authorization": f"Bearer {os.environ['CHEAPTOKENS_API_KEY']}"},
    json={
        "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
        "messages": [{"role": "user", "content": "Ответь одним предложением: что такое токен?"}],
        "max_tokens": 200,
    },
)
reply = r.json()["choices"][0]["message"]["content"]
print(reply)
Quando stdout é redirecionado para um arquivo ou pipe, ou o Python foi iniciado com uma página de código legada para seus streams, a última linha termina assim:
UnicodeEncodeError: 'charmap' codec can't encode characters in position 0-5: character maps to <undefined>O nome do codec na sua mensagem depende da codificação do stream (para uma página de código do Windows geralmente é charmap, para ascii é ascii), e as posições dependem da resposta. A forma é sempre a mesma: o traceback aponta para print, não para a requisição.
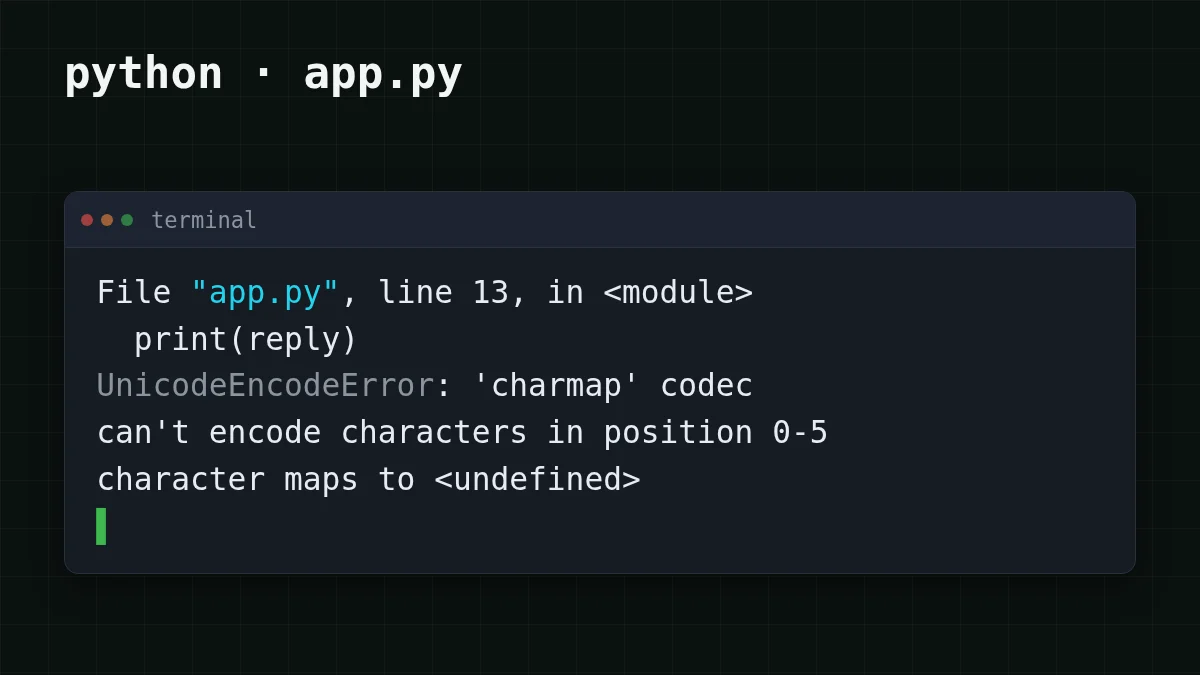
Por que isso acontece? print converte o texto em bytes usando a codificação de sys.stdout. Se essa codificação for uma página de código legada, qualquer caractere fora dela, como cirílico em uma página de código ocidental, um emoji, às vezes um travessão tipográfico, não tem byte para se transformar. O Python lança a exceção em vez de adivinhar.
Isso aparece em três situações:
- stdout é redirecionado ou canalizado (
python app.,py > out. txt | another program), ou o script roda a partir de um agendador, CI ou editor onde stdout não é um console; PYTHONLEGACYWINDOWSSTDIOestá definido, ou o stream de outra forma recebe uma codificação restrita;- você grava a resposta em um arquivo com
open(path, "w")e semencoding=.
Qual Python? Tudo abaixo se refere ao Python 3.7–3.14, onde a codificação de stream e de arquivo vem do sistema. Segundo a PEP 686 (status Final, https://peps.python.org/pep-0686/, verificado em 5 de novembro de 2026), o modo UTF-8 é ativado por padrão a partir do Python 3.15, então open() e stdio já usam UTF-8 lá, a menos que alguém o tenha desativado com PYTHONUTF8=0 ou -X utf8=0. Verifique com python --version.
Verifique qual codificação você realmente tem#
Antes de mudar qualquer coisa, veja o que o Python escolheu. Leva dez segundos.
Experimente você mesmoExperimente: qual o Python acha que é a codificação do seu stdout?Mostrar resposta
Execute python - na mesma janela onde o script falha. Em um console interativo ele geralmente imprime utf-8, então isso sozinho prova pouco. Execute de novo com > check.txt no final e abra o arquivo: a saída redirecionada é o que mais costuma dar um nome cp… ou ascii, e esse é o seu culpado. Se tudo disser utf-8, olhe um arquivo para o qual você grava.
Quer ver o crash sem esperar por um dia ruim? No macOS ou Linux, force uma codificação restrita para uma execução:
PYTHONIOENCODING=ascii python -c "print('Привет')"Isso falha com uma mensagem de codec ascii, da mesma família do erro acima. No Windows a variável é ignorada para um console interativo, mas funciona quando a saída é redirecionada: no cmd execute set PYTHONIOENCODING=ascii, depois python - (no PowerShell: $env:PYTHONIOENCODING = "ascii").
Correção 1: ativar o modo UTF-8#
O Python tem um modo que torna UTF-8 o padrão para texto. Segundo a documentação do Python (página de linha de comando, verificada em 5 de novembro de 2026), PYTHONUTF8=1 o ativa e -X utf8 faz o mesmo; ambos existem desde o Python 3.7. Um detalhe da mesma página: qualquer outro valor não vazio de PYTHONUTF8 causa erro na inicialização, então use exatamente 1 (ou 0 para desativá-lo). No 3.15 você só precisa disso para ativar o modo explicitamente em interpretadores mais antigos; se já estiver ativo lá, procure PYTHONUTF8=0 no seu ambiente.
Ativar o modo UTF-8 para uma execução
cmd
set PYTHONUTF8=1
python app.py
PowerShell
$env:PYTHONUTF8 = "1"
python app.py
macOS / Linux
PYTHONUTF8=1 python app.pySem mudanças no código, e cobre o console, redirecionamentos e arquivos naquela execução. Se não quiser definir uma variável toda vez, python - dá o mesmo resultado pela linha de comando.
Há também PYTHONIOENCODING=utf-, que substitui a codificação apenas de stdin, stdout e stderr. Leia a entrada da documentação antes de confiar nele no Windows: desde o Python 3.6 ele é ignorado para um buffer de console interativo, a menos que PYTHONLEGACYWINDOWSSTDIO esteja definido. Arquivos redirecionados e pipes não são afetados por essa exceção. Então ele pode corrigir python app. e ainda assim não fazer nada na janela do console. Para stderr o handler de erro é sempre backslashreplace.
Correção 2: reconfigurar stdout dentro do script#
Se você não pode controlar como as pessoas iniciam o script, mude o próprio stream logo no topo:
import sys

sys.stdout.reconfigure(encoding="utf-8")
sys.stderr.reconfigure(encoding="utf-8")

print(reply)
reconfigure está documentado para io.TextIOWrapper (adicionado no 3.7). Quando você passa encoding e omite errors, o handler é strict, então um caractere que não se encaixa ainda lança exceção; para o caso comum de UTF-8 não sobra nada. Dois detalhes da documentação: a codificação não pode ser alterada depois que dados foram lidos do stream (pode após uma escrita), e encoding="locale" é suportado desde o 3.11.
Precisa que o script nunca quebre, mesmo em um terminal que realmente não consegue mostrar o texto? Adicione errors="replace". Caracteres desconhecidos então aparecem como ? em vez de interromper a execução. Isso esconde o problema em vez de corrigi-lo, então mantenha para logs.
Correção 3: dar aos arquivos uma codificação explícita#
Salvar uma resposta é a mesma falha, só que mais silenciosa no código:
# before: on Python up to 3.14 this uses the system's default encoding
with open("reply.txt", "w") as f:
    f.write(reply)

# after: the file is UTF-8 on every machine
with open("reply.txt", "w", encoding="utf-8") as f:
    f.write(reply)
Use o mesmo encoding="utf-8" quando ler o arquivo de volta, senão o texto pode quebrar na entrada.
Qual correção você deve usar?#
Escolha o seu caso
Escolha seu caso
Escolha uma opção para ver a resposta
Eu rodo meu próprio script em um terminal
Defina PYTHONUTF8=1 uma vez no seu ambiente, ou inicie com python -. Nada no código muda.
Eu distribuo o script para outras pessoas
Coloque sys. no topo, para funcionar independentemente de como elas o iniciem.
O crash é em um arquivo, não na tela
Adicione encoding="utf-8" a open(), para escrita e leitura.
Você pode combiná-las. Um script que imprime e salva respostas precisa da Correção 2 ou da Correção 1 para a tela e da Correção 3 para o arquivo.
Se ainda falhar#
- O erro mudou para outra linha. Então a chamada que falha é outro
printouwrite; a correção precisa ser aplicada antes que ele rode, então coloquereconfigurebem no topo. - O erro menciona
PYTHONUTF8. A variável tem um valor diferente de1ou0. Remova-a e defina de novo. - Sem crash, mas você vê quadrados ou
?no console. O Python gravou UTF-8 válido; a fonte ou página de código do console não consegue exibi-lo. Redirecione para um arquivo e abra-o em um editor para confirmar que a resposta está intacta. - O erro é um
JSONDecodeError, nãoUnicodeEncodeError. Problema diferente: veja como extrair JSON de uma resposta de modelo.
O código da requisição acima é a chamada simples de requests; a documentação do CheapTokens mostra a mesma chamada para o SDK da OpenAI. Outro modelo funciona com a mesma correção: troque o campo model por zai- (até 8.192 tokens de saída por resposta, contexto de 390K). O erro de codificação não tem nada a ver com o modelo, apenas com o destino do texto.


