Stream falhou após HTTP 200: capture erros no meio do stream em Python
Por que um stream pode quebrar após um status 200, como identificar event: error, e uma nova tentativa em Python que mantém o texto parcial sem duplicar a resposta.
Nesta página
Sua UI de chat transmitiu metade de uma resposta, travou, e o log diz 200 OK. Isso não é uma contradição: o 200 só diz que o stream começou, não que ele terminou. Se algo quebrar depois, o servidor só pode enviar um erro dentro do stream, então uma verificação no código de status nunca o vê. A correção é tratar um stream como bem-sucedido apenas quando ele termina com seu sinal de finalização, e tentar novamente a partir de um buffer limpo quando não terminar.
O restante desta página mostra como é o stream quebrado, dois handlers em Python (Anthropic Messages e OpenAI SDK), e uma nova tentativa que não imprime o início da resposta duas vezes. Ambos os handlers usam CheapTokens como endpoint da API: a documentação tem as URLs base, e o modelo de exemplo é DeepSeek-V4-Flash (id deepseek-, contexto de 380K, até 32.768 tokens de saída por resposta, um preço a qualquer hora — veja a página do modelo).
O que um 200 realmente promete#
Pense em um entregador que assina o recebimento de um pacote na porta: a assinatura prova que ele chegou, não que o pacote está intacto. O HTTP funciona da mesma forma. O servidor envia a linha de status e os cabeçalhos primeiro, depois o corpo chega peça por peça. Se o backend do modelo ficar sobrecarregado no meio do caminho, a linha de status já foi enviada.
A página de erros da API da Anthropic (verificada em 1º de novembro de 2026) diz isso diretamente: quando você recebe uma resposta em streaming via SSE, um erro pode ocorrer depois que a API retorna um 200, e então o tratamento de erros padrão não se aplica. A documentação de streaming dela mostra o formato desse evento:
event: error
data: {"type": "error", "error": {"type": "overloaded_error", "message": "Overloaded"}}
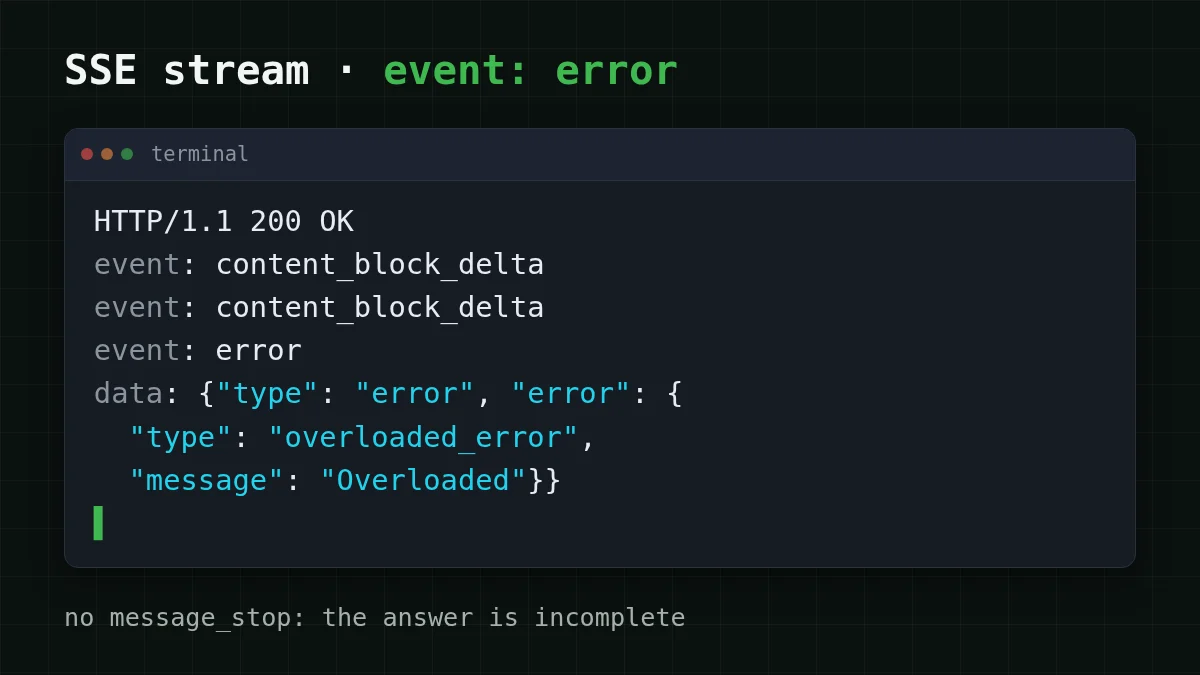
overloaded_error normalmente corresponde a HTTP 529 em uma chamada não-streaming (sobrecarga temporária por alto tráfego). A mesma página lista 500 api_error (tentar novamente com backoff exponencial) e 504 timeout_error (usar streaming para requisições longas). Na prática, um stream quebrado se parece com isto:
A documentação também avisa que novos tipos de evento podem ser adicionados, então seu código deve lidar com eventos desconhecidos de forma graciosa. É por isso que os handlers abaixo não tentam reconhecer cada byte de erro. Eles fazem uma pergunta: o stream terminou com seu sinal de finalização?
- Anthropic Messages: o último evento é
message_stop, estop_reasonemmessage_deltadiz por que ele terminou (end_turn,max_tokens,stop_sequence). - OpenAI Chat Completions: o último chunk carrega um
finish_reasonnão vazio (stop,length, …).
Sem sinal de finalização, ou uma exceção no caminho — a resposta está incompleta, independentemente do que o status dizia.
Capture isso em Python#
Considere um bot de suporte que transmite respostas para o navegador. O loop coleta texto em um buffer e retorna três coisas: o texto até agora, se o stream terminou, e o erro, se houve algum. Escolha a aba do SDK que você usa.
Um handler, dois SDKs
Anthropic SDK
import os
import anthropic

client = anthropic.Anthropic(
    base_url='https://api.cheaptokens.dev',  # no /v1 for the Anthropic SDK
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'

def ask_once(prompt, on_text=lambda t: None):
    parts, finished = [], False
    try:
        with client.messages.stream(
            model=MODEL,
            max_tokens=1024,
            messages=[{'role': 'user', 'content': prompt}],
        ) as stream:
            for event in stream:
                if event.type == 'content_block_delta' and event.delta.type == 'text_delta':
                    parts.append(event.delta.text)
                    on_text(event.delta.text)
                elif event.type == 'message_stop':
                    finished = True
    except anthropic.APIError as err:
        return ''.join(parts), False, err
    return ''.join(parts), finished, None
OpenAI SDK
import os
import openai

client = openai.OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'

def ask_once(prompt, on_text=lambda t: None):
    parts, finish = [], None
    try:
        stream = client.chat.completions.create(
            model=MODEL,
            max_tokens=1024,
            stream=True,
            messages=[{'role': 'user', 'content': prompt}],
        )
        for chunk in stream:
            if not chunk.choices:
                continue
            choice = chunk.choices[0]
            if choice.delta.content:
                parts.append(choice.delta.content)
                on_text(choice.delta.content)
            if choice.finish_reason:
                finish = choice.finish_reason
    except openai.APIError as err:
        return ''.join(parts), False, err
    return ''.join(parts), finish is not None, None
Dois detalhes merecem uma segunda olhada. Primeiro, ambos os handlers capturam a classe de erro base do SDK (anthropic., openai.APIError), então não importa qual subclasse o SDK lance para uma determinada falha. Segundo, a flag finished é separada da exceção: um stream também pode simplesmente terminar cedo, sem nenhuma exceção, e esse caso também deve contar como falha.
O README do openai-python acrescenta o que esperar do lado da OpenAI (verificado em 1º de novembro de 2026): um timeout de leitura em um stream lança APITimeoutError, outras falhas do HTTPX lançam APIConnectionError com a exceção original em __cause__. Se o stream travar em vez de falhar, veja timeouts e novas tentativas no OpenAI Python SDK.
Tente novamente sem imprimir a resposta duas vezes#
Aqui está um bug fácil de enviar. Uma primeira tentativa imprime "A política de reembolso é…", morre, a nova tentativa começa do zero e imprime "A política de reembolso é…" de novo — agora o usuário vê o início duas vezes, ou uma frase colada ao seu próprio reinício. A causa usual é um buffer compartilhado: answer += text vive fora da tentativa, então a segunda tentativa anexa à primeira.
A cura é entediante. Uma tentativa é dona de um buffer, o texto de uma tentativa falha é descartado (ou mantido apenas para o log), e a nova tentativa começa do zero:
import time

def ask_with_retry(prompt, attempts=3, on_text=lambda t: None, on_restart=lambda: None):
    for attempt in range(attempts):
        text, finished, err = ask_once(prompt, on_text)
        if finished:
            return text
        status = getattr(err, 'status_code', None)
        if status is not None and 400 <= status < 500 and status not in (408, 409, 429):
            raise err  # a 400/401/404 will not fix itself
        print(f'attempt {attempt + 1} failed after {len(text)} chars: {err!r}')
        if attempt == attempts - 1:
            break
        on_restart()  # clear the message box in your UI
        time.sleep(2 ** attempt)  # 1 s, 2 s
    raise RuntimeError('stream failed after all attempts')
on_restart é a parte que impede a duplicação. Em uma UI web, ela esvazia o balão de mensagem antes da próxima tentativa transmitir. Em um terminal simples você não pode desimprimir, então ou imprima apenas depois que finished for verdadeiro, ou imprima uma linha --- retrying --- visível. Tentar novamente do zero reenvia o prompt inteiro, então a entrada é cobrada novamente para a nova tentativa; para a maioria das respostas de chat, esse é um preço justo por uma resposta limpa.
Colocar em ordem
Coloque os passos da nova tentativa na ordem em que seu código deve executá-los
Arraste os itens ou use as setas
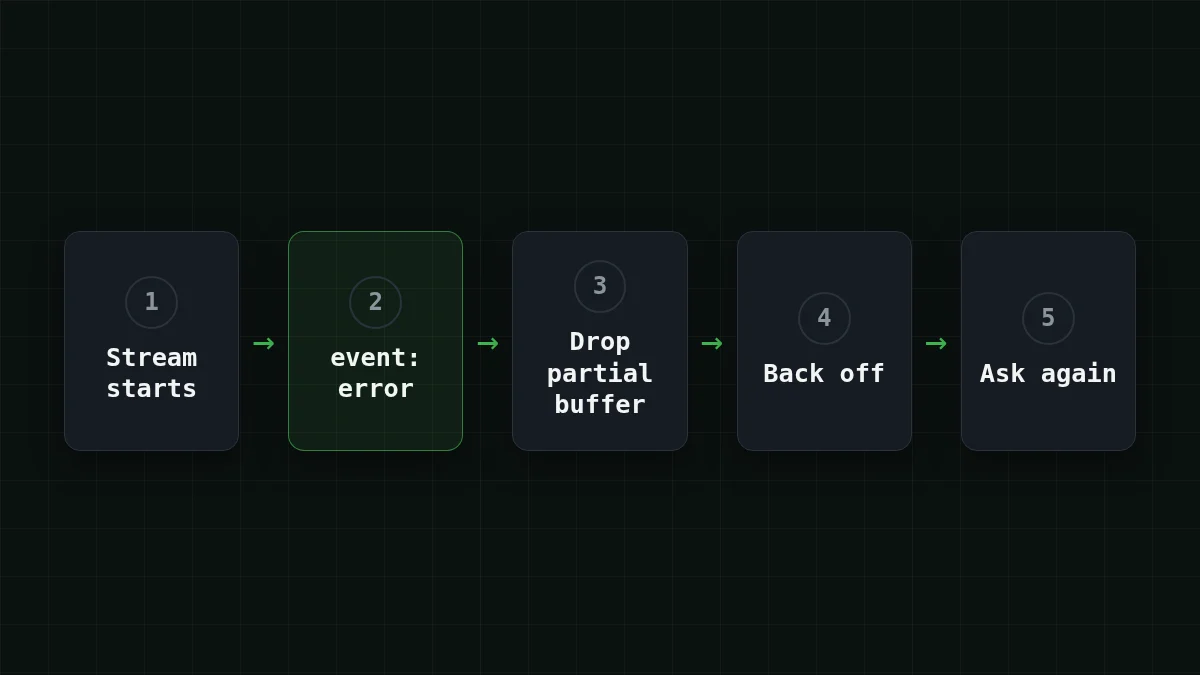
- Pare de ler o stream quebrado e mantenha seu texto parcial para o log
- Verifique o erro: um 4xx diferente de 408, 409 e 429 significa parar, não tentar novamente
- Limpe a caixa de mensagem e inicie um novo buffer
- Aguarde com backoff exponencial (1 s, depois 2 s)
- Envie a requisição completa novamente e mostre apenas a nova resposta
O SDK da Anthropic já tenta novamente falhas transitórias — erros de conexão, limites de taxa, 5xx — com backoff exponencial, 2 vezes por padrão, respeitando retry-after, e max_retries altera isso. Isso cobre a requisição. Um stream que morre depois do 200 é outra história: a documentação diz que o tratamento de erros padrão não se aplica ali, então o loop acima é sua responsabilidade manter. Para 429 isoladamente, há um tutorial separado: 429 Too Many Requests: novas tentativas com backoff.
Nem toda parada antecipada é um erro#
Antes de tentar novamente, verifique por que a resposta terminou. Um stream que termina com stop_ (Anthropic) ou finish_ (OpenAI) terminou — ele apenas atingiu o limite que você definiu. Tentar novamente isso retorna o mesmo texto cortado e a mesma cobrança. Aumente o limite; o guia de resposta cortada explica como.
Há um terceiro grupo: a rede. Conexões ociosas podem ser derrubadas no caminho, o que aparece como um erro de conexão ou um stream que para sem nenhum evento. Trate isso da mesma forma que um erro no meio do stream, e veja erros de conexão comuns se continuar acontecendo. Para gerações longas, a Anthropic recomenda streaming em vez de um max_tokens não-streaming enorme, então você já está do lado certo disso.
Antes de enviar#
Salve o request id de cada tentativa falha. Os corpos de erro da Anthropic carregam um campo request_id e um cabeçalho de resposta request-id, e o SDK Python expõe message.; com esse id, uma falha é rastreável em vez de anedótica.
Lista de verificação
Tratamento de erros de streaming, feito direito
Se você quiser ver o handler rodar, aponte-o para sua própria chave: crie uma chave de API na documentação, defina CHEAPTOKENS_, e chame ask_. Para o básico de streaming em Python, comece com respostas em streaming em Python; o lado da Anthropic é coberto em o Anthropic Python SDK com CheapTokens.