FehlerbehebungAnleitung
Stream nach HTTP 200 fehlgeschlagen: Mid-Stream-Fehler in Python abfangen
Warum ein Stream nach einem 200-Status abbrechen kann, wie man event: error erkennt und ein Python-Retry, der den Teiltext behält, ohne die Antwort zu duplizieren.
Auf dieser Seite
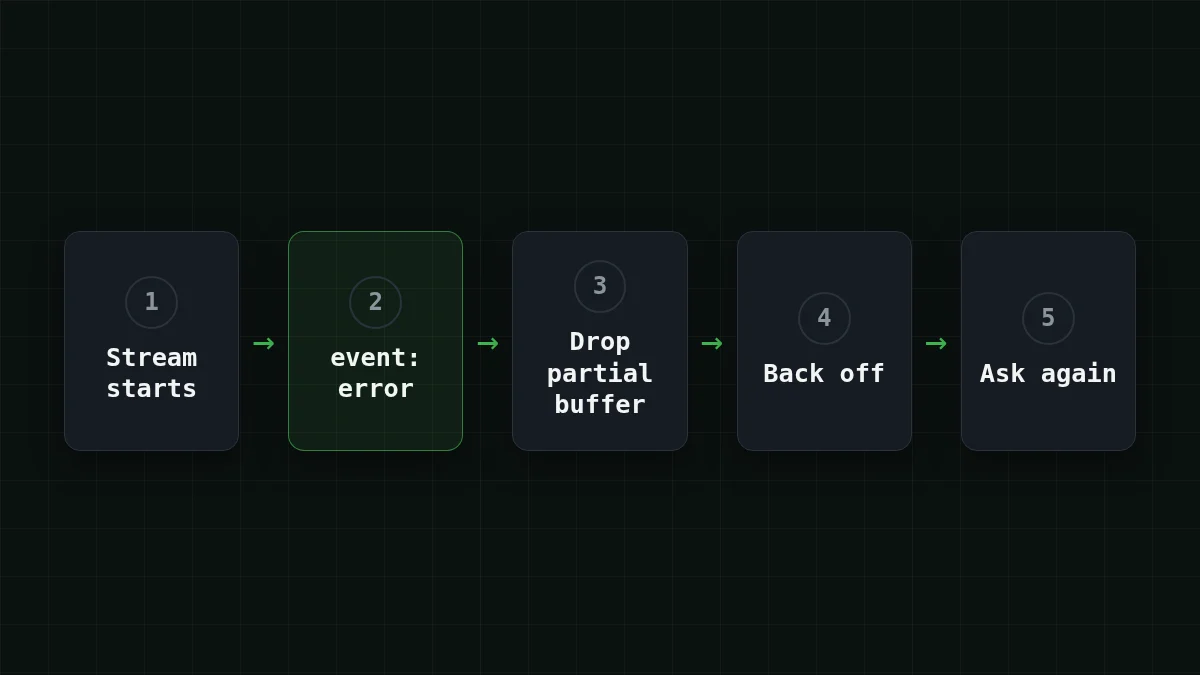
Ihre Chat-UI hat eine halbe Antwort gestreamt, ist eingefroren, und das Log sagt 200 OK. Das ist kein Widerspruch: Die 200 sagt nur, dass der Stream begonnen hat, nicht dass er beendet wurde. Wenn später etwas kaputtgeht, kann der Server einen Fehler nur innerhalb des Streams senden, sodass eine Prüfung des Statuscodes ihn nie sieht. Die Lösung besteht darin, einen Stream nur dann als erfolgreich zu behandeln, wenn er mit seinem Finish-Signal endet, und bei einem sauberen Puffer neu zu starten, wenn er es nicht tut.
Der Rest dieser Seite zeigt, wie der kaputte Stream aussieht, zwei Python-Handler (Anthropic Messages und OpenAI SDK) und einen Retry, der den Anfang der Antwort nicht doppelt ausgibt. Beide Handler verwenden CheapTokens als API-Endpunkt: Die Dokumentation enthält die Basis-URLs, und das Beispielmodell ist DeepSeek-V4-Flash (ID deepseek-, 380K Kontext, bis zu 32.768 Ausgabe-Tokens pro Antwort, ein Preis zu jeder Stunde — siehe die Modellseite).
Was eine 200 wirklich verspricht#
Stellen Sie sich einen Kurier vor, der an der Tür ein Paket entgegennimmt: Die Unterschrift beweist, dass er angekommen ist, nicht dass das Paket intakt ist. HTTP funktioniert genauso. Der Server sendet zuerst die Statuszeile und die Header, dann trifft der Body Stück für Stück ein. Wenn das Modell-Backend auf halbem Weg überlastet wird, ist die Statuszeile bereits verschickt.
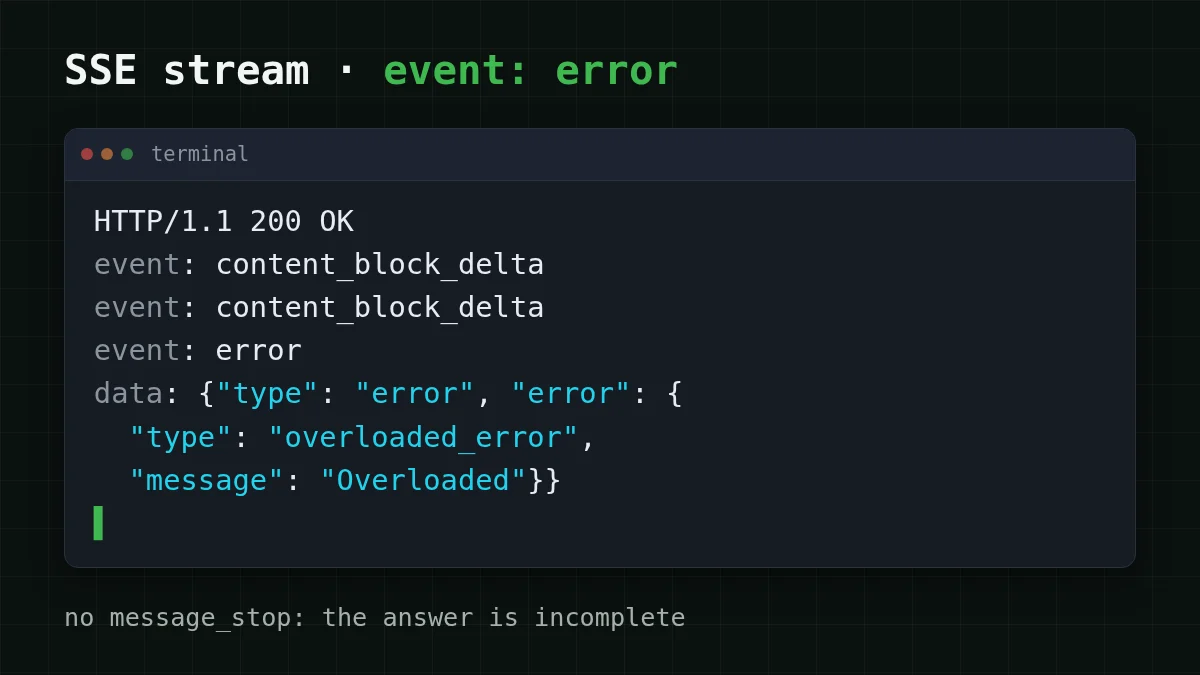
Die Fehlerseite der Anthropic-API (geprüft am 1. November 2026) sagt es direkt: Wenn Sie eine Streaming-Antwort über SSE erhalten, kann ein Fehler auftreten, nachdem die API eine 200 zurückgegeben hat, und dann greift die Standard-Fehlerbehandlung nicht. Die Streaming-Dokumentation gibt die Form dieses Events an:
event: error
data: {"type": "error", "error": {"type": "overloaded_error", "message": "Overloaded"}}
overloaded_error entspricht normalerweise HTTP 529 bei einem Nicht-Streaming-Aufruf (vorübergehende Überlastung durch hohen Traffic). Dieselbe Seite listet 500 api_error (Retry mit exponentiellem Backoff) und 504 timeout_error (Streaming für lange Anfragen verwenden). Auf der Leitung sieht ein kaputter Stream so aus:
Die Dokumentation warnt außerdem, dass neue Event-Typen hinzugefügt werden können, sodass Ihr Code unbekannte Events problemlos verarbeiten sollte. Deshalb versuchen die Handler unten nicht, jedes Fehlerbyte zu erkennen. Sie stellen eine Frage: Endete der Stream mit seinem Finish-Signal?
- Anthropic Messages: Das letzte Event ist
message_stop, undstop_reasoninmessage_deltasagt, warum er endete (end_turn,max_tokens,stop_sequence). - OpenAI Chat Completions: Der letzte Chunk trägt ein nicht-leeres
finish_reason(stop,length, …).
Kein Finish-Signal oder eine Exception unterwegs — die Antwort ist unvollständig, egal was der Status gesagt hat.
In Python abfangen#
Nehmen Sie einen Support-Bot, der Antworten an den Browser streamt. Die Schleife sammelt Text in einem Puffer und meldet drei Dinge zurück: den bisherigen Text, ob der Stream beendet wurde und den Fehler, falls es einen gab. Wählen Sie den Tab für das SDK, das Sie verwenden.
Ein Handler, zwei SDKs
Anthropic SDK
import os
import anthropic

client = anthropic.Anthropic(
    base_url='https://api.cheaptokens.dev',  # no /v1 for the Anthropic SDK
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'

def ask_once(prompt, on_text=lambda t: None):
    parts, finished = [], False
    try:
        with client.messages.stream(
            model=MODEL,
            max_tokens=1024,
            messages=[{'role': 'user', 'content': prompt}],
        ) as stream:
            for event in stream:
                if event.type == 'content_block_delta' and event.delta.type == 'text_delta':
                    parts.append(event.delta.text)
                    on_text(event.delta.text)
                elif event.type == 'message_stop':
                    finished = True
    except anthropic.APIError as err:
        return ''.join(parts), False, err
    return ''.join(parts), finished, None
OpenAI SDK
import os
import openai

client = openai.OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'

def ask_once(prompt, on_text=lambda t: None):
    parts, finish = [], None
    try:
        stream = client.chat.completions.create(
            model=MODEL,
            max_tokens=1024,
            stream=True,
            messages=[{'role': 'user', 'content': prompt}],
        )
        for chunk in stream:
            if not chunk.choices:
                continue
            choice = chunk.choices[0]
            if choice.delta.content:
                parts.append(choice.delta.content)
                on_text(choice.delta.content)
            if choice.finish_reason:
                finish = choice.finish_reason
    except openai.APIError as err:
        return ''.join(parts), False, err
    return ''.join(parts), finish is not None, None
Zwei Details verdienen einen zweiten Blick. Erstens fangen beide Handler die Basis-Fehlerklasse des SDK ab (anthropic., openai.APIError), sodass es egal ist, welche Unterklasse das SDK für einen bestimmten Fehler wirft. Zweitens ist das Flag finished von der Exception getrennt: Ein Stream kann auch einfach früh enden, ganz ohne Exception, und dieser Fall muss ebenfalls als Fehler zählen.
Die README von openai-python ergänzt, was auf der OpenAI-Seite zu erwarten ist (geprüft am 1. November 2026): Ein Read-Timeout in einem Stream wirft APITimeoutError, andere HTTPX-Fehler werfen APIConnectionError mit der ursprünglichen Exception in __cause__. Wenn der Stream hängt statt fehlzuschlagen, siehe Timeouts und Retries im OpenAI Python SDK.
Retry ohne die Antwort doppelt auszugeben#
Hier ist ein Bug, der leicht ausgeliefert wird. Ein erster Versuch gibt „Die Rückerstattungsrichtlinie ist…“ aus, stirbt, der Retry beginnt von vorn und gibt „Die Rückerstattungsrichtlinie ist…“ erneut aus — jetzt sieht der Nutzer den Anfang zweimal oder einen Satz, der an seinen eigenen Neustart geklebt ist. Die übliche Ursache ist ein gemeinsamer Puffer: answer += text lebt außerhalb des Versuchs, sodass der zweite Versuch an den ersten anhängt.
Die Heilung ist langweilig. Ein Versuch besitzt einen Puffer, der Text eines fehlgeschlagenen Versuchs wird verworfen (oder nur für das Log behalten), und der Retry beginnt von vorn:
import time

def ask_with_retry(prompt, attempts=3, on_text=lambda t: None, on_restart=lambda: None):
    for attempt in range(attempts):
        text, finished, err = ask_once(prompt, on_text)
        if finished:
            return text
        status = getattr(err, 'status_code', None)
        if status is not None and 400 <= status < 500 and status not in (408, 409, 429):
            raise err  # a 400/401/404 will not fix itself
        print(f'attempt {attempt + 1} failed after {len(text)} chars: {err!r}')
        if attempt == attempts - 1:
            break
        on_restart()  # clear the message box in your UI
        time.sleep(2 ** attempt)  # 1 s, 2 s
    raise RuntimeError('stream failed after all attempts')
on_restart ist der Teil, der die Duplizierung stoppt. In einer Web-UI leert er die Nachrichtenblase, bevor der nächste Versuch hineinstreamt. In einem einfachen Terminal können Sie nicht un-printen, also geben Sie entweder erst aus, wenn finished wahr ist, oder drucken Sie eine sichtbare --- retrying ----Zeile. Ein Retry von vorn sendet den gesamten Prompt erneut, sodass die Eingabe für den neuen Versuch erneut berechnet wird; für die meisten Chat-Antworten ist das ein fairer Preis für eine saubere Antwort.
In die richtige Reihenfolge bringen
Bringen Sie die Retry-Schritte in die Reihenfolge, in der Ihr Code sie ausführen soll
Ziehe die Elemente oder benutze die Pfeile
- Den kaputten Stream nicht mehr lesen und seinen Teiltext für das Log behalten
- Den Fehler prüfen: Ein 4xx außer 408, 409 und 429 bedeutet Stopp, nicht Retry
- Die Nachrichtenbox leeren und einen neuen Puffer starten
- Mit exponentiellem Backoff warten (1 s, dann 2 s)
- Die vollständige Anfrage erneut senden und nur die neue Antwort anzeigen
Das Anthropic-SDK wiederholt bereits vorübergehende Fehler — Verbindungsfehler, Rate Limits, 5xx — mit exponentiellem Backoff, standardmäßig 2-mal, unter Beachtung von retry-after, und max_retries ändert das. Das deckt die Anfrage ab. Ein Stream, der nach der 200 stirbt, ist eine andere Geschichte: Die Dokumentation sagt, dass die Standard-Fehlerbehandlung dort nicht greift, also bleibt die obige Schleife Ihre Aufgabe. Für 429 allein gibt es eine separate Anleitung: 429 Too Many Requests: Retries mit Backoff.
Nicht jeder frühe Stopp ist ein Fehler#
Bevor Sie einen Retry machen, prüfen Sie, warum die Antwort endete. Ein Stream, der mit stop_ (Anthropic) oder finish_ (OpenAI) endet, ist beendet — er hat nur das von Ihnen gesetzte Limit erreicht. Ein Retry liefert denselben abgeschnittenen Text und dieselbe Rechnung. Erhöhen Sie stattdessen das Limit; der Leitfaden zur abgeschnittenen Antwort führt Sie durch.
Es gibt eine dritte Gruppe: das Netzwerk. Idle-Verbindungen können unterwegs verworfen werden, was sich als Verbindungsfehler oder als Stream zeigt, der ohne jegliches Event stoppt. Behandeln Sie das wie einen Mid-Stream-Fehler, und sehen Sie sich häufige Verbindungsfehler an, wenn es weiterhin passiert. Für lange Generierungen empfiehlt Anthropic Streaming gegenüber einem riesigen Nicht-Streaming-max_tokens, sodass Sie in dieser Hinsicht bereits auf der richtigen Seite sind.
Bevor Sie ausliefern#
Speichern Sie die Request-ID jedes fehlgeschlagenen Versuchs. Anthropic-Fehlerbodys tragen ein Feld request_id und einen Response-Header request-id, und das Python-SDK stellt message. bereit; mit dieser ID ist ein Fehler nachvollziehbar statt anekdotisch.
Checkliste
Streaming-Fehlerbehandlung, richtig gemacht
Wenn Sie den Handler laufen sehen möchten, richten Sie ihn auf Ihren eigenen Key: einen API-Key in der Dokumentation erstellen, CHEAPTOKENS_ setzen und ask_ aufrufen. Für die Grundlagen des Streamings in Python beginnen Sie mit Streaming-Antworten in Python; die Anthropic-Seite wird in dem Anthropic Python SDK mit CheapTokens behandelt.