การแก้ไขปัญหาคู่มือ
สตรีมล้มเหลวหลัง HTTP 200: จับข้อผิดพลาดกลางสตรีมใน Python
ทำไมสตรีมถึงพังหลังสถานะ 200, วิธีสังเกต event: error, และการลองใหม่ใน Python ที่เก็บข้อความบางส่วนไว้โดยไม่ทำคำตอบซ้ำ
ในหน้านี้
UI แชทของคุณสตรีมคำตอบได้ครึ่งเดียวแล้วค้าง และล็อกบอกว่า 200 OK นั่นไม่ใช่ความขัดแย้ง: 200 บอกแค่ว่าสตรีมเริ่มแล้ว ไม่ได้บอกว่าจบแล้ว ถ้ามีอะไรพังภายหลัง เซิร์ฟเวอร์ทำได้เพียงส่ง error ภายใน สตรีม ดังนั้นการตรวจสอบสถานะโค้ดจึงไม่มีทางเห็นมัน วิธีแก้คือถือว่าสตรีมสำเร็จก็ต่อเมื่อมันจบด้วยสัญญาณสิ้นสุด และให้ลองใหม่จากบัฟเฟอร์ที่สะอาดเมื่อมันไม่จบ
ส่วนที่เหลือของหน้านี้แสดงให้เห็นว่าสตรีมที่พังหน้าตาเป็นอย่างไร, ตัวจัดการ Python สองตัว (Anthropic Messages และ OpenAI SDK), และการลองใหม่ที่ไม่พิมพ์ต้นคำตอบซ้ำสองครั้ง ตัวจัดการทั้งสองใช้ CheapTokens เป็น API endpoint: เอกสาร มี base URL และโมเดลตัวอย่างคือ DeepSeek-V4-Flash (id deepseek-, context 380K, เอาต์พุตสูงสุด 32,768 โทเคนต่อคำตอบ, ราคาเดียวทุกชั่วโมง — ดูหน้ารุ่น)
200 สัญญาอะไรจริง ๆ#
ลองนึกถึงพนักงานส่งของที่เซ็นรับพัสดุที่หน้าประตู: ลายเซ็นพิสูจน์ว่าเขามาถึง ไม่ได้พิสูจน์ว่าพัสดุสมบูรณ์ HTTP ก็ทำงานแบบเดียวกัน เซิร์ฟเวอร์ส่งสถานะและเฮดเดอร์ก่อน จากนั้นบอดี้ค่อย ๆ มาทีละส่วน ถ้าแบ็กเอนด์ของโมเดลโอเวอร์โหลดกลางทาง สถานะก็ถูกส่งไปแล้ว
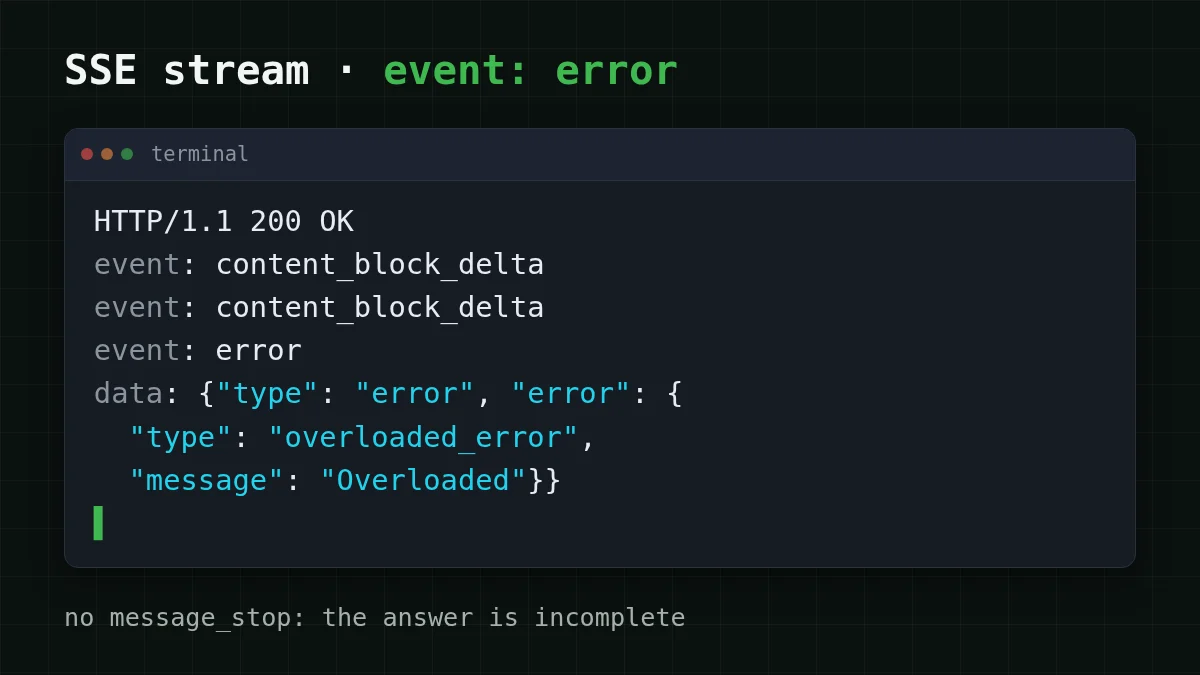
หน้าข้อผิดพลาดของ Anthropic API (ตรวจสอบเมื่อ 1 พฤศจิกายน 2026) บอกไว้ตรง ๆ ว่า: เมื่อคุณได้รับสตรีมมิ่งรีสปอนส์ผ่าน SSE ข้อผิดพลาดสามารถเกิดขึ้นได้หลังจาก API คืน 200 และการจัดการข้อผิดพลาดมาตรฐานใช้ไม่ได้ในกรณีนั้น เอกสารสตรีมมิ่งของพวกเขาให้รูปแบบของอีเวนต์นั้น:
event: error
data: {"type": "error", "error": {"type": "overloaded_error", "message": "Overloaded"}}
overloaded_error ปกติสอดคล้องกับ HTTP 529 ในการเรียกแบบไม่สตรีม (โอเวอร์โหลดชั่วคราวจากทราฟฟิกสูง) หน้าเดียวกันยังระบุ 500 api_error (ลองใหม่ด้วย exponential backoff) และ 504 timeout_error (ใช้สตรีมมิ่งสำหรับคำขอที่ยาวนาน) บนสาย สตรีมที่พังมีหน้าตาแบบนี้:
เอกสารยังเตือนว่าอาจมีอีเวนต์ชนิดใหม่เพิ่มเข้ามา ดังนั้นโค้ดของคุณควรจัดการอีเวนต์ที่ไม่รู้จักอย่างราบรื่น นั่นคือเหตุผลที่ตัวจัดการด้านล่างไม่พยายามจดจำไบต์ข้อผิดพลาดทุกตัว พวกมันถามคำถามเดียว: สตรีมจบด้วยสัญญาณสิ้นสุดหรือไม่?
- Anthropic Messages: อีเวนต์สุดท้ายคือ
message_stopและstop_reasonในmessage_deltaบอกว่าจบเพราะอะไร (end_turn,max_tokens,stop_sequence) - OpenAI Chat Completions: ชังก์สุดท้ายมี
finish_reasonที่ไม่ว่าง (stop,length, …)
ไม่มีสัญญาณสิ้นสุด หรือมีข้อยกเว้นระหว่างทาง — คำตอบไม่สมบูรณ์ ไม่ว่าสถานะจะบอกอะไรก็ตาม
จับมันใน Python#
ลองใช้บอทซัพพอร์ตที่สตรีมคำตอบไปยังเบราว์เซอร์ ลูปเก็บข้อความลงบัฟเฟอร์และรายงานกลับสามอย่าง: ข้อความจนถึงตอนนี้, สตรีมจบหรือไม่, และข้อผิดพลาดถ้ามี เลือกแท็บสำหรับ SDK ที่คุณใช้
ตัวจัดการเดียว สอง SDK
Anthropic SDK
import os
import anthropic

client = anthropic.Anthropic(
    base_url='https://api.cheaptokens.dev',  # no /v1 for the Anthropic SDK
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'

def ask_once(prompt, on_text=lambda t: None):
    parts, finished = [], False
    try:
        with client.messages.stream(
            model=MODEL,
            max_tokens=1024,
            messages=[{'role': 'user', 'content': prompt}],
        ) as stream:
            for event in stream:
                if event.type == 'content_block_delta' and event.delta.type == 'text_delta':
                    parts.append(event.delta.text)
                    on_text(event.delta.text)
                elif event.type == 'message_stop':
                    finished = True
    except anthropic.APIError as err:
        return ''.join(parts), False, err
    return ''.join(parts), finished, None
OpenAI SDK
import os
import openai

client = openai.OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'

def ask_once(prompt, on_text=lambda t: None):
    parts, finish = [], None
    try:
        stream = client.chat.completions.create(
            model=MODEL,
            max_tokens=1024,
            stream=True,
            messages=[{'role': 'user', 'content': prompt}],
        )
        for chunk in stream:
            if not chunk.choices:
                continue
            choice = chunk.choices[0]
            if choice.delta.content:
                parts.append(choice.delta.content)
                on_text(choice.delta.content)
            if choice.finish_reason:
                finish = choice.finish_reason
    except openai.APIError as err:
        return ''.join(parts), False, err
    return ''.join(parts), finish is not None, None
มีสองรายละเอียดที่ควรดูอีกครั้ง อย่างแรก ตัวจัดการทั้งสองจับคลาส base ของข้อผิดพลาดใน SDK (anthropic., openai.APIError) ดังนั้นจึงไม่สำคัญว่า SDK จะโยนคลาสย่อยใดสำหรับความล้มเหลวหนึ่ง ๆ อย่างที่สอง แฟล็ก finished แยกจากข้อยกเว้น: สตรีมอาจจบก่อนกำหนดโดยไม่มีข้อยกเว้นเลยก็ได้ และกรณีนั้นต้องนับเป็นความล้มเหลวด้วย
README ของ openai-python เสริมสิ่งที่ควรคาดหวังฝั่ง OpenAI (ตรวจสอบเมื่อ 1 พฤศจิกายน 2026): read timeout ในสตรีมจะโยน APITimeoutError, ความล้มเหลว HTTPX อื่น ๆ โยน APIConnectionError พร้อมข้อยกเว้นดั้งเดิมใน __cause__ ถ้าสตรีมค้างแทนที่จะล้มเหลว ดูtimeouts และ retries ใน OpenAI Python SDK
ลองใหม่โดยไม่พิมพ์คำตอบซ้ำ#
นี่คือบั๊กที่พลาดง่ายมาก ความพยายามครั้งแรกพิมพ์ "นโยบายการคืนเงินคือ…" แล้วตาย การลองใหม่เริ่มต้นใหม่และพิมพ์ "นโยบายการคืนเงินคือ…" อีกครั้ง — ตอนนี้ผู้ใช้เห็นต้นข้อความสองครั้ง หรือประโยคที่ต่อกับจุดเริ่มต้นของตัวเอง สาเหตุปกติคือบัฟเฟอร์ที่ใช้ร่วมกัน: answer += text อยู่นอกความพยายาม ดังนั้นครั้งที่สองจึงต่อท้ายครั้งแรก
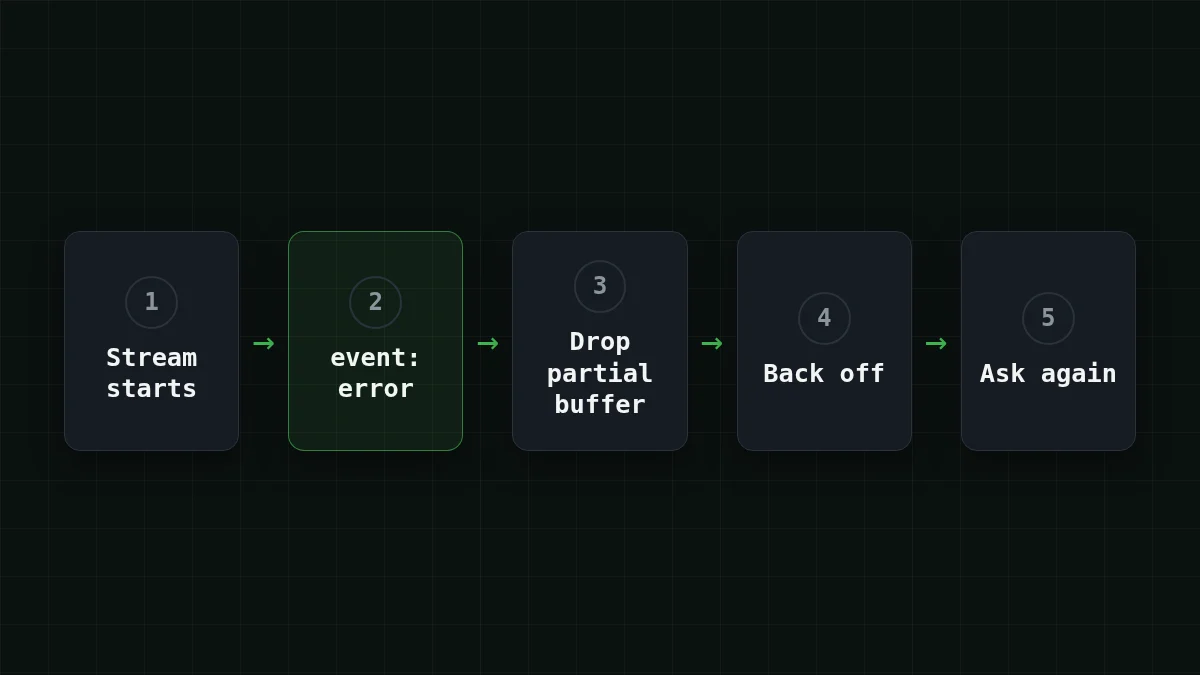
วิธีแก้ไม่น่าตื่นเต้น ความพยายามหนึ่งครั้งเป็นเจ้าของบัฟเฟอร์หนึ่งอัน ข้อความจากความพยายามที่ล้มเหลวถูกทิ้ง (หรือเก็บไว้แค่ในล็อก) และการลองใหม่เริ่มจากศูนย์:
import time

def ask_with_retry(prompt, attempts=3, on_text=lambda t: None, on_restart=lambda: None):
    for attempt in range(attempts):
        text, finished, err = ask_once(prompt, on_text)
        if finished:
            return text
        status = getattr(err, 'status_code', None)
        if status is not None and 400 <= status < 500 and status not in (408, 409, 429):
            raise err  # a 400/401/404 will not fix itself
        print(f'attempt {attempt + 1} failed after {len(text)} chars: {err!r}')
        if attempt == attempts - 1:
            break
        on_restart()  # clear the message box in your UI
        time.sleep(2 ** attempt)  # 1 s, 2 s
    raise RuntimeError('stream failed after all attempts')
on_restart คือส่วนที่หยุดการซ้ำ ใน UI เว็บ มันล้างกล่องข้อความก่อนที่ความพยายามถัดไปจะสตรีมเข้ามา ในเทอร์มินัลธรรมดาคุณลบที่พิมพ์ไปแล้วไม่ได้ ดังนั้นพิมพ์เฉพาะเมื่อ finished เป็นจริง หรือพิมพ์บรรทัด --- retrying --- ที่มองเห็นได้ การลองใหม่จากศูนย์ส่งพรอมป์ทั้งหมดซ้ำ ดังนั้นอินพุตจะถูกคิดเงินอีกครั้งสำหรับความพยายามใหม่ สำหรับคำตอบแชทส่วนใหญ่ นั่นเป็นราคาที่สมเหตุสมผลเพื่อคำตอบที่สะอาด
เรียงลำดับ
เรียงลำดับขั้นตอนการลองใหม่ตามลำดับที่โค้ดควรทำ
ลากรายการหรือใช้ลูกศร
- หยุดอ่านสตรีมที่พังและเก็บข้อความบางส่วนไว้ในล็อก
- ตรวจสอบข้อผิดพลาด: 4xx อื่นที่ไม่ใช่ 408, 409 และ 429 หมายถึงหยุด ไม่ใช่ลองใหม่
- ล้างกล่องข้อความและเริ่มบัฟเฟอร์ใหม่
- รอด้วย exponential backoff (1 วินาที แล้ว 2 วินาที)
- ส่งคำขอทั้งหมดอีกครั้งและแสดงเฉพาะคำตอบใหม่
SDK ของ Anthropic ลองใหม่ความล้มเหลวชั่วคราวอยู่แล้ว — connection error, rate limit, 5xx — ด้วย exponential backoff, ค่าเริ่มต้น 2 ครั้ง, เคารพ retry-after และ max_retries เปลี่ยนค่านั้น นั่นครอบคลุมตัวคำขอ สตรีมที่ตายหลัง 200 เป็นอีกเรื่อง: เอกสารบอกว่าการจัดการข้อผิดพลาดมาตรฐานใช้ไม่ได้ที่นั่น ดังนั้นลูปด้านบนจึงเป็นของคุณเอง สำหรับ 429 โดยเฉพาะ มีคำแนะนำแยก: 429 Too Many Requests: retries with backoff
ไม่ใช่ทุกการหยุดก่อนกำหนดที่เป็นข้อผิดพลาด#
ก่อนลองใหม่ ให้ตรวจสอบว่าคำตอบจบเพราะอะไร สตรีมที่จบด้วย stop_ (Anthropic) หรือ finish_ (OpenAI) จบแล้วจริง ๆ — มันแค่ชนขีดจำกัดที่คุณตั้งไว้ การลองใหม่จะได้ข้อความที่ถูกตัดเหมือนเดิมและบิลเท่าเดิม เพิ่มขีดจำกัดแทน; คู่มือคำตอบที่ถูกตัด อธิบายไว้
มีกลุ่มที่สาม: เครือข่าย การเชื่อมต่อที่ไม่ได้ใช้งานอาจถูกตัดระหว่างทาง ซึ่งแสดงเป็น connection error หรือสตรีมที่หยุดโดยไม่มีอีเวนต์ใด ๆ จัดการเหมือนข้อผิดพลาดกลางสตรีม และดูข้อผิดพลาดการเชื่อมต่อที่พบบ่อย ถ้ามันเกิดขึ้นซ้ำ สำหรับการสร้างที่ยาวนาน Anthropic แนะนำให้สตรีมมิ่งแทน max_tokens แบบไม่สตรีมขนาดใหญ่ ดังนั้นคุณอยู่ในด้านที่ถูกต้องแล้ว
ก่อนปล่อย#
บันทึก request id ของทุกความพยายามที่ล้มเหลว บอดี้ข้อผิดพลาดของ Anthropic มีฟิลด์ request_id และเฮดเดอร์รีสปอนส์ request-id และ Python SDK เปิดเผย message.; ด้วย id นั้น ความล้มเหลวจึงตรวจสอบย้อนกลับได้แทนที่จะเป็นแค่เรื่องเล่า
เช็กลิสต์
การจัดการข้อผิดพลาดสตรีมมิ่ง ทำให้ถูกต้อง
ถ้าอยากเห็นตัวจัดการทำงาน ให้ชี้ไปที่คีย์ของคุณเอง: สร้าง API key ในเอกสาร, ตั้งค่า CHEAPTOKENS_, และเรียก ask_ สำหรับพื้นฐานของสตรีมมิ่งใน Python เริ่มที่สตรีมมิ่งรีสปอนส์ใน Python; ฝั่ง Anthropic ครอบคลุมในAnthropic Python SDK กับ CheapTokens