El stream falló después de HTTP 200: captura errores a mitad de stream en Python
Por qué un stream puede romperse después de un estado 200, cómo detectar event: error y un reintento en Python que conserva el texto parcial sin duplicar la respuesta.
En esta página
Tu interfaz de chat transmitió media respuesta, se congeló y el log dice 200 OK. No es una contradicción: el 200 solo indica que el stream comenzó, no que terminó. Si algo falla después, el servidor solo puede enviar un error dentro del stream, así que una comprobación del código de estado nunca lo ve. La solución es tratar un stream como exitoso solo cuando termina con su señal de finalización, y reintentar desde un búfer limpio cuando no lo hace.
El resto de esta página muestra cómo se ve el stream roto, dos handlers de Python (Anthropic Messages y OpenAI SDK) y un reintento que no imprime el inicio de la respuesta dos veces. Ambos handlers usan CheapTokens como endpoint de la API: la documentación tiene las URL base, y el modelo de ejemplo es DeepSeek-V4-Flash (id deepseek-, contexto de 380K, hasta 32.768 tokens de salida por respuesta, un precio a cualquier hora — consulta la página del modelo).
Qué promete realmente un 200#
Piensa en un mensajero que firma un paquete en la puerta: la firma demuestra que llegó, no que el paquete esté intacto. HTTP funciona igual. El servidor envía primero la línea de estado y las cabeceras, y luego el cuerpo llega pieza a pieza. Si el backend del modelo se sobrecarga a mitad de camino, la línea de estado ya se envió.
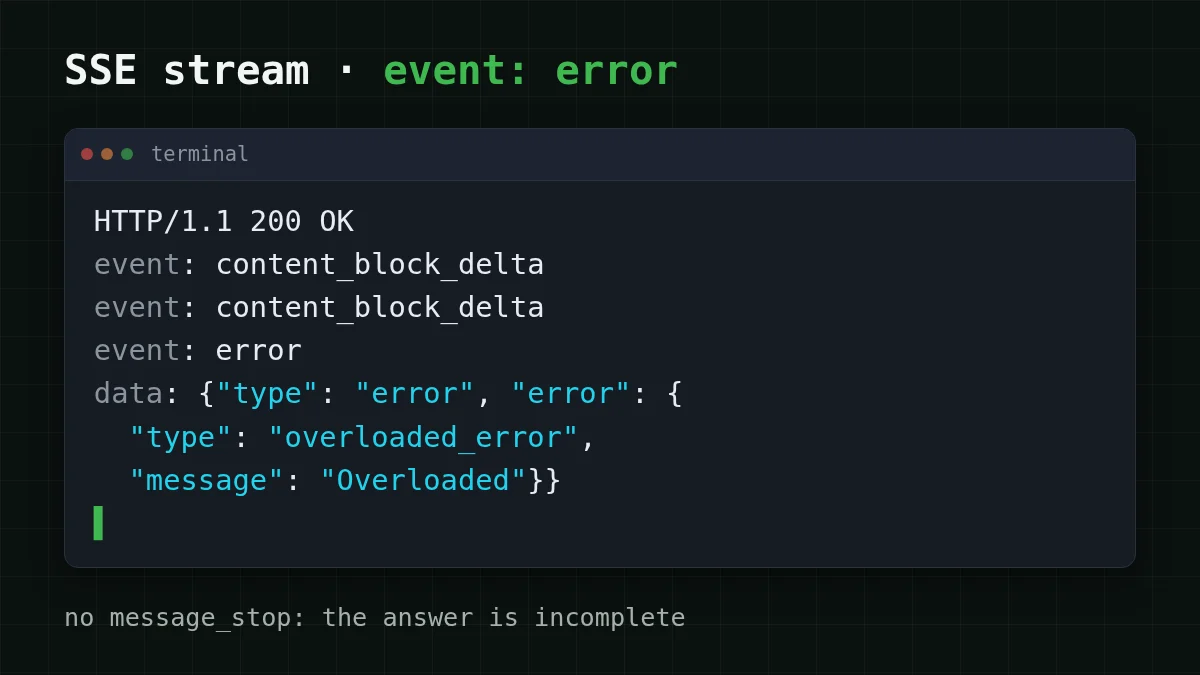
La página de errores de la API de Anthropic (consultada el 1 de noviembre de 2026) lo dice directamente: cuando recibes una respuesta en streaming por SSE, puede ocurrir un error después de que la API devuelva un 200, y entonces el manejo de errores estándar no aplica. Su documentación de streaming da la forma de ese evento:
event: error
data: {"type": "error", "error": {"type": "overloaded_error", "message": "Overloaded"}}
overloaded_error normalmente corresponde a HTTP 529 en una llamada sin streaming (sobrecarga temporal por tráfico alto). La misma página lista 500 api_error (reintentar con backoff exponencial) y 504 timeout_error (usar streaming para peticiones largas). En la red, un stream roto se ve así:
La documentación también advierte que pueden añadirse nuevos tipos de evento, así que tu código debe manejar los eventos desconocidos con elegancia. Por eso los handlers de abajo no intentan reconocer cada byte de error. Hacen una sola pregunta: ¿terminó el stream con su señal de finalización?
- Anthropic Messages: el último evento es
message_stop, ystop_reasonenmessage_deltaindica por qué terminó (end_turn,max_tokens,stop_sequence). - OpenAI Chat Completions: el último chunk lleva un
finish_reasonno vacío (stop,length, …).
Sin señal de finalización, o con una excepción en el camino — la respuesta está incompleta, diga lo que diga el estado.
Detéctalo en Python#
Toma un bot de soporte que transmite respuestas al navegador. El bucle recopila texto en un búfer y devuelve tres cosas: el texto hasta ahora, si el stream terminó y el error si lo hubo. Elige la pestaña del SDK que uses.
Un handler, dos SDK
SDK de Anthropic
import os
import anthropic

client = anthropic.Anthropic(
    base_url='https://api.cheaptokens.dev',  # no /v1 for the Anthropic SDK
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'

def ask_once(prompt, on_text=lambda t: None):
    parts, finished = [], False
    try:
        with client.messages.stream(
            model=MODEL,
            max_tokens=1024,
            messages=[{'role': 'user', 'content': prompt}],
        ) as stream:
            for event in stream:
                if event.type == 'content_block_delta' and event.delta.type == 'text_delta':
                    parts.append(event.delta.text)
                    on_text(event.delta.text)
                elif event.type == 'message_stop':
                    finished = True
    except anthropic.APIError as err:
        return ''.join(parts), False, err
    return ''.join(parts), finished, None
SDK de OpenAI
import os
import openai

client = openai.OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'

def ask_once(prompt, on_text=lambda t: None):
    parts, finish = [], None
    try:
        stream = client.chat.completions.create(
            model=MODEL,
            max_tokens=1024,
            stream=True,
            messages=[{'role': 'user', 'content': prompt}],
        )
        for chunk in stream:
            if not chunk.choices:
                continue
            choice = chunk.choices[0]
            if choice.delta.content:
                parts.append(choice.delta.content)
                on_text(choice.delta.content)
            if choice.finish_reason:
                finish = choice.finish_reason
    except openai.APIError as err:
        return ''.join(parts), False, err
    return ''.join(parts), finish is not None, None
Dos detalles merecen una segunda mirada. Primero, ambos handlers capturan la clase de error base del SDK (anthropic., openai.APIError), así que da igual qué subclase lance el SDK para un fallo concreto. Segundo, el flag finished es independiente de la excepción: un stream también puede terminar antes de tiempo, sin ninguna excepción, y ese caso también debe contar como fallo.
El README de openai-python añade qué esperar en el lado de OpenAI (consultado el 1 de noviembre de 2026): un timeout de lectura en un stream lanza APITimeoutError, otros fallos de HTTPX lanzan APIConnectionError con la excepción original en __cause__. Si el stream se queda colgado en lugar de fallar, consulta timeouts y reintentos en el SDK de OpenAI para Python.
Reintenta sin imprimir la respuesta dos veces#
Aquí hay un bug fácil de publicar. Un primer intento imprime "La política de reembolso es…", muere, el reintento empieza de nuevo e imprime "La política de reembolso es…" otra vez — ahora el usuario ve el inicio dos veces, o una frase pegada a su propio reinicio. La causa habitual es un búfer compartido: answer += text vive fuera del intento, así que el segundo intento se añade al primero.
La cura es aburrida. Un intento posee un búfer, el texto de un intento fallido se descarta (o se guarda solo para el log), y el reintento empieza desde cero:
import time

def ask_with_retry(prompt, attempts=3, on_text=lambda t: None, on_restart=lambda: None):
    for attempt in range(attempts):
        text, finished, err = ask_once(prompt, on_text)
        if finished:
            return text
        status = getattr(err, 'status_code', None)
        if status is not None and 400 <= status < 500 and status not in (408, 409, 429):
            raise err  # a 400/401/404 will not fix itself
        print(f'attempt {attempt + 1} failed after {len(text)} chars: {err!r}')
        if attempt == attempts - 1:
            break
        on_restart()  # clear the message box in your UI
        time.sleep(2 ** attempt)  # 1 s, 2 s
    raise RuntimeError('stream failed after all attempts')
on_restart es la parte que evita el duplicado. En una interfaz web vacía la burbuja del mensaje antes de que el siguiente intento se transmita. En una terminal simple no puedes desimprimir, así que imprime solo cuando finished sea true, o imprime una línea visible de --- retrying ---. Reintentar desde cero reenvía todo el prompt, así que la entrada se factura de nuevo para el nuevo intento; para la mayoría de respuestas de chat es un precio justo por una respuesta limpia.
Poner en orden
Ordena los pasos del reintento en el orden en que tu código debería ejecutarlos
Arrastra los elementos o usa las flechas
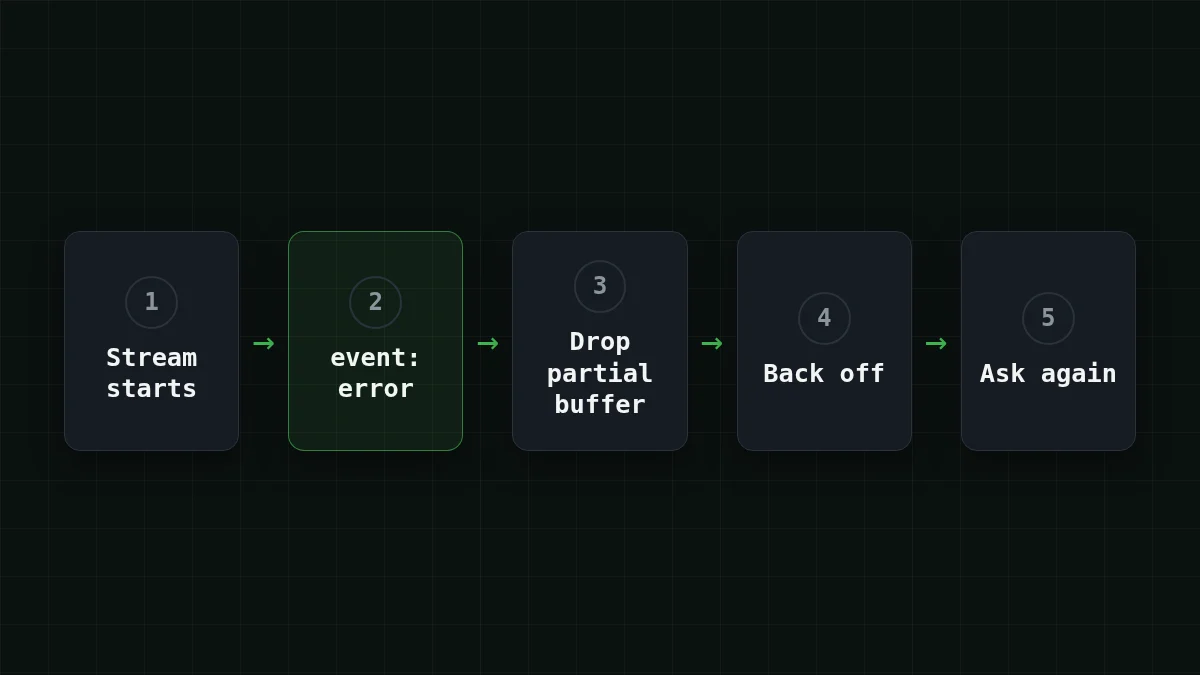
- Deja de leer el stream roto y guarda su texto parcial para el log
- Comprueba el error: un 4xx distinto de 408, 409 y 429 significa parar, no reintentar
- Limpia el cuadro de mensaje y empieza un búfer nuevo
- Espera con backoff exponencial (1 s, luego 2 s)
- Envía la petición completa de nuevo y muestra solo la nueva respuesta
El SDK de Anthropic ya reintenta fallos transitorios — errores de conexión, límites de tasa, 5xx — con backoff exponencial, 2 veces por defecto, respetando retry-after, y max_retries cambia eso. Eso cubre la petición. Un stream que muere después del 200 es otra historia: la documentación dice que el manejo de errores estándar no aplica ahí, así que el bucle de arriba es tuyo para mantenerlo. Para el 429 por sí solo, hay un recorrido aparte: 429 Too Many Requests: reintentos con backoff.
No toda parada temprana es un error#
Antes de reintentar, comprueba por qué terminó la respuesta. Un stream que termina con stop_ (Anthropic) o finish_ (OpenAI) sí terminó — solo alcanzó el límite que fijaste. Reintentarlo devuelve el mismo texto cortado y la misma factura. Sube el límite en su lugar; la guía de respuestas cortadas lo explica paso a paso.
Hay un tercer grupo: la red. Las conexiones inactivas pueden caerse por el camino, lo que aparece como un error de conexión o un stream que se detiene sin ningún evento. Trátalo igual que un error a mitad de stream, y consulta errores de conexión comunes si sigue ocurriendo. Para generaciones largas, Anthropic recomienda streaming en lugar de un max_tokens enorme sin streaming, así que ya estás del lado correcto.
Antes de publicar#
Guarda el id de petición de cada intento fallido. Los cuerpos de error de Anthropic llevan un campo request_id y una cabecera de respuesta request-id, y el SDK de Python expone message.; con ese id un fallo es rastreable en lugar de anecdótico.
Lista de verificación
Manejo de errores de streaming, bien hecho
Si quieres ver el handler en acción, apúntalo a tu propia clave: crea una clave de API en la documentación, define CHEAPTOKENS_ y llama a ask_. Para lo básico del streaming en Python, empieza por respuestas en streaming en Python; el lado de Anthropic se cubre en el SDK de Anthropic para Python con CheapTokens.