Khắc phục sự cốHướng dẫn
Stream thất bại sau HTTP 200: bắt lỗi giữa stream trong Python
Tại sao một stream có thể hỏng sau mã trạng thái 200, cách phát hiện event: error, và một lần thử lại bằng Python giữ văn bản một phần mà không nhân đôi câu trả lời.
Trên trang này
Giao diện chat của bạn đã stream một nửa câu trả lời, bị treo, và log ghi 200 OK. Đó không phải là mâu thuẫn: mã 200 chỉ nói rằng stream đã bắt đầu, không phải rằng nó đã kết thúc. Nếu có sự cố xảy ra sau đó, server chỉ có thể gửi lỗi bên trong stream, nên việc kiểm tra mã trạng thái sẽ không bao giờ thấy được. Cách khắc phục là chỉ coi một stream là thành công khi nó kết thúc bằng tín hiệu hoàn tất, và thử lại từ bộ đệm sạch khi nó không kết thúc như vậy.
Phần còn lại của trang này cho thấy stream bị lỗi trông như thế nào, hai handler Python (Anthropic Messages và OpenAI SDK), và một lần thử lại không in phần đầu của câu trả lời hai lần. Cả hai handler đều dùng CheapTokens làm endpoint API: tài liệu có các base URL, và model mẫu là DeepSeek-V4-Flash (id deepseek-, ngữ cảnh 380K, tối đa 32.768 token đầu ra mỗi câu trả lời, một mức giá bất kể giờ nào — xem trang model).
Mã 200 thực sự hứa gì#
Hãy nghĩ đến một người giao hàng ký nhận gói hàng ở cửa: chữ ký chứng minh anh ta đã đến, không phải gói hàng còn nguyên vẹn. HTTP hoạt động theo cách tương tự. Server gửi dòng trạng thái và header trước, sau đó body đến từng phần một. Nếu backend model bị quá tải giữa chừng, dòng trạng thái đã được gửi đi rồi.
Trang lỗi API của Anthropic (kiểm tra ngày 1 tháng 11 năm 2026) nói thẳng: khi bạn nhận được phản hồi streaming qua SSE, lỗi có thể xảy ra sau khi API trả về 200, và khi đó cách xử lý lỗi tiêu chuẩn không áp dụng. Tài liệu streaming của họ đưa ra hình dạng của sự kiện đó:
event: error
data: {"type": "error", "error": {"type": "overloaded_error", "message": "Overloaded"}}
overloaded_error thường tương ứng với HTTP 529 trên một lệnh gọi không streaming (quá tải tạm thời do lưu lượng cao). Cùng trang đó liệt kê 500 api_error (thử lại với exponential backoff) và 504 timeout_error (dùng streaming cho các yêu cầu dài). Trên đường truyền, một stream bị lỗi trông như thế này:
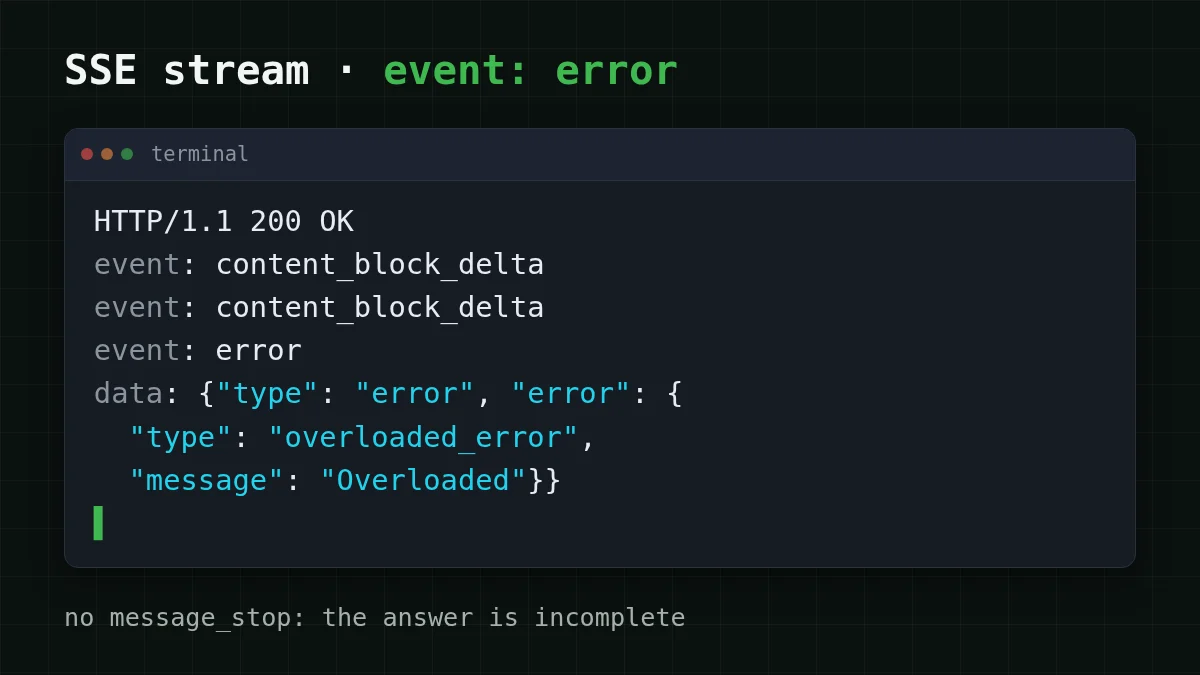
Tài liệu cũng cảnh báo rằng các loại sự kiện mới có thể được thêm vào, nên code của bạn nên xử lý các sự kiện không xác định một cách nhẹ nhàng. Đó là lý do các handler bên dưới không cố nhận diện từng byte lỗi. Chúng chỉ hỏi một câu: stream có kết thúc bằng tín hiệu hoàn tất của nó không?
- Anthropic Messages: sự kiện cuối cùng là
message_stop, vàstop_reasontrongmessage_deltacho biết lý do kết thúc (end_turn,max_tokens,stop_sequence). - OpenAI Chat Completions: chunk cuối cùng mang một
finish_reasonkhông rỗng (stop,length, …).
Không có tín hiệu hoàn tất, hoặc có ngoại lệ trên đường đi — câu trả lời là không đầy đủ, bất kể mã trạng thái nói gì.
Bắt lỗi trong Python#
Hãy lấy một bot hỗ trợ stream câu trả lời tới trình duyệt. Vòng lặp thu thập văn bản vào một bộ đệm và báo lại ba thứ: văn bản cho đến nay, stream đã hoàn tất chưa, và lỗi nếu có. Chọn tab cho SDK bạn dùng.
Một handler, hai SDK
Anthropic SDK
import os
import anthropic

client = anthropic.Anthropic(
    base_url='https://api.cheaptokens.dev',  # no /v1 for the Anthropic SDK
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'

def ask_once(prompt, on_text=lambda t: None):
    parts, finished = [], False
    try:
        with client.messages.stream(
            model=MODEL,
            max_tokens=1024,
            messages=[{'role': 'user', 'content': prompt}],
        ) as stream:
            for event in stream:
                if event.type == 'content_block_delta' and event.delta.type == 'text_delta':
                    parts.append(event.delta.text)
                    on_text(event.delta.text)
                elif event.type == 'message_stop':
                    finished = True
    except anthropic.APIError as err:
        return ''.join(parts), False, err
    return ''.join(parts), finished, None
OpenAI SDK
import os
import openai

client = openai.OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'

def ask_once(prompt, on_text=lambda t: None):
    parts, finish = [], None
    try:
        stream = client.chat.completions.create(
            model=MODEL,
            max_tokens=1024,
            stream=True,
            messages=[{'role': 'user', 'content': prompt}],
        )
        for chunk in stream:
            if not chunk.choices:
                continue
            choice = chunk.choices[0]
            if choice.delta.content:
                parts.append(choice.delta.content)
                on_text(choice.delta.content)
            if choice.finish_reason:
                finish = choice.finish_reason
    except openai.APIError as err:
        return ''.join(parts), False, err
    return ''.join(parts), finish is not None, None
Hai chi tiết đáng để xem lại. Thứ nhất, cả hai handler đều bắt lớp lỗi cơ sở của SDK (anthropic., openai.APIError), nên không quan trọng SDK ném ra lớp con nào cho một lỗi cụ thể. Thứ hai, cờ finished tách biệt với ngoại lệ: một stream cũng có thể chỉ kết thúc sớm, không có ngoại lệ nào cả, và trường hợp đó cũng phải được tính là thất bại.
README của openai-python bổ sung những gì cần mong đợi ở phía OpenAI (kiểm tra ngày 1 tháng 11 năm 2026): một read timeout trong stream sẽ ném APITimeoutError, các lỗi HTTPX khác ném APIConnectionError với ngoại lệ gốc trong __cause__. Nếu stream bị treo thay vì lỗi, xem timeout và thử lại trong OpenAI Python SDK.
Thử lại mà không in câu trả lời hai lần#
Đây là một lỗi dễ mắc phải. Lần thử đầu tiên in "Chính sách hoàn tiền là…", chết, lần thử lại bắt đầu lại và in "Chính sách hoàn tiền là…" lần nữa — giờ người dùng thấy phần đầu hai lần, hoặc một câu dính liền với phần khởi động lại của chính nó. Nguyên nhân thường gặp là một bộ đệm dùng chung: answer += text nằm ngoài lần thử, nên lần thử thứ hai nối thêm vào lần thứ nhất.
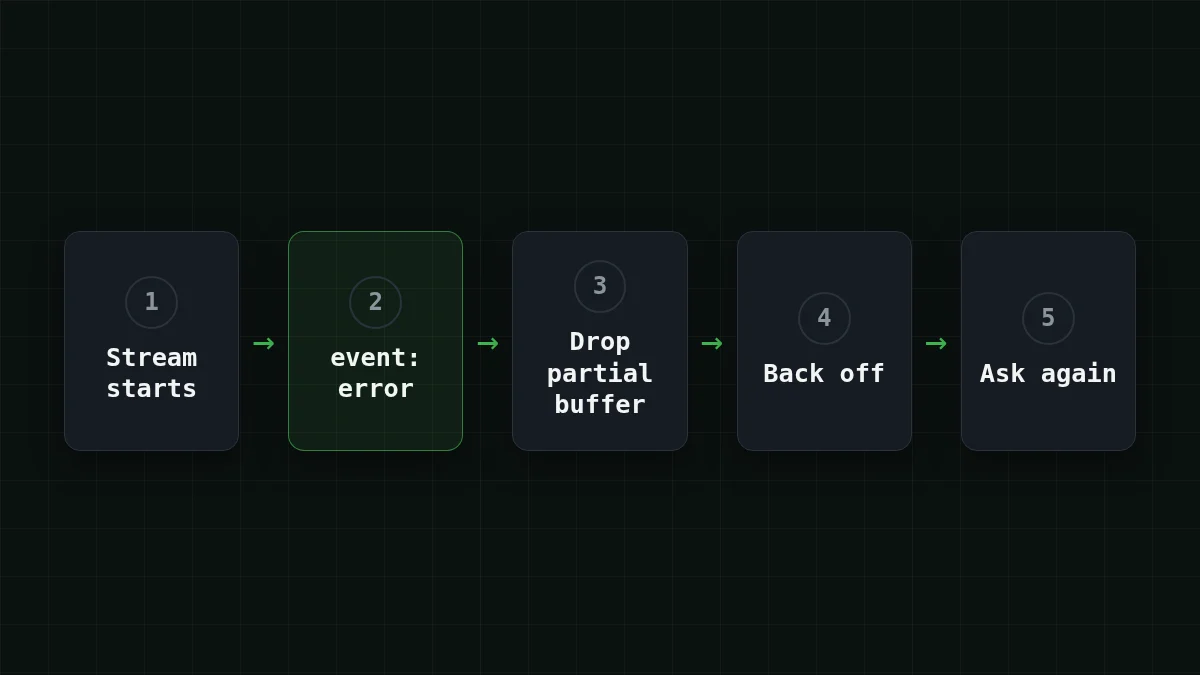
Cách chữa thì nhàm chán. Một lần thử sở hữu một bộ đệm, văn bản của lần thử thất bại bị vứt bỏ (hoặc chỉ giữ lại cho log), và lần thử lại bắt đầu từ đầu:
import time

def ask_with_retry(prompt, attempts=3, on_text=lambda t: None, on_restart=lambda: None):
    for attempt in range(attempts):
        text, finished, err = ask_once(prompt, on_text)
        if finished:
            return text
        status = getattr(err, 'status_code', None)
        if status is not None and 400 <= status < 500 and status not in (408, 409, 429):
            raise err  # a 400/401/404 will not fix itself
        print(f'attempt {attempt + 1} failed after {len(text)} chars: {err!r}')
        if attempt == attempts - 1:
            break
        on_restart()  # clear the message box in your UI
        time.sleep(2 ** attempt)  # 1 s, 2 s
    raise RuntimeError('stream failed after all attempts')
on_restart là phần ngăn chặn sự trùng lặp. Trong giao diện web, nó làm rỗng bong bóng tin nhắn trước khi lần thử tiếp theo stream vào. Trong terminal thuần, bạn không thể un-print, nên hoặc chỉ in sau khi finished là true, hoặc in một dòng --- retrying --- dễ thấy. Thử lại từ đầu sẽ gửi lại toàn bộ prompt, nên đầu vào bị tính phí lại cho lần thử mới; với hầu hết câu trả lời chat, đó là một cái giá hợp lý cho một câu trả lời sạch.
Sắp xếp thứ tự
Sắp xếp các bước thử lại theo thứ tự code của bạn nên chạy
Kéo các mục hoặc dùng mũi tên
- Dừng đọc stream bị lỗi và giữ văn bản một phần của nó cho log
- Kiểm tra lỗi: 4xx khác 408, 409 và 429 nghĩa là dừng, không thử lại
- Xóa hộp tin nhắn và bắt đầu bộ đệm mới
- Chờ với exponential backoff (1 giây, rồi 2 giây)
- Gửi lại toàn bộ yêu cầu và chỉ hiển thị câu trả lời mới
SDK của Anthropic đã tự động thử lại các lỗi tạm thời — lỗi kết nối, giới hạn tốc độ, 5xx — với exponential backoff, mặc định 2 lần, tuân theo retry-after, và max_retries thay đổi điều đó. Điều đó bao phủ yêu cầu. Một stream chết sau mã 200 là câu chuyện khác: tài liệu nói cách xử lý lỗi tiêu chuẩn không áp dụng ở đó, nên vòng lặp trên là của bạn để giữ. Riêng với 429, có một hướng dẫn riêng: 429 Too Many Requests: thử lại với backoff.
Không phải mọi lần dừng sớm đều là lỗi#
Trước khi thử lại, hãy kiểm tra lý do câu trả lời kết thúc. Một stream kết thúc với stop_ (Anthropic) hoặc finish_ (OpenAI) đã hoàn tất — nó chỉ chạm giới hạn bạn đặt. Thử lại điều đó sẽ trả về cùng văn bản bị cắt và cùng hóa đơn. Thay vào đó hãy tăng giới hạn; hướng dẫn về câu trả lời bị cắt sẽ đi qua điều đó.
Có một nhóm thứ ba: mạng. Các kết nối nhàn rỗi có thể bị ngắt trên đường đi, hiển thị dưới dạng lỗi kết nối hoặc một stream dừng mà không có sự kiện nào. Xử lý nó giống như lỗi giữa stream, và xem các lỗi kết nối thường gặp nếu nó cứ tiếp diễn. Với các thế hệ dài, Anthropic khuyến nghị streaming thay vì một max_tokens không streaming khổng lồ, nên bạn đã ở đúng phía của điều đó.
Trước khi xuất xưởng#
Lưu id yêu cầu của mỗi lần thử thất bại. Body lỗi của Anthropic mang một trường request_id và một header phản hồi request-id, và SDK Python hiển thị message.; với id đó, một lỗi có thể truy vết được thay vì chỉ là giai thoại.
Danh sách kiểm tra
Xử lý lỗi streaming, đúng cách
Nếu bạn muốn xem handler chạy, hãy trỏ nó vào key của riêng bạn: tạo API key trong tài liệu, đặt CHEAPTOKENS_, và gọi ask_. Về kiến thức cơ bản của streaming trong Python, hãy bắt đầu với phản hồi streaming trong Python; phía Anthropic được đề cập trong Anthropic Python SDK với CheapTokens.