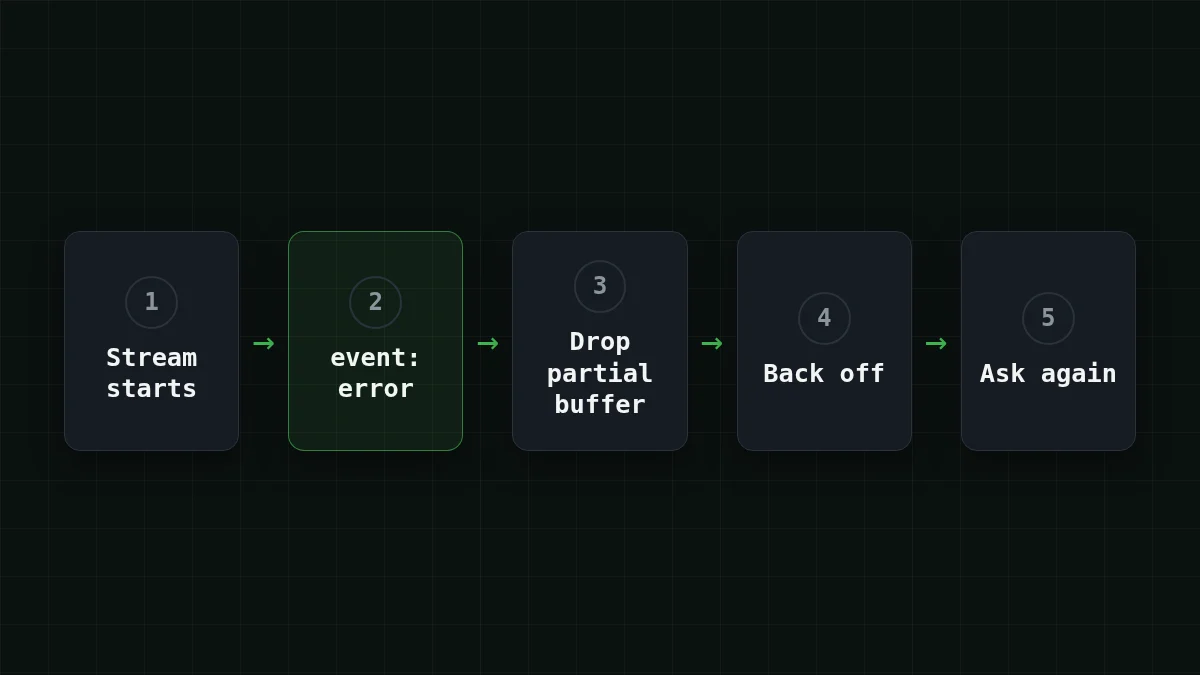
Stream fallito dopo HTTP 200: cattura gli errori a metà stream in Python
Perché uno stream può interrompersi dopo uno status 200, come individuare event: error e un retry Python che conserva il testo parziale senza duplicare la risposta.
In questa pagina
La tua chat UI ha trasmesso mezza risposta, si è bloccata e il log dice 200 OK. Non è una contraddizione: il 200 dice solo che lo stream è iniziato, non che è finito. Se qualcosa si rompe dopo, il server può inviare un errore solo all'interno dello stream, quindi un controllo sullo status code non lo vede mai. La soluzione è considerare uno stream riuscito solo quando termina con il suo segnale di fine, e riprovare da un buffer pulito quando non lo fa.
Il resto di questa pagina mostra come appare lo stream interrotto, due handler Python (Anthropic Messages e OpenAI SDK) e un retry che non stampa due volte l'inizio della risposta. Entrambi gli handler usano CheapTokens come endpoint API: la documentazione contiene le base URL, e il modello di esempio è DeepSeek-V4-Flash (id deepseek-, contesto 380K, fino a 32.768 token di output per risposta, un prezzo a qualsiasi ora — vedi la pagina del modello).
Cosa promette davvero un 200#
Pensa a un corriere che firma per un pacco alla porta: la firma prova che è arrivato, non che il pacco sia intatto. HTTP funziona allo stesso modo. Il server invia prima la status line e gli header, poi il body arriva pezzo per pezzo. Se il backend del modello si sovraccarica a metà, la status line è già andata.
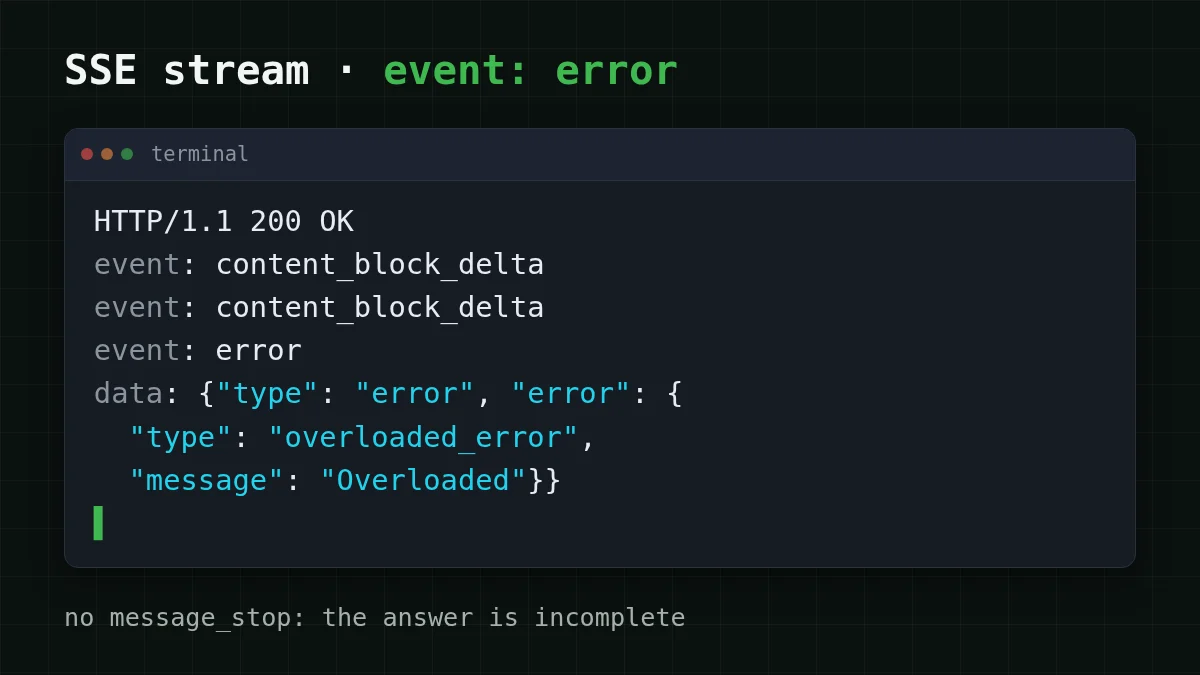
La pagina degli errori API di Anthropic (consultata il 1 novembre 2026) lo dice direttamente: quando ricevi una risposta in streaming via SSE, un errore può verificarsi dopo che l'API ha restituito un 200, e quindi la gestione standard degli errori non si applica. La sua documentazione sullo streaming fornisce la forma di quell'evento:
event: error
data: {"type": "error", "error": {"type": "overloaded_error", "message": "Overloaded"}}
overloaded_error normalmente corrisponde a HTTP 529 su una chiamata non in streaming (sovraccarico temporaneo dovuto a traffico elevato). La stessa pagina elenca 500 api_error (riprova con backoff esponenziale) e 504 timeout_error (usa lo streaming per richieste lunghe). Sulla rete uno stream interrotto appare così:
La documentazione avverte anche che potrebbero essere aggiunti nuovi tipi di evento, quindi il tuo codice dovrebbe gestire con eleganza gli eventi sconosciuti. Ecco perché gli handler qui sotto non cercano di riconoscere ogni byte di errore. Fanno una sola domanda: lo stream è terminato con il suo segnale di fine?
- Anthropic Messages: l'ultimo evento è
message_stop, estop_reasoninmessage_deltadice perché è terminato (end_turn,max_tokens,stop_sequence). - OpenAI Chat Completions: l'ultimo chunk porta un
finish_reasonnon vuoto (stop,length, …).
Nessun segnale di fine, o un'eccezione lungo il percorso — la risposta è incompleta, qualunque cosa dicesse lo status.
Catturalo in Python#
Prendi un bot di supporto che trasmette risposte al browser. Il loop raccoglie il testo in un buffer e riporta tre cose: il testo finora, se lo stream è terminato e l'errore se c'è stato. Scegli la scheda per l'SDK che usi.
Un handler, due SDK
Anthropic SDK
import os
import anthropic

client = anthropic.Anthropic(
    base_url='https://api.cheaptokens.dev',  # no /v1 for the Anthropic SDK
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'

def ask_once(prompt, on_text=lambda t: None):
    parts, finished = [], False
    try:
        with client.messages.stream(
            model=MODEL,
            max_tokens=1024,
            messages=[{'role': 'user', 'content': prompt}],
        ) as stream:
            for event in stream:
                if event.type == 'content_block_delta' and event.delta.type == 'text_delta':
                    parts.append(event.delta.text)
                    on_text(event.delta.text)
                elif event.type == 'message_stop':
                    finished = True
    except anthropic.APIError as err:
        return ''.join(parts), False, err
    return ''.join(parts), finished, None
OpenAI SDK
import os
import openai

client = openai.OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'

def ask_once(prompt, on_text=lambda t: None):
    parts, finish = [], None
    try:
        stream = client.chat.completions.create(
            model=MODEL,
            max_tokens=1024,
            stream=True,
            messages=[{'role': 'user', 'content': prompt}],
        )
        for chunk in stream:
            if not chunk.choices:
                continue
            choice = chunk.choices[0]
            if choice.delta.content:
                parts.append(choice.delta.content)
                on_text(choice.delta.content)
            if choice.finish_reason:
                finish = choice.finish_reason
    except openai.APIError as err:
        return ''.join(parts), False, err
    return ''.join(parts), finish is not None, None
Due dettagli meritano un secondo sguardo. Primo, entrambi gli handler catturano la classe di errore base dell'SDK (anthropic., openai.APIError), quindi non importa quale sottoclasse l'SDK sollevi per un dato fallimento. Secondo, il flag finished è separato dall'eccezione: uno stream può anche semplicemente terminare prima, senza alcuna eccezione, e anche quel caso deve contare come fallimento.
Il README di openai-python aggiunge cosa aspettarsi sul lato OpenAI (consultato il 1 novembre 2026): un timeout di lettura in uno stream solleva APITimeoutError, altri fallimenti HTTPX sollevano APIConnectionError con l'eccezione originale in __cause__. Se lo stream si blocca invece di fallire, vedi timeout e retry nell'OpenAI Python SDK.
Riprova senza stampare due volte la risposta#
Ecco un bug facile da rilasciare. Un primo tentativo stampa "La politica di rimborso è…", muore, il retry ricomincia e stampa di nuovo "La politica di rimborso è…" — ora l'utente vede due volte l'inizio, o una frase incollata al proprio riavvio. La causa abituale è un buffer condiviso: answer += text vive fuori dal tentativo, quindi il secondo tentativo si aggiunge al primo.
La cura è noiosa. Un tentativo possiede un buffer, il testo di un tentativo fallito viene scartato (o conservato solo per il log), e il retry riparte da zero:
import time

def ask_with_retry(prompt, attempts=3, on_text=lambda t: None, on_restart=lambda: None):
    for attempt in range(attempts):
        text, finished, err = ask_once(prompt, on_text)
        if finished:
            return text
        status = getattr(err, 'status_code', None)
        if status is not None and 400 <= status < 500 and status not in (408, 409, 429):
            raise err  # a 400/401/404 will not fix itself
        print(f'attempt {attempt + 1} failed after {len(text)} chars: {err!r}')
        if attempt == attempts - 1:
            break
        on_restart()  # clear the message box in your UI
        time.sleep(2 ** attempt)  # 1 s, 2 s
    raise RuntimeError('stream failed after all attempts')
on_restart è la parte che ferma il duplicato. In una web UI svuota il messaggio prima che il tentativo successivo arrivi in streaming. In un terminale semplice non puoi annullare la stampa, quindi o stampi solo dopo che finished è vero, oppure stampi una riga visibile --- retrying ---. Riprovare da zero reinvia l'intero prompt, quindi l'input viene fatturato di nuovo per il nuovo tentativo; per la maggior parte delle risposte in chat è un prezzo equo per una risposta pulita.
Metti in ordine
Metti i passaggi del retry nell'ordine in cui il tuo codice dovrebbe eseguirli
Trascina gli elementi o usa le frecce
- Interrompi la lettura dello stream interrotto e conserva il suo testo parziale per il log
- Controlla l'errore: un 4xx diverso da 408, 409 e 429 significa fermarsi, non riprovare
- Svuota la casella del messaggio e inizia un nuovo buffer
- Attendi con backoff esponenziale (1 s, poi 2 s)
- Invia di nuovo la richiesta completa e mostra solo la nuova risposta
L'SDK di Anthropic riprova già i fallimenti transitori — errori di connessione, rate limit, 5xx — con backoff esponenziale, 2 volte per impostazione predefinita, rispettando retry-after, e max_retries lo modifica. Questo copre la richiesta. Uno stream che muore dopo il 200 è un'altra storia: la documentazione dice che la gestione standard degli errori non si applica lì, quindi il loop sopra è tuo da mantenere. Per il 429 da solo, c'è una guida separata: 429 Too Many Requests: retry con backoff.
Non ogni interruzione anticipata è un errore#
Prima di riprovare, controlla perché la risposta è terminata. Uno stream che finisce con stop_ (Anthropic) o finish_ (OpenAI) è terminato — ha solo raggiunto il limite che hai impostato. Riprovare restituisce lo stesso testo troncato e la stessa fattura. Alza invece il limite; la guida alla risposta troncata spiega come fare.
C'è un terzo gruppo: la rete. Le connessioni inattive possono essere interrotte lungo il percorso, il che si manifesta come un errore di connessione o uno stream che si ferma senza alcun evento. Gestiscilo come un errore a metà stream, e vedi errori di connessione comuni se continua a succedere. Per generazioni lunghe, Anthropic consiglia lo streaming rispetto a un enorme max_tokens non in streaming, quindi sei già dalla parte giusta.
Prima di rilasciare#
Salva il request id di ogni tentativo fallito. I body di errore di Anthropic portano un campo request_id e un header di risposta request-id, e l'SDK Python espone message.; con quell'id un fallimento è tracciabile invece che aneddotico.
Lista di controllo
Gestione degli errori di streaming, fatta bene
Se vuoi vedere l'handler in esecuzione, puntalo sulla tua chiave: crea una chiave API nella documentazione, imposta CHEAPTOKENS_ e chiama ask_. Per le basi dello streaming in Python, inizia con risposte in streaming in Python; il lato Anthropic è trattato in l'Anthropic Python SDK con CheapTokens.