故障排查指南
HTTP 200 之后流失败:在 Python 中捕获流中途错误
为什么流在 200 状态之后仍可能中断,如何发现 event: error,以及一个保留部分文本且不重复答案的 Python 重试。
你的聊天 UI 只流式输出了一半答案就卡住了,日志里写着 200 OK。这并不矛盾:200 只说明流已经开始,并不代表它已经结束。 如果之后出了问题,服务器只能在流内部发送错误,因此只检查状态码永远看不到它。解决办法是:只有当流以其结束信号收尾时,才把它视为成功;否则就从干净的缓冲区重试。
本页其余部分会展示损坏的流是什么样子、两个 Python 处理程序(Anthropic Messages 和 OpenAI SDK),以及一个不会把答案开头打印两次的重试。两个处理程序都使用 CheapTokens 作为 API 端点:文档 中有基础 URL,示例模型是 DeepSeek-V4-Flash(id deepseek-,380K 上下文,每次回答最多 32,768 个输出 token,任何时段同一价格——见模型页面)。
200 到底承诺了什么#
想象一位快递员在门口签收包裹:签名只能证明他到了,不能证明包裹完好。HTTP 也是同样的道理。服务器先发送状态行和响应头,然后响应体一块一块地到达。如果模型后端在中途过载,状态行早已发出。
Anthropic 的 API 错误页面(2026 年 11 月 1 日查阅)直接说明了这一点:当你通过 SSE 接收流式响应时,错误可能在 API 返回 200 之后发生,此时标准的错误处理并不适用。其流式文档给出了该事件的结构:
event: error
data: {"type": "error", "error": {"type": "overloaded_error", "message": "Overloaded"}}
overloaded_error 通常对应非流式调用中的 HTTP 529(高流量导致的临时过载)。同一页面还列出了 500 api_error(使用指数退避重试)和 504 timeout_error(长请求请使用流式)。在传输线上,损坏的流看起来是这样的:
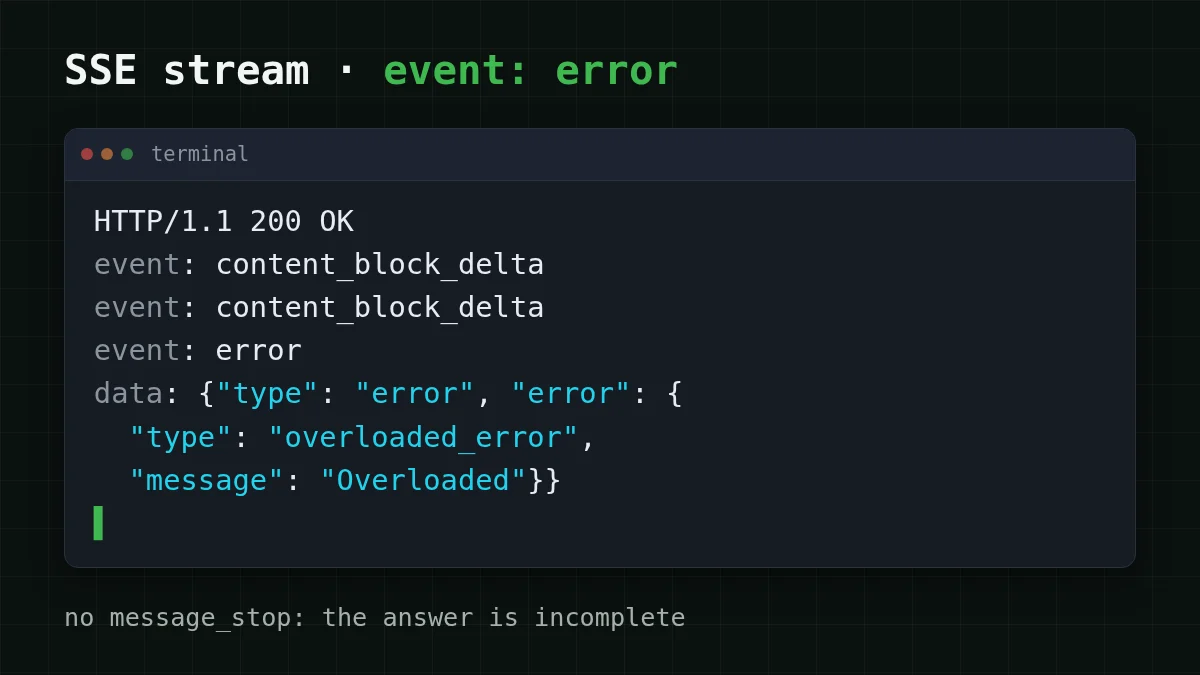
文档还警告说可能会新增事件类型,因此你的代码应当优雅地处理未知事件。这就是为什么下面的处理程序不去识别每一个错误字节。它们只问一个问题:流是否以其结束信号收尾?
- Anthropic Messages:最后一个事件是
message_stop,message_delta中的stop_reason说明它为何结束(end_turn、max_tokens、stop_sequence)。 - OpenAI Chat Completions:最后一个块携带非空的
finish_reason(stop、length、……)。
没有结束信号,或者中途出现异常——无论状态码说了什么,答案都是不完整的。
在 Python 中捕获它#
以一个向浏览器流式发送回复的客服机器人为例。循环把文本收集到缓冲区,并回报三件事:目前的文本、流是否结束,以及如果有错误的话是什么错误。请选择你所用 SDK 对应的标签页。
一个处理程序,两个 SDK
Anthropic SDK
import os
import anthropic

client = anthropic.Anthropic(
    base_url='https://api.cheaptokens.dev',  # no /v1 for the Anthropic SDK
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'

def ask_once(prompt, on_text=lambda t: None):
    parts, finished = [], False
    try:
        with client.messages.stream(
            model=MODEL,
            max_tokens=1024,
            messages=[{'role': 'user', 'content': prompt}],
        ) as stream:
            for event in stream:
                if event.type == 'content_block_delta' and event.delta.type == 'text_delta':
                    parts.append(event.delta.text)
                    on_text(event.delta.text)
                elif event.type == 'message_stop':
                    finished = True
    except anthropic.APIError as err:
        return ''.join(parts), False, err
    return ''.join(parts), finished, None
OpenAI SDK
import os
import openai

client = openai.OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'

def ask_once(prompt, on_text=lambda t: None):
    parts, finish = [], None
    try:
        stream = client.chat.completions.create(
            model=MODEL,
            max_tokens=1024,
            stream=True,
            messages=[{'role': 'user', 'content': prompt}],
        )
        for chunk in stream:
            if not chunk.choices:
                continue
            choice = chunk.choices[0]
            if choice.delta.content:
                parts.append(choice.delta.content)
                on_text(choice.delta.content)
            if choice.finish_reason:
                finish = choice.finish_reason
    except openai.APIError as err:
        return ''.join(parts), False, err
    return ''.join(parts), finish is not None, None
有两个细节值得再看一眼。第一,两个处理程序都捕获 SDK 的基类错误(anthropic.、openai.APIError),因此 SDK 针对某种失败抛出哪个子类都无关紧要。第二,finished 标志与异常是分开的:流也可能只是提前结束,完全没有异常,这种情况也必须算作失败。
openai-python 的 README 补充了 OpenAI 侧可以预期的情况(2026 年 11 月 1 日查阅):流中的读取超时会抛出 APITimeoutError,其他 HTTPX 失败会抛出 APIConnectionError,原始异常放在 __cause__ 中。如果流是停滞而不是失败,请参阅 OpenAI Python SDK 中的超时与重试。
重试时不把答案打印两次#
这里有一个很容易上线的 bug。第一次尝试打印了“退款政策是……”,然后中断,重试从头开始又打印了“退款政策是……”——现在用户看到开头两次,或者一句话与它自己的重启粘在一起。常见原因是一个共享缓冲区:answer += text 位于尝试之外,所以第二次尝试会追加到第一次的内容上。
解决办法很朴素。一次尝试拥有一个缓冲区,失败尝试的文本被丢弃(或仅保留用于日志),重试从头开始:
import time

def ask_with_retry(prompt, attempts=3, on_text=lambda t: None, on_restart=lambda: None):
    for attempt in range(attempts):
        text, finished, err = ask_once(prompt, on_text)
        if finished:
            return text
        status = getattr(err, 'status_code', None)
        if status is not None and 400 <= status < 500 and status not in (408, 409, 429):
            raise err  # a 400/401/404 will not fix itself
        print(f'attempt {attempt + 1} failed after {len(text)} chars: {err!r}')
        if attempt == attempts - 1:
            break
        on_restart()  # clear the message box in your UI
        time.sleep(2 ** attempt)  # 1 s, 2 s
    raise RuntimeError('stream failed after all attempts')
on_restart 是阻止重复的关键。在 Web UI 中,它会在下一次尝试流入之前清空消息气泡。在普通终端里你无法取消打印,所以要么只在 finished 为真之后才打印,要么打印一行可见的 --- retrying ---。从头重试会重新发送整个提示,因此新尝试的输入会被再次计费;对大多数聊天回复来说,为了得到干净的答案,这个代价是合理的。
排序
按代码应执行的顺序排列重试步骤
拖动项目或使用箭头
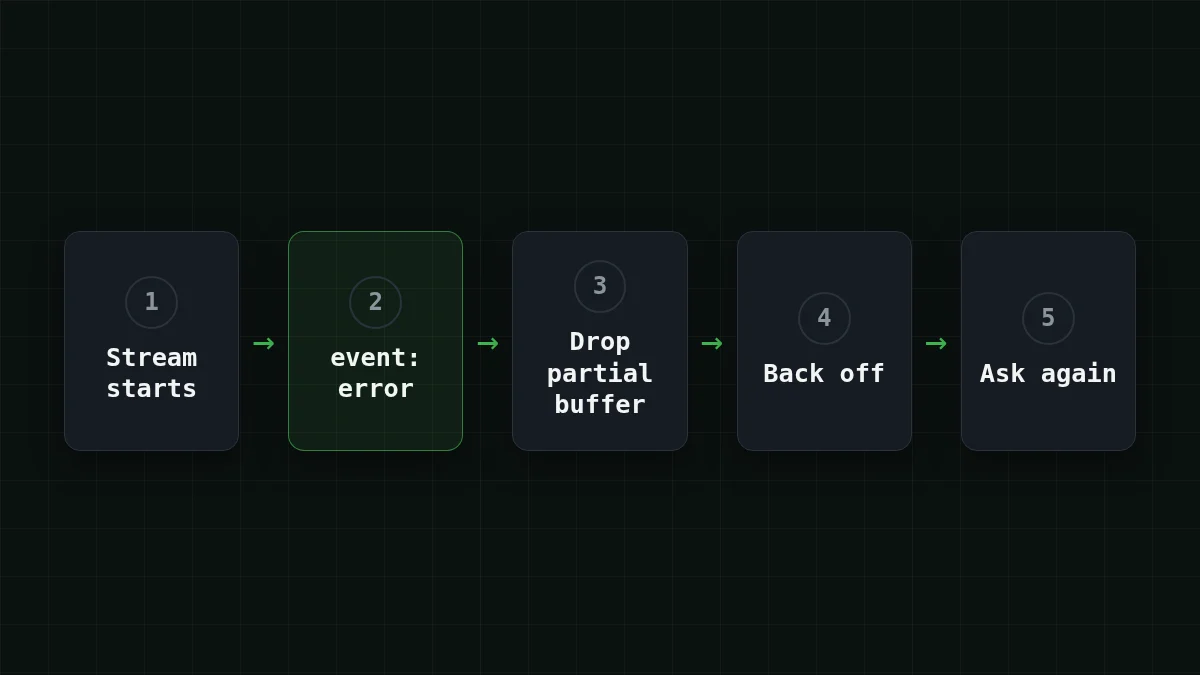
- 停止读取损坏的流,并保留其部分文本用于日志
- 检查错误:除 408、409 和 429 之外的 4xx 意味着停止,而不是重试
- 清空消息框并开始新的缓冲区
- 使用指数退避等待(1 秒,然后 2 秒)
- 再次发送完整请求,只显示新的答案
Anthropic 的 SDK 已经会以指数退避重试瞬时故障——连接错误、速率限制、5xx——默认重试 2 次,并遵循 retry-after,max_retries 可以改变这一点。这覆盖了请求本身。而在 200 之后才中断的流是另一回事:文档说标准错误处理在那里不适用,所以上面的循环需要你自己保留。仅针对 429,还有一篇单独的详解:429 Too Many Requests:带退避的重试。
并非每次提前停止都是错误#
在重试之前,先检查答案为何结束。以 stop_(Anthropic)或 finish_(OpenAI)结束的流确实已经结束——它只是达到了你设置的限制。重试它会返回同样的截断文本和同样的账单。应该提高限制;截断答案指南 对此有详细说明。
还有第三类:网络。空闲连接可能在途中被断开,表现为连接错误或流在没有任何事件的情况下停止。把它当作流中途错误来处理,如果持续发生,请参阅常见连接错误。对于长时间生成,Anthropic 建议使用流式而不是巨大的非流式 max_tokens,所以你已经站在了正确的一边。
上线之前#
保存每次失败尝试的请求 id。Anthropic 的错误响应体带有 request_id 字段和 request-id 响应头,Python SDK 会暴露 message.;有了这个 id,失败就可以被追踪,而不是只靠口口相传。
清单
流式错误处理,正确做法
如果你想看处理程序运行,请指向你自己的密钥:在文档中创建 API 密钥,设置 CHEAPTOKENS_,然后调用 ask_。关于 Python 流式的基础知识,请从 Python 中的流式响应 开始;Anthropic 侧的内容在 使用 CheapTokens 的 Anthropic Python SDK 中介绍。