故障排查指南
在 Python 中打印 LLM 回复时出现 UnicodeEncodeError:3 个修复
print(reply) 在西里尔字母或 emoji 上崩溃?了解为什么 Python 在重定向输出或旧版代码页下失败,并用 UTF-8 模式、reconfigure 或 encoding= 修复它。
你的请求已经发出,模型也给出了回答,然后 Python 在 print(reply) 上崩溃了。问题不在 API。回复本身没问题;是你打印它的地方无法表示其中的某些字符。最快的修复方法是用 PYTHONUTF8=1 开启 UTF-8 模式。如果你更希望把它留在脚本里,就在顶部调用 sys.,而当你把回复保存到文件时,给 open() 传入 encoding="utf-8"。
错误长什么样#
假设你用俄语向模型提问并打印答案。这就是完整的脚本,使用我们首次请求指南中的普通 requests 调用:
import os, requests

r = requests.post(
    "https://api.cheaptokens.dev/v1/chat/completions",
    headers={"Authorization": f"Bearer {os.environ['CHEAPTOKENS_API_KEY']}"},
    json={
        "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
        "messages": [{"role": "user", "content": "Ответь одним предложением: что такое токен?"}],
        "max_tokens": 200,
    },
)
reply = r.json()["choices"][0]["message"]["content"]
print(reply)
当 stdout 被重定向到文件或管道,或者 Python 启动时为其流使用了旧版代码页,最后一行会像这样结束:
UnicodeEncodeError: 'charmap' codec can't encode characters in position 0-5: character maps to <undefined>你消息中的编解码器名称取决于流的编码(对于 Windows 代码页通常是 charmap,对于 ascii 则是 ascii),而位置取决于回复内容。形态始终相同:回溯指向 print,而不是请求。
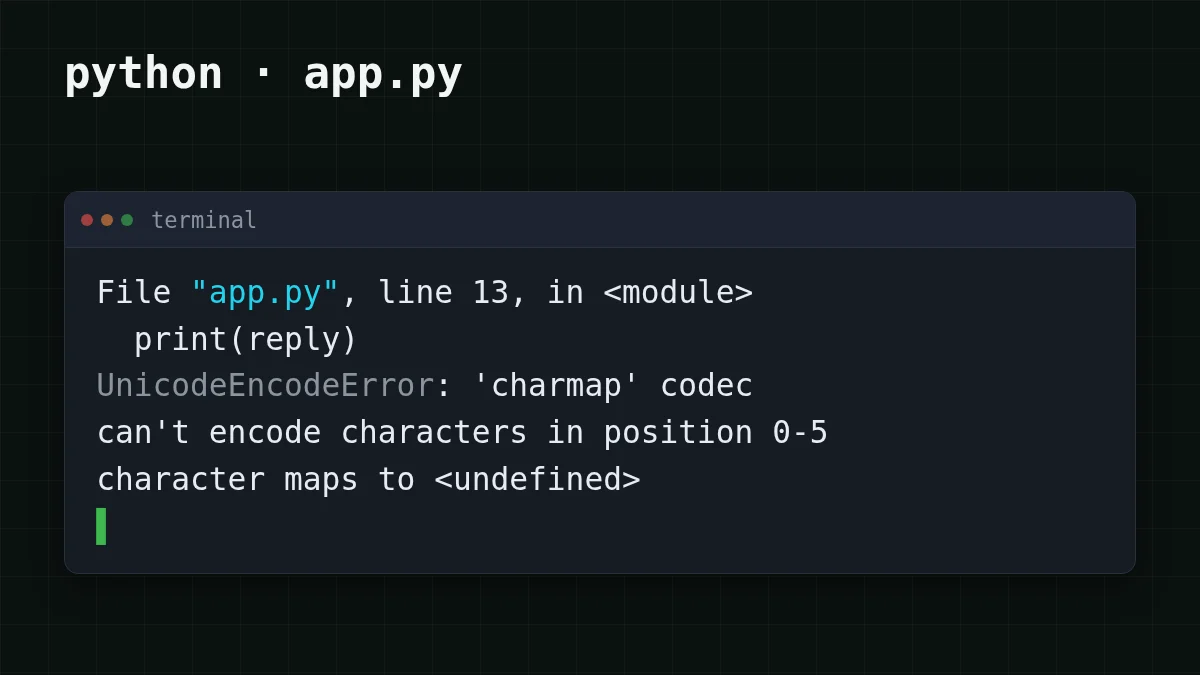
为什么会发生?print 使用 sys.stdout 的编码将文本转换为字节。如果该编码是旧版代码页,那么任何不在其中的字符——例如西文代码页中的西里尔字母、emoji,有时还有排版破折号——都没有可转换成的字节。Python 会抛出异常,而不是猜测。
它出现在三种情况下:
- stdout 被重定向或管道传输(
python app.、py > out. txt | another program),或者脚本从调度器、CI 或编辑器中运行,而那里的 stdout 不是控制台; - 设置了
PYTHONLEGACYWINDOWSSTDIO,或者流以其他方式获得了窄编码; - 你用
open(path, "w")把回复写入文件,且没有encoding=。
哪个 Python? 以下内容都针对 Python 3.7–3.14,其中流和文件编码来自系统。根据 PEP 686(状态为 Final,https://peps.python.org/pep-0686/, 于 2026 年 11 月 5 日检查),从 Python 3.15 起 UTF-8 模式默认开启,因此在那里 open() 和 stdio 已经使用 UTF-8,除非有人用 PYTHONUTF8=0 或 -X utf8=0 将其关闭。用 python --version 检查。
检查你实际使用的编码#
在更改任何内容之前,先看看 Python 选了什么。只需十秒钟。
自己试试试一试:Python 认为你的 stdout 编码是什么?显示答案
在脚本失败的那个窗口中运行 python -。在交互式控制台中,它通常打印 utf-8,所以仅凭这一点说明不了什么。在末尾加上 > check.txt 再运行一次并打开文件:重定向输出更常给出 cp… 名称或 ascii,那就是罪魁祸首。如果一切都显示 utf-8,就看看你写入的文件。
想不等倒霉日子就看看崩溃?在 macOS 或 Linux 上,为一次运行强制使用窄编码:
PYTHONIOENCODING=ascii python -c "print('Привет')"这会失败并给出 ascii 编解码器消息,与上面的错误属于同一类。在 Windows 上,该变量对交互式控制台会被忽略,但在输出被重定向时有效:在 cmd 中运行 set PYTHONIOENCODING=ascii,然后运行 python -(在 PowerShell 中:$env:PYTHONIOENCODING = "ascii")。
修复 1:开启 UTF-8 模式#
Python 有一个模式,使 UTF-8 成为文本的默认编码。根据 Python 文档(命令行页面,于 2026 年 11 月 5 日检查),PYTHONUTF8=1 会开启它,-X utf8 效果相同;两者自 Python 3.7 起就存在。同一页面还有一个注意事项:PYTHONUTF8 的任何其他非空值都会导致启动时出错,所以请准确使用 1(或用 0 将其关闭)。在 3.15 上,你只需要这个来在较旧解释器上显式启用该模式;如果那里已经开启,就在你的环境中查找 PYTHONUTF8=0。
为一次运行开启 UTF-8 模式
cmd
set PYTHONUTF8=1
python app.py
PowerShell
$env:PYTHONUTF8 = "1"
python app.py
macOS / Linux
PYTHONUTF8=1 python app.py无需更改代码,而且它覆盖该次运行中的控制台、重定向和文件。如果你不想每次都设置变量,python - 从命令行给出相同结果。
还有 PYTHONIOENCODING=utf-,它只覆盖 stdin、stdout 和 stderr 的编码。在 Windows 上依赖它之前,请阅读其文档条目:自 Python 3.6 起,除非设置了 PYTHONLEGACYWINDOWSSTDIO,否则它对交互式控制台缓冲区会被忽略。重定向的文件和管道不受该例外影响。因此它可以修复 python app.,但在控制台窗口中仍然无效。对于 stderr,错误处理器始终是 backslashreplace。
修复 2:在脚本内重新配置 stdout#
如果你无法控制人们如何启动脚本,就在最顶部更改流本身:
import sys

sys.stdout.reconfigure(encoding="utf-8")
sys.stderr.reconfigure(encoding="utf-8")

print(reply)
reconfigure 是为 io.TextIOWrapper 记录的(在 3.7 中添加)。当你传入 encoding 并省略 errors 时,处理器是 strict,因此不合适的字符仍会抛出异常;对于 UTF-8 的常见情况,不会剩下任何字符。文档中有两个细节:一旦从流中读取了数据,编码就不能更改(写入后可以),并且 encoding="locale" 自 3.11 起受支持。
需要脚本永不崩溃,即使终端确实无法显示文本?添加 errors="replace"。未知字符随后会显示为 ?,而不是停止运行。这掩盖了问题而不是修复它,所以请保留给日志使用。
修复 3:为文件指定显式编码#
保存回复是同样的失败,只是在代码中更安静:
# before: on Python up to 3.14 this uses the system's default encoding
with open("reply.txt", "w") as f:
    f.write(reply)

# after: the file is UTF-8 on every machine
with open("reply.txt", "w", encoding="utf-8") as f:
    f.write(reply)
当你读回文件时使用相同的 encoding="utf-8",否则文本可能在读入时出错。
你应该用哪个修复?#
选择你的情况
选择你的情况
选择一个选项以查看答案
我在终端中运行自己的脚本
在你的环境中设置一次 PYTHONUTF8=1,或用 python - 启动。代码中无需更改。
我把脚本交付给其他人
把 sys. 放在顶部,这样无论他们如何启动都能工作。
崩溃发生在文件上,而不是屏幕上
给 open() 添加 encoding="utf-8",用于写入和读取。
你可以组合使用它们。一个既打印又保存回复的脚本需要修复 2 或修复 1 用于屏幕,以及修复 3 用于文件。
如果仍然失败#
- 错误移到了不同的行。 那么失败的调用是另一个
print或write;修复必须在其运行之前应用,所以把reconfigure放在最顶部。 - 错误提到
PYTHONUTF8。 该变量的值不是1或0。删除它并重新设置。 - 没有崩溃,但你在控制台中看到方块或
?。 Python 写入了有效的 UTF-8;控制台字体或代码页无法显示它。重定向到文件并在编辑器中打开文件,以确认回复完好无损。 - 错误是
JSONDecodeError,而不是UnicodeEncodeError。 不同的问题:参见如何从模型回复中提取 JSON。
上面的请求代码是普通的 requests 调用;CheapTokens 文档展示了 OpenAI SDK 的相同调用。另一个模型也适用同样的修复:将 model 字段换成 zai-(每个答案最多 8,192 个输出 token,390K 上下文)。编码错误与模型无关,只与文本的去向有关。


