Решение проблемИнструкция
UnicodeEncodeError при print ответа модели в Python: 3 способа
print(reply) падает на кириллице или эмодзи? Почему Python ломается при перенаправлении вывода или со старой кодовой страницей и как это чинят: UTF-8 mode, reconfigure, encoding=.
Содержание
Запрос прошёл, модель ответила, а Python упал на print(reply). API тут ни при чём: ответ целый, просто то место, куда вы его печатаете, не умеет записывать часть его символов. Быстрее всего помогает режим UTF-8: PYTHONUTF8=1. Если хотите решить это внутри скрипта, поставьте в начало sys., а при записи ответа в файл передавайте в open() аргумент encoding="utf-8".
Как выглядит ошибка#
Допустим, вы задаёте модели вопрос по-русски и печатаете ответ. Весь скрипт, на простом requests из нашей статьи про первый запрос:
import os, requests

r = requests.post(
    "https://api.cheaptokens.dev/v1/chat/completions",
    headers={"Authorization": f"Bearer {os.environ['CHEAPTOKENS_API_KEY']}"},
    json={
        "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
        "messages": [{"role": "user", "content": "Ответь одним предложением: что такое токен?"}],
        "max_tokens": 200,
    },
)
reply = r.json()["choices"][0]["message"]["content"]
print(reply)
Если вывод перенаправлен в файл или канал либо Python запущен со старой кодовой страницей для потоков, последняя строка заканчивается так:
UnicodeEncodeError: 'charmap' codec can't encode characters in position 0-5: character maps to <undefined>Имя кодека у вас зависит от кодировки потока (для кодовой страницы Windows это обычно charmap, для ascii — ascii), а позиции от ответа. Форма всегда одна: трассировка указывает на print, а не на запрос.
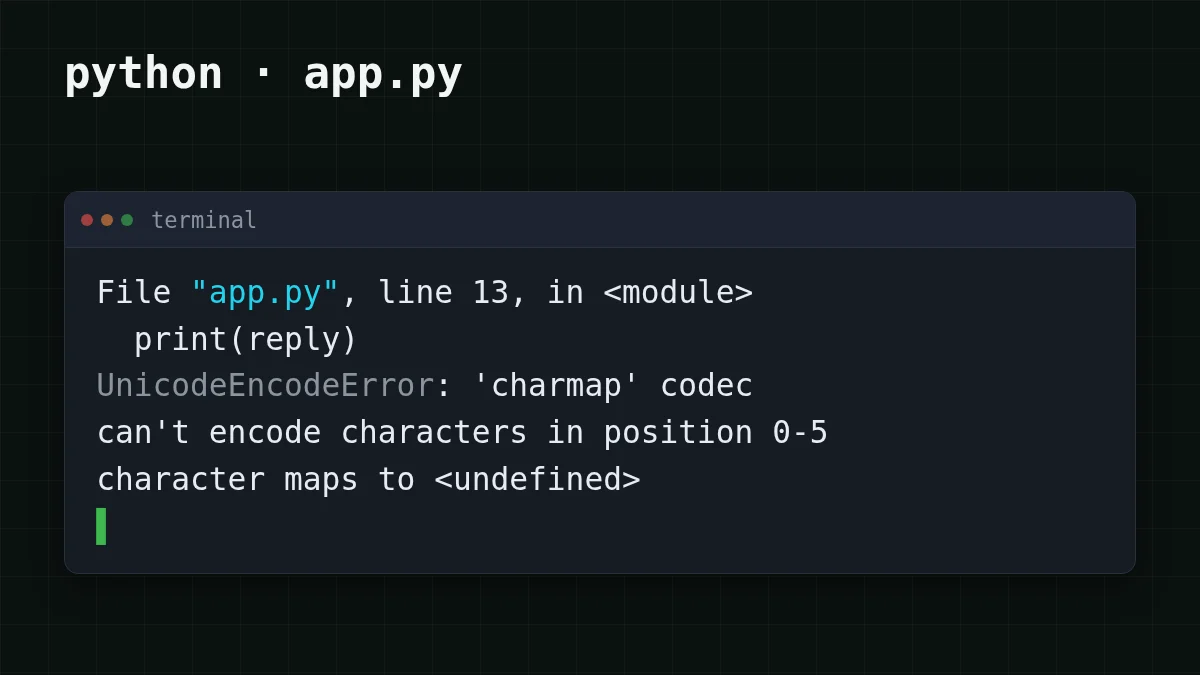
Почему так? print превращает текст в байты кодировкой sys.stdout. Если это старая кодовая страница, символу вне её просто нет байта: кириллице в западной странице, эмодзи, иногда типографскому тире. Python не гадает и бросает исключение.
Встречается это в трёх ситуациях:
- вывод перенаправлен или передан по каналу (
python app.,py > out. txt | другая программа), либо скрипт запущен из планировщика, CI или редактора, где stdout — не консоль; - задана
PYTHONLEGACYWINDOWSSTDIOили поток иначе получает узкую кодировку; - вы пишете ответ в файл через
open(path, "w")безencoding=.
Какой Python? Всё ниже — про Python 3.7–3.14, где кодировку потоков и файлов берут из системы. По PEP 686 (статус Final, https://peps.python.org/pep-0686/, сверено 5 ноября 2026) с Python 3.15 режим UTF-8 включён по умолчанию, так что open() и stdio там уже в UTF-8, если его не выключили через PYTHONUTF8=0 или -X utf8=0. Версию покажет python --version.
Сначала узнайте свою кодировку#
Прежде чем что-то менять, посмотрите, что выбрал Python. Это десять секунд.
Попробуйте самиПопробуйте: какую кодировку Python считает для stdout?Показать ответ
Запустите python - в том же окне, где падает скрипт. В интерактивной консоли обычно выводится utf-8, так что одно это ещё ничего не доказывает. Запустите ещё раз с > check.txt в конце и откройте файл: именно перенаправленный вывод чаще даёт имя вида cp… или ascii, и тогда виновник найден. Если везде utf-8, смотрите на файл, в который пишете.
Хотите увидеть падение, не дожидаясь неудачного дня? На macOS или Linux принудительно задайте узкую кодировку на один запуск:
PYTHONIOENCODING=ascii python -c "print('Привет')"Ошибка будет про кодек ascii, из того же семейства, что и выше. В Windows для интерактивной консоли эта переменная игнорируется, но при перенаправлении вывода работает: в cmd выполните set PYTHONIOENCODING=ascii, затем python - (в PowerShell: $env:PYTHONIOENCODING = "ascii").
Способ 1: включить режим UTF-8#
У Python есть режим, где текст по умолчанию в UTF-8. По документации Python (страница командной строки, сверено 5 ноября 2026) его включает PYTHONUTF8=1, то же делает -X utf8; оба есть с Python 3.7. И одна ловушка с той же страницы: любое другое непустое значение PYTHONUTF8 вызывает ошибку при запуске, так что ставьте ровно 1 (или 0, чтобы выключить). В 3.15 явно включать режим нужно только на старых интерпретаторах; если там он уже включён, поищите в окружении PYTHONUTF8=0.
Включить режим UTF-8 на один запуск
cmd
set PYTHONUTF8=1
python app.py
PowerShell
$env:PYTHONUTF8 = "1"
python app.py
macOS / Linux
PYTHONUTF8=1 python app.pyКод не меняется, а в этом запуске режим охватывает и консоль, и перенаправление, и файлы. Не хотите каждый раз задавать переменную? python - даёт тот же результат прямо из командной строки.
Есть ещё PYTHONIOENCODING=utf-: она переопределяет кодировку только stdin, stdout и stderr. Прежде чем рассчитывать на неё в Windows, прочитайте её запись в документации: начиная с Python 3.6 она игнорируется для интерактивного буфера консоли, если не задана PYTHONLEGACYWINDOWSSTDIO. На перенаправленные файлы и каналы это исключение не действует. Поэтому она может вылечить python app. и при этом ничего не изменить в окне консоли. Для stderr обработчик ошибок всегда backslashreplace.
Способ 2: переключить stdout внутри скрипта#
Если вы не управляете тем, как скрипт запускают, поменяйте сам поток в самом начале:
import sys

sys.stdout.reconfigure(encoding="utf-8")
sys.stderr.reconfigure(encoding="utf-8")

print(reply)
reconfigure описан в документации для io.TextIOWrapper (появился в 3.7). Если передать encoding и не указать errors, обработчик будет strict: символ, который не помещается, всё равно вызовет ошибку, но в UTF-8 такого не остаётся. Ещё две детали из документации: кодировку нельзя менять после чтения данных из потока (после записи можно), а encoding="locale" поддерживается с 3.11.
Нужно, чтобы скрипт не падал никогда, даже в терминале, который правда не умеет показать текст? Добавьте errors="replace". Незнакомые символы превратятся в ?, и работа не остановится. Это прячет проблему, а не лечит её, так что оставьте для логов.
Способ 3: явная кодировка для файлов#
Сохранение ответа даёт ту же ошибку, только в коде она менее заметна:
# было: в Python до 3.14 здесь кодировка по умолчанию системы
with open("reply.txt", "w") as f:
    f.write(reply)

# стало: файл в UTF-8 на любой машине
with open("reply.txt", "w", encoding="utf-8") as f:
    f.write(reply)
Тот же encoding="utf-8" ставьте и при чтении файла, иначе текст может сломаться уже на входе.
Какой способ выбрать#
Выберите свой случай
Выберите свой случай
Выберите вариант, чтобы увидеть ответ
Я запускаю свой скрипт в терминале
Один раз задайте PYTHONUTF8=1 в окружении или запускайте python -. Код не меняется.
Я отдаю скрипт другим людям
Поставьте sys. в начало, и он будет работать при любом способе запуска.
Падает запись в файл, а не вывод на экран
Добавьте encoding="utf-8" в open(), и для записи, и для чтения.
Способы можно сочетать. Скрипту, который и печатает, и сохраняет ответы, нужен способ 2 или 1 для экрана и способ 3 для файла.
Если всё равно падает#
- Ошибка переехала на другую строку. Значит, падает другой
printилиwrite; исправление должно сработать до него, поэтомуreconfigureставьте в самый верх. - В тексте ошибки
PYTHONUTF8. У переменной значение не1и не0. Уберите её и задайте заново. - Падения нет, но в консоли квадраты или
?. Python записал корректный UTF-8, а шрифт или кодовая страница консоли не умеют его показать. Перенаправьте вывод в файл и откройте его в редакторе: так видно, что ответ цел. - Ошибка —
JSONDecodeError, а неUnicodeEncodeError. Это другая проблема: см. как достать JSON из ответа модели.
Код запроса выше — простой requests; в документации CheapTokens тот же вызов показан для OpenAI SDK. С другой моделью исправление работает так же: замените поле model на zai- (до 8 192 токенов в ответе, контекст 390K). Ошибка кодировки не зависит от модели, только от того, куда уходит текст.


