문제 해결가이드
Python에서 LLM 응답을 출력할 때 UnicodeEncodeError: 3가지 해결책
print(reply)가 키릴 문자나 이모지에서 크래시하나요? 리다이렉트된 출력이나 레거시 코드 페이지에서 Python이 실패하는 이유를 보고 UTF-8 모드, reconfigure 또는 encoding=으로 해결하세요.
이 페이지의 내용
요청은 정상적으로 처리됐고 모델도 답변했는데, 그다음 print(reply)에서 Python이 죽었습니다. API 잘못이 아닙니다. 응답 자체는 멀쩡하고, 출력하는 위치가 일부 문자를 표현하지 못할 뿐입니다. 가장 빠른 해결책은 PYTHONUTF8=1로 UTF-8 모드를 켜는 것입니다. 스크립트 안에서 처리하고 싶다면 맨 위에서 sys.를 호출하고, 응답을 파일로 저장할 때는 open()에 encoding="utf-8"를 넘기세요.
오류는 이렇게 보입니다#
모델에 러시아어로 질문하고 답변을 출력한다고 해 봅시다. 첫 요청 가이드의 단순한 requests 호출을 사용한 전체 스크립트는 다음과 같습니다:
import os, requests

r = requests.post(
    "https://api.cheaptokens.dev/v1/chat/completions",
    headers={"Authorization": f"Bearer {os.environ['CHEAPTOKENS_API_KEY']}"},
    json={
        "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
        "messages": [{"role": "user", "content": "Ответь одним предложением: что такое токен?"}],
        "max_tokens": 200,
    },
)
reply = r.json()["choices"][0]["message"]["content"]
print(reply)
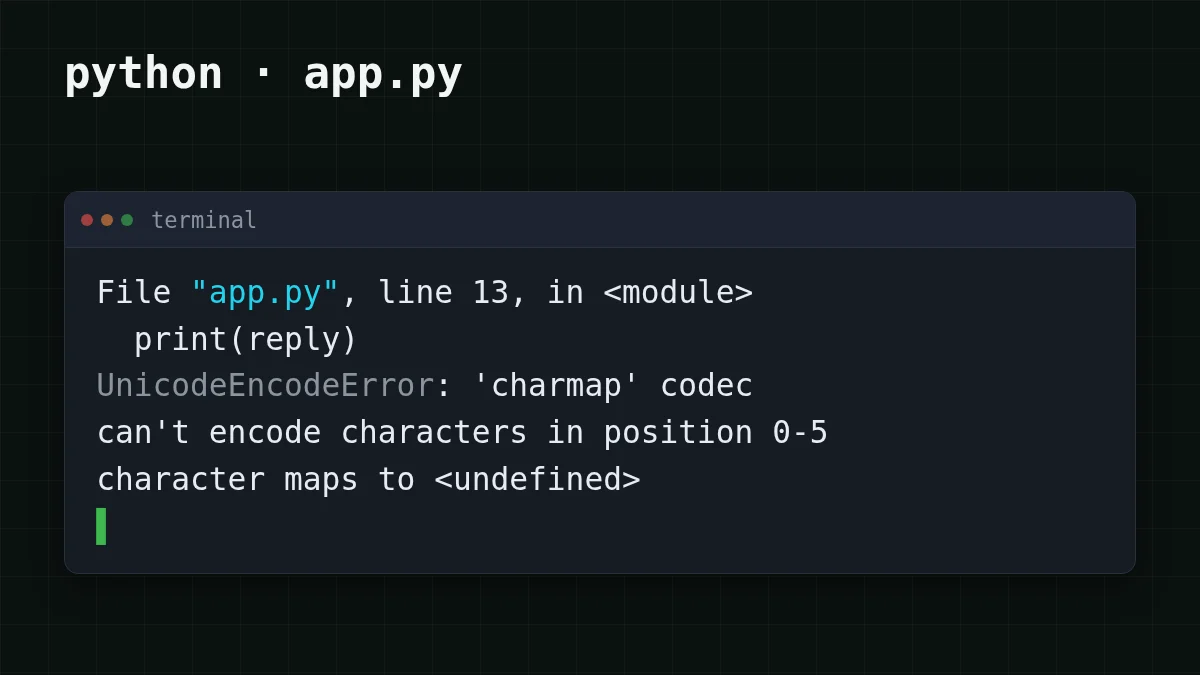
stdout이 파일이나 파이프로 리다이렉트되거나, Python이 스트림에 레거시 코드 페이지로 시작된 경우 마지막 줄은 이렇게 끝납니다:
UnicodeEncodeError: 'charmap' codec can't encode characters in position 0-5: character maps to <undefined>메시지에 나오는 코덱 이름은 스트림의 인코딩에 따라 달라지고(Windows 코드 페이지라면 보통 charmap, ascii라면 ascii), 위치는 응답에 따라 달라집니다. 형태는 항상 같습니다. 트레이스백이 요청이 아니라 print를 가리킵니다.
왜 발생할까요? print는 sys.stdout의 인코딩을 사용해 텍스트를 바이트로 변환합니다. 그 인코딩이 레거시 코드 페이지라면, 서구 코드 페이지의 키릴 문자, 이모지, 때로는 타이포그래피 대시처럼 그 밖의 문자는 변환할 바이트가 없습니다. Python은 추측하지 않고 예외를 발생시킵니다.
세 가지 상황에서 나타납니다:
- stdout이 리다이렉트되거나 파이프되는 경우(
python app.,py > out. txt | another program), 또는 스케줄러, CI, 에디터에서 스크립트를 실행해 stdout이 콘솔이 아닌 경우; PYTHONLEGACYWINDOWSSTDIO이 설정되었거나, 스트림이 좁은 인코딩을 받은 경우;open(path, "w")로 응답을 파일에 쓰면서encoding=를 지정하지 않은 경우.
어떤 Python인가요? 아래 내용은 모두 Python 3.7–3.14에 해당하며, 여기서는 스트림과 파일 인코딩을 시스템에서 가져옵니다. PEP 686(상태 Final, https://peps.python.org/pep-0686/, 2026년 11월 5일 확인)에 따르면 Python 3.15부터 UTF-8 모드가 기본으로 켜지므로, 누군가 PYTHONUTF8=0나 -X utf8=0로 끄지 않았다면 open()과 stdio는 이미 UTF-8을 사용합니다. python --version로 확인하세요.
실제 인코딩 확인하기#
무엇이든 바꾸기 전에 Python이 무엇을 선택했는지 보세요. 10초면 됩니다.
직접 해보기직접 해보기: Python은 stdout 인코딩을 무엇이라고 생각할까?정답 보기
스크립트가 실패하는 같은 창에서 python -을 실행하세요. 대화형 콘솔에서는 보통 utf-8을 출력하므로 그것만으로는 증명이 되지 않습니다. 끝에 > check.txt를 붙여 다시 실행하고 파일을 열어 보세요. 리다이렉트된 출력이 cp… 이름이나 ascii을 더 자주 내놓고, 그것이 원인입니다. 모두 utf-8라고 나온다면 쓰는 파일을 확인하세요.
나쁜 날을 기다리지 않고 크래시를 보고 싶나요? macOS나 Linux에서는 한 번 실행에 좁은 인코딩을 강제하세요:
PYTHONIOENCODING=ascii python -c "print('Привет')"위 오류와 같은 계열인 ascii 코덱 메시지와 함께 실패합니다. Windows에서는 대화형 콘솔에서는 이 변수가 무시되지만, 출력이 리다이렉트되면 동작합니다. cmd에서 set PYTHONIOENCODING=ascii을 실행한 뒤 python -을 실행하세요(PowerShell에서는 $env:PYTHONIOENCODING = "ascii").
해결책 1: UTF-8 모드 켜기#
Python에는 텍스트의 기본값을 UTF-8로 만드는 모드가 있습니다. Python 문서(명령줄 페이지, 2026년 11월 5일 확인)에 따르면 PYTHONUTF8=1가 이를 켜고 -X utf8도 같은 역할을 하며, 둘 다 Python 3.7부터 존재합니다. 같은 페이지의 주의점 하나: PYTHONUTF8의 다른 비어 있지 않은 값은 시작 시 오류를 일으키므로 정확히 1를 사용하세요(끄려면 0). 3.15에서는 구형 인터프리터에서 모드를 명시적으로 켤 때만 필요합니다. 이미 켜져 있다면 환경에서 PYTHONUTF8=0를 찾아보세요.
한 번 실행에 UTF-8 모드 켜기
cmd
set PYTHONUTF8=1
python app.py
PowerShell
$env:PYTHONUTF8 = "1"
python app.py
macOS / Linux
PYTHONUTF8=1 python app.py코드 변경 없이 그 실행의 콘솔, 리다이렉트, 파일을 모두 커버합니다. 매번 변수를 설정하고 싶지 않다면 python -이 명령줄에서 같은 결과를 냅니다.
stdin, stdout, stderr의 인코딩만 재정의하는 PYTHONIOENCODING=utf-도 있습니다. Windows에서 의존하기 전에 문서 항목을 읽어 보세요. Python 3.6부터 PYTHONLEGACYWINDOWSSTDIO이 설정되지 않으면 대화형 콘솔 버퍼에서는 무시됩니다. 리다이렉트된 파일과 파이프는 이 예외의 영향을 받지 않습니다. 따라서 python app.는 고치면서 콘솔 창에서는 아무 효과가 없을 수 있습니다. stderr의 오류 핸들러는 항상 backslashreplace입니다.
해결책 2: 스크립트 안에서 stdout 재구성하기#
사람들이 스크립트를 어떻게 시작하는지 제어할 수 없다면, 맨 위에서 스트림 자체를 바꾸세요:
import sys

sys.stdout.reconfigure(encoding="utf-8")
sys.stderr.reconfigure(encoding="utf-8")

print(reply)reconfigure은 io.TextIOWrapper에 대해 문서화되어 있습니다(3.7에서 추가). encoding를 넘기고 errors을 생략하면 핸들러가 strict이므로, 맞지 않는 문자는 여전히 예외를 발생시킵니다. UTF-8의 일반적인 경우에는 남는 문자가 없습니다. 문서의 두 가지 세부 사항: 스트림에서 데이터를 읽은 뒤에는 인코딩을 바꿀 수 없고(쓰기 후에는 가능), encoding="locale"는 3.11부터 지원됩니다.
텍스트를 정말 표시할 수 없는 터미널에서도 스크립트가 절대 죽지 않아야 하나요? errors="replace"을 추가하세요. 그러면 알 수 없는 문자가 실행을 멈추는 대신 ?로 나타납니다. 이는 문제를 고치는 것이 아니라 숨기는 것이므로 로그용으로만 두세요.
해결책 3: 파일에 명시적 인코딩 지정하기#
응답을 저장하는 것도 같은 실패이며, 코드에서는 더 조용합니다:
# before: on Python up to 3.14 this uses the system's default encoding
with open("reply.txt", "w") as f:
    f.write(reply)

# after: the file is UTF-8 on every machine
with open("reply.txt", "w", encoding="utf-8") as f:
    f.write(reply)
파일을 다시 읽을 때도 같은 encoding="utf-8"을 사용하세요. 그렇지 않으면 읽는 과정에서 텍스트가 깨질 수 있습니다.
어떤 해결책을 써야 할까요?#
사례 선택하기
상황을 고르세요
답을 보려면 옵션을 선택하세요
터미널에서 내 스크립트를 직접 실행한다
환경에 PYTHONUTF8=1를 한 번 설정하거나 python -로 시작하세요. 코드는 바뀌지 않습니다.
스크립트를 다른 사람에게 배포한다
맨 위에 sys.을 넣으세요. 그러면 어떻게 실행하든 동작합니다.
크래시가 화면이 아니라 파일에서 발생한다
쓰기와 읽기 모두에 open()에 encoding="utf-8"를 추가하세요.
조합할 수 있습니다. 응답을 출력하고 저장하는 스크립트는 화면에는 해결책 2나 해결책 1이, 파일에는 해결책 3이 필요합니다.
그래도 실패한다면#
- 오류가 다른 줄로 옮겨감. 그러면 실패하는 호출은 다른
print나write입니다. 수정이 그 전에 적용되어야 하므로reconfigure을 맨 위에 두세요. - 오류가
PYTHONUTF8을 언급함. 변수 값이1나0이 아닙니다. 제거하고 다시 설정하세요. - 크래시는 없지만 콘솔에 사각형이나
?이 보임. Python은 유효한 UTF-8을 썼지만 콘솔 글꼴이나 코드 페이지가 표시하지 못하는 것입니다. 파일로 리다이렉트하고 에디터에서 열어 응답이 온전한지 확인하세요. - 오류가
UnicodeEncodeError이 아니라JSONDecodeError임. 다른 문제입니다: 모델 응답에서 JSON을 추출하는 방법을 참고하세요.
위의 요청 코드는 단순한 requests 호출입니다. CheapTokens 문서는 OpenAI SDK에 대한 같은 호출을 보여줍니다. 다른 모델도 같은 수정으로 동작합니다: model 필드를 zai-로 바꾸세요(답변당 최대 8,192 출력 토큰, 390K 컨텍스트). 인코딩 오류는 모델과 무관하며 텍스트가 가는 위치와만 관련이 있습니다.


