استكشاف الأخطاءدليل
UnicodeEncodeError عند طباعة رد LLM في Python: 3 حلول
هل ينهار print(reply) على السيريلية أو الإيموجي؟ اعرف لماذا يفشل Python مع المخرجات المُعاد توجيهها أو صفحة ترميز قديمة، وأصلحه بوضع UTF-8 أو reconfigure أو encoding=.
في هذه الصفحة
تم تمرير طلبك، وأجاب النموذج، ثم انهار Python عند print(reply). واجهة API ليست المسؤولة. الرد سليم؛ المكان الذي تطبع فيه لا يستطيع تمثيل بعض أحرفه. أسرع حل هو تفعيل وضع UTF-8 باستخدام PYTHONUTF8=1. إذا كنت تفضّل إبقاءه داخل السكربت، فاستدعِ sys. في الأعلى، وعند حفظ رد في ملف، مرّر encoding="utf-8" إلى open().
كيف يبدو الخطأ#
لنفترض أنك تسأل نموذجًا سؤالًا بالروسية وتطبع الإجابة. هذا هو السكربت كاملًا، باستخدام استدعاء requests البسيط من دليل الطلب الأول:
import os, requests

r = requests.post(
    "https://api.cheaptokens.dev/v1/chat/completions",
    headers={"Authorization": f"Bearer {os.environ['CHEAPTOKENS_API_KEY']}"},
    json={
        "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
        "messages": [{"role": "user", "content": "Ответь одним предложением: что такое токен?"}],
        "max_tokens": 200,
    },
)
reply = r.json()["choices"][0]["message"]["content"]
print(reply)
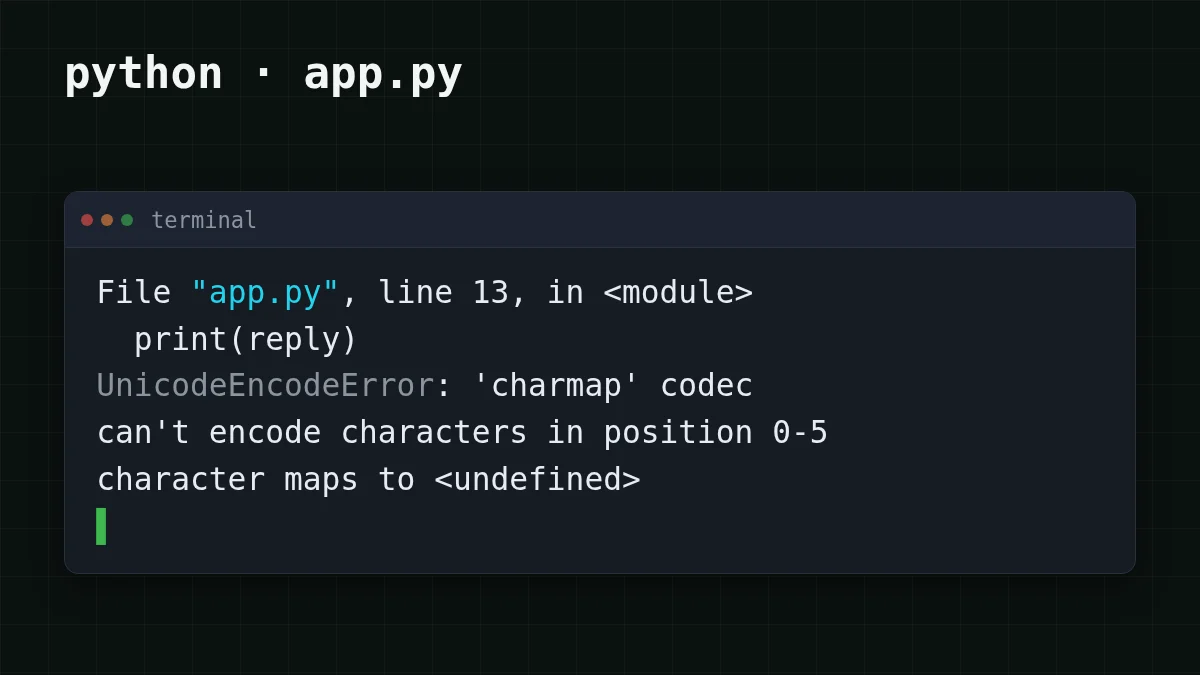
عندما يُعاد توجيه stdout إلى ملف أو أنبوب، أو عندما بدأ Python بصفحة ترميز قديمة لتدفقاته، ينتهي السطر الأخير هكذا:
UnicodeEncodeError: 'charmap' codec can't encode characters in position 0-5: character maps to <undefined>اسم الترميز في رسالتك يعتمد على ترميز التدفق (لصفحة ترميز Windows عادةً charmap، ولـ ascii يكون ascii)، والمواضع تعتمد على الرد. الشكل دائمًا واحد: يشير التتبع إلى print، وليس إلى الطلب.
لماذا يحدث؟ يحوّل print النص إلى بايتات باستخدام ترميز sys.stdout. إذا كان ذلك الترميز صفحة ترميز قديمة، فأي حرف خارجها، مثل السيريلية في صفحة ترميز غربية، أو إيموجي، أو أحيانًا شرطة مطبعية، ليس له بايت يحوَّل إليه. يرفع Python استثناءً بدلًا من التخمين.
يظهر في ثلاث حالات:
- stdout مُعاد توجيهه أو موصول بأنبوب (
python app.،py > out. txt | another program)، أو يعمل السكربت من مجدول أو CI أو محرر حيث stdout ليس طرفية؛ PYTHONLEGACYWINDOWSSTDIOمضبوط، أو يحصل التدفق بطريقة أخرى على ترميز ضيق؛- تكتب الرد إلى ملف باستخدام
open(path, "w")بدونencoding=.
أي Python؟ كل ما يلي يتعلق بـ Python 3.7–3.14، حيث يأتي ترميز التدفق والملف من النظام. وفقًا لـ PEP 686 (الحالة نهائية، https://peps.python.org/pep-0686/, تم التحقق في 5 نوفمبر 2026)، وضع UTF-8 مفعّل افتراضيًا من Python 3.15، لذا open() و stdio يستخدمان UTF-8 هناك بالفعل ما لم يعطّله أحد بـ PYTHONUTF8=0 أو -X utf8=0. تحقق باستخدام python --version.
تحقق من الترميز الذي لديك فعليًا#
قبل أن تغيّر أي شيء، انظر إلى ما اختاره Python. يستغرق عشر ثوانٍ.
جرّب بنفسكجرّبه: ما الذي يعتقده Python عن ترميز stdout لديك؟إظهار الإجابة
شغّل python - في نفس النافذة التي يفشل فيها السكربت. في طرفية تفاعلية عادةً يطبع utf-8، لذا هذا وحده يثبت القليل. شغّله مرة أخرى مع > check.txt في النهاية وافتح الملف: المخرجات المُعاد توجيهها هي ما يعطي غالبًا اسم cp… أو ascii، وهذا هو الجاني. إذا قال كل شيء utf-8، فانظر إلى ملف تكتب فيه.
تريد رؤية الانهيار دون انتظار يوم سيئ؟ على macOS أو Linux، افرض ترميزًا ضيقًا لتشغيل واحد:
PYTHONIOENCODING=ascii python -c "print('Привет')"يفشل ذلك برسالة ترميز ascii، من نفس عائلة الخطأ أعلاه. على Windows يُتجاهل المتغير لطرفية تفاعلية، لكنه يعمل عند إعادة توجيه المخرجات: في cmd شغّل set PYTHONIOENCODING=ascii، ثم python - (في PowerShell: $env:PYTHONIOENCODING = "ascii").
الحل 1: فعّل وضع UTF-8#
لدى Python وضع يجعل UTF-8 الافتراضي للنصوص. وفقًا لوثائق Python (صفحة سطر الأوامر، تم التحقق في 5 نوفمبر 2026)، يفعّله PYTHONUTF8=1 ويفعل -X utf8 الشيء نفسه؛ كلاهما موجود منذ Python 3.7. ملاحظة من نفس الصفحة: أي قيمة أخرى غير فارغة لـ PYTHONUTF8 تسبب خطأ عند بدء التشغيل، لذا استخدم 1 بالضبط (أو 0 لتعطيله). على 3.15 تحتاج هذا فقط لتفعيل الوضع صراحةً على مفسرات أقدم؛ إذا كان مفعّلًا هناك بالفعل، فابحث عن PYTHONUTF8=0 في بيئتك.
فعّل وضع UTF-8 لتشغيل واحد
cmd
set PYTHONUTF8=1
python app.py
PowerShell
$env:PYTHONUTF8 = "1"
python app.py
macOS / Linux
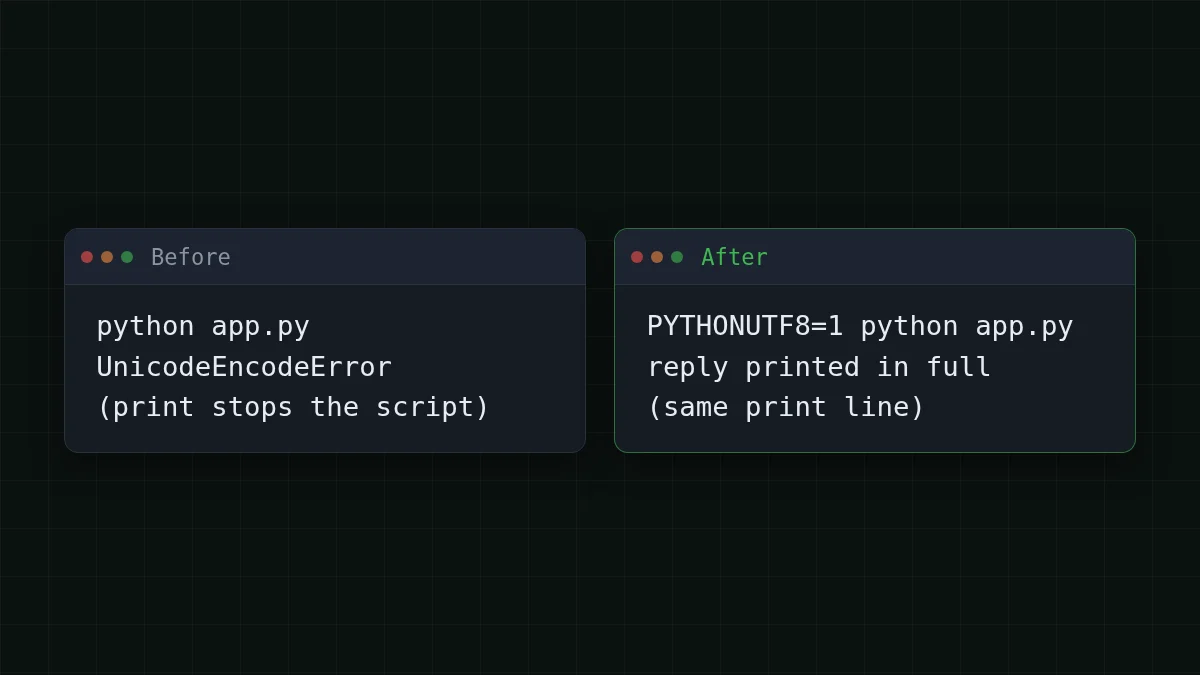
PYTHONUTF8=1 python app.pyلا تغييرات في الكود، ويغطي الطرفية وإعادة التوجيه والملفات في ذلك التشغيل. إذا كنت لا تريد ضبط متغير في كل مرة، يعطي python - نفس النتيجة من سطر الأوامر.
يوجد أيضًا PYTHONIOENCODING=utf-، الذي يتجاوز ترميز stdin و stdout و stderr فقط. اقرأ مدخله في الوثائق قبل الاعتماد عليه على Windows: منذ Python 3.6 يُتجاهل لمخزن طرفية تفاعلية ما لم يكن PYTHONLEGACYWINDOWSSTDIO مضبوطًا. الملفات والأنابيب المُعاد توجيهها لا تتأثر بذلك الاستثناء. لذا يمكنه إصلاح python app. ومع ذلك لا يفعل شيئًا في نافذة الطرفية. بالنسبة لـ stderr، معالج الأخطاء دائمًا backslashreplace.
الحل 2: أعد تكوين stdout داخل السكربت#
إذا لم تستطع التحكم في كيفية بدء الناس للسكربت، فغيّر التدفق نفسه في الأعلى تمامًا:
import sys

sys.stdout.reconfigure(encoding="utf-8")
sys.stderr.reconfigure(encoding="utf-8")

print(reply)
reconfigure موثق لـ io.TextIOWrapper (أضيف في 3.7). عندما تمرر encoding وتترك errors، يكون المعالج strict، لذا لا يزال الحرف الذي لا يتناسب يُرفع؛ في الحالة الشائعة لـ UTF-8 لا يتبقى شيء. تفصيلان من الوثائق: لا يمكن تغيير الترميز بعد قراءة بيانات من التدفق (يمكن بعد الكتابة)، وencoding="locale" مدعوم منذ 3.11.
تحتاج أن لا ينهار السكربت أبدًا، حتى على طرفية لا تستطيع حقًا عرض النص؟ أضف errors="replace". تظهر الأحرف غير المعروفة حينها كـ ? بدلًا من إيقاف التشغيل. هذا يخفي المشكلة بدلًا من إصلاحها، لذا احتفظ به للسجلات.
الحل 3: أعطِ الملفات ترميزًا صريحًا#
حفظ رد هو نفس الفشل، لكنه أهدأ في الكود:
# before: on Python up to 3.14 this uses the system's default encoding
with open("reply.txt", "w") as f:
    f.write(reply)

# after: the file is UTF-8 on every machine
with open("reply.txt", "w", encoding="utf-8") as f:
    f.write(reply)
استخدم نفس encoding="utf-8" عند قراءة الملف مرة أخرى، وإلا فقد ينكسر النص أثناء الدخول بدلًا من ذلك.
أي حل يجب أن تستخدم؟#
اختر حالتك
اختر حالتك
اختر خيارًا لعرض الإجابة
أشغّل سكربتي في طرفية
اضبط PYTHONUTF8=1 مرة واحدة في بيئتك، أو ابدأ بـ python -. لا شيء في الكود يتغير.
أوزّع السكربت على آخرين
ضع sys. في الأعلى، ليعمل كيفما شغّلوه.
الانهيار في ملف، وليس على الشاشة
أضف encoding="utf-8" إلى open()، للكتابة والقراءة.
يمكنك دمجها. السكربت الذي يطبع ويحفظ الردود يحتاج الحل 2 أو الحل 1 للشاشة والحل 3 للملف.
إذا استمر الفشل#
- انتقل الخطأ إلى سطر مختلف. إذن الاستدعاء الفاشل هو
printأوwriteآخر؛ يجب أن يُطبّق الحل قبل تشغيله، لذا ضعreconfigureفي الأعلى تمامًا. - الخطأ يذكر
PYTHONUTF8. للمتغير قيمة غير1أو0. أزله واضبطه مرة أخرى. - لا انهيار، لكنك ترى مربعات أو
?في الطرفية. كتب Python UTF-8 صالحًا؛ خط الطرفية أو صفحة الترميز لا تستطيع عرضه. أعد التوجيه إلى ملف وافتح الملف في محرر للتأكد من أن الرد سليم. - الخطأ هو
JSONDecodeError، وليسUnicodeEncodeError. مشكلة مختلفة: راجع كيفية استخراج JSON من رد نموذج.
كود الطلب أعلاه هو استدعاء requests البسيط؛ وثائق CheapTokens تعرض نفس الاستدعاء لـ OpenAI SDK. نموذج آخر يعمل بنفس الحل: استبدل حقل model بـ zai- (حتى 8,192 رمز إخراج لكل إجابة، سياق 390K). خطأ الترميز لا علاقة له بالنموذج، فقط بالمكان الذي يذهب إليه النص.


