Pemecahan masalahPanduan
UnicodeEncodeError saat mencetak balasan LLM di Python: 3 perbaikan
print(reply) crash pada Sirilik atau emoji? Lihat mengapa Python gagal dengan output yang dialihkan atau code page lama, dan perbaiki dengan mode UTF-8, reconfigure, atau encoding=.
Di halaman ini
Permintaan Anda berhasil, model menjawab, lalu Python mati di print(reply). API tidak bersalah. Balasannya baik-baik saja; tempat Anda mencetaknya tidak dapat merepresentasikan sebagian karakternya. Perbaikan tercepat adalah mengaktifkan mode UTF-8 dengan PYTHONUTF8=1. Jika Anda lebih suka menyimpannya di dalam skrip, panggil sys. di bagian atas, dan saat menyimpan balasan ke file, berikan encoding="utf-8" ke open().
Seperti apa error-nya#
Misalkan Anda mengajukan pertanyaan ke model dalam bahasa Rusia dan mencetak jawabannya. Ini seluruh skripnya, menggunakan panggilan requests biasa dari panduan permintaan pertama kami:
import os, requests

r = requests.post(
    "https://api.cheaptokens.dev/v1/chat/completions",
    headers={"Authorization": f"Bearer {os.environ['CHEAPTOKENS_API_KEY']}"},
    json={
        "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
        "messages": [{"role": "user", "content": "Ответь одним предложением: что такое токен?"}],
        "max_tokens": 200,
    },
)
reply = r.json()["choices"][0]["message"]["content"]
print(reply)
Ketika stdout dialihkan ke file atau pipe, atau Python dijalankan dengan code page lama untuk stream-nya, baris terakhir berakhir seperti ini:
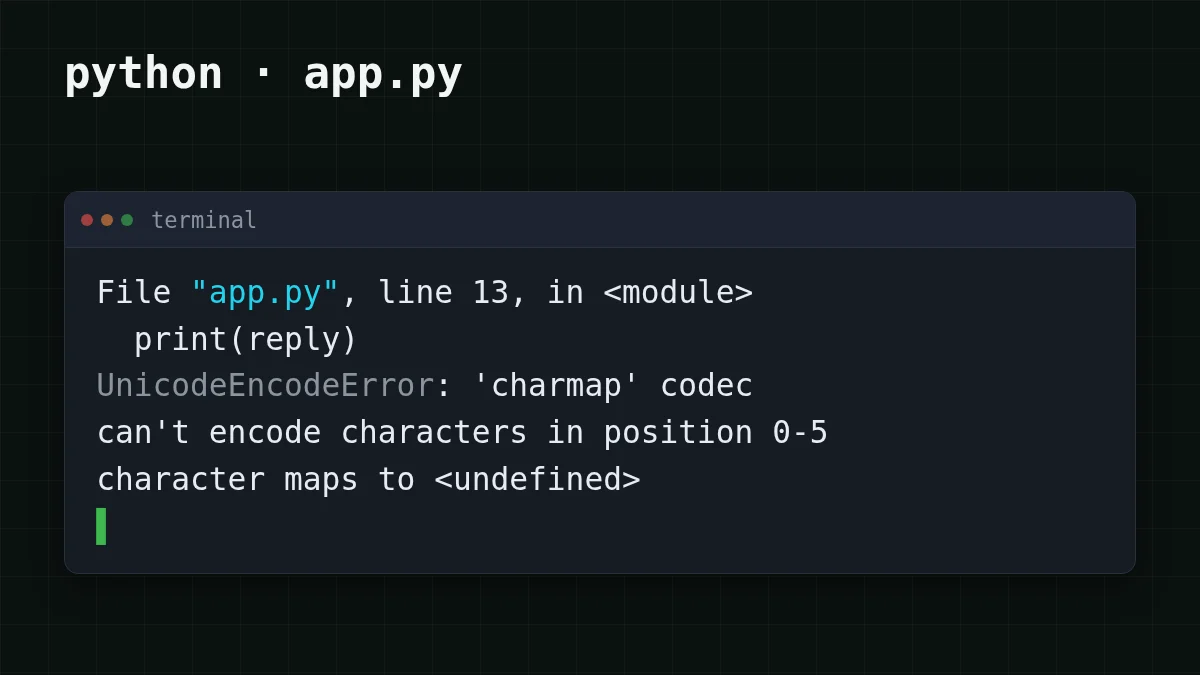
UnicodeEncodeError: 'charmap' codec can't encode characters in position 0-5: character maps to <undefined>Nama codec dalam pesan Anda bergantung pada encoding stream (untuk code page Windows biasanya charmap, untuk ascii adalah ascii), dan posisinya bergantung pada balasan. Bentuknya selalu sama: traceback menunjuk ke print, bukan ke permintaan.
Mengapa terjadi? print mengonversi teks ke byte menggunakan encoding sys.stdout. Jika encoding itu adalah code page lama, karakter apa pun di luarnya, seperti Sirilik dalam code page Barat, emoji, kadang tanda pisah tipografis, tidak memiliki byte untuk dikonversi. Python memunculkan error alih-alih menebak.
Ini muncul dalam tiga situasi:
- stdout dialihkan atau di-pipe (
python app.,py > out. txt | another program), atau skrip dijalankan dari scheduler, CI, atau editor di mana stdout bukan konsol; PYTHONLEGACYWINDOWSSTDIOdiatur, atau stream mendapat encoding sempit dengan cara lain;- Anda menulis balasan ke file dengan
open(path, "w")tanpaencoding=.
Python yang mana? Semua di bawah ini tentang Python 3.7–3.14, di mana encoding stream dan file berasal dari sistem. Menurut PEP 686 (status Final, https://peps.python.org/pep-0686/, diperiksa 5 November 2026), mode UTF-8 aktif secara default mulai Python 3.15, jadi open() dan stdio sudah menggunakan UTF-8 di sana kecuali seseorang mematikannya dengan PYTHONUTF8=0 atau -X utf8=0. Periksa dengan python --version.
Periksa encoding yang sebenarnya Anda miliki#
Sebelum mengubah apa pun, lihat apa yang dipilih Python. Hanya butuh sepuluh detik.
Coba sendiriCoba: menurut Python, apa encoding stdout Anda?Tampilkan jawaban
Jalankan python - di jendela yang sama tempat skrip gagal. Di konsol interaktif biasanya mencetak utf-8, jadi itu saja tidak membuktikan banyak. Jalankan lagi dengan > check.txt di akhir dan buka filenya: output yang dialihkan lebih sering menghasilkan nama cp… atau ascii, dan itulah biang keladinya. Jika semuanya menunjukkan utf-8, periksa file yang Anda tulis.
Ingin melihat crash tanpa menunggu hari buruk? Di macOS atau Linux, paksa encoding sempit untuk satu kali jalan:
PYTHONIOENCODING=ascii python -c "print('Привет')"Itu gagal dengan pesan codec ascii, keluarga yang sama dengan error di atas. Di Windows variabel itu diabaikan untuk konsol interaktif, tetapi berfungsi saat output dialihkan: di cmd jalankan set PYTHONIOENCODING=ascii, lalu python - (di PowerShell: $env:PYTHONIOENCODING = "ascii").
Perbaikan 1: aktifkan mode UTF-8#
Python memiliki mode yang menjadikan UTF-8 sebagai default untuk teks. Menurut dokumentasi Python (halaman command-line, diperiksa 5 November 2026), PYTHONUTF8=1 mengaktifkannya dan -X utf8 melakukan hal yang sama; keduanya ada sejak Python 3.7. Satu catatan dari halaman yang sama: nilai lain yang tidak kosong dari PYTHONUTF8 menyebabkan error saat startup, jadi gunakan tepat 1 (atau 0 untuk mematikannya). Di 3.15 Anda hanya perlu ini untuk mengaktifkan mode secara eksplisit pada interpreter lama; jika sudah aktif di sana, cari PYTHONUTF8=0 di environment Anda.
Aktifkan mode UTF-8 untuk satu kali jalan
cmd
set PYTHONUTF8=1
python app.py
PowerShell
$env:PYTHONUTF8 = "1"
python app.py
macOS / Linux
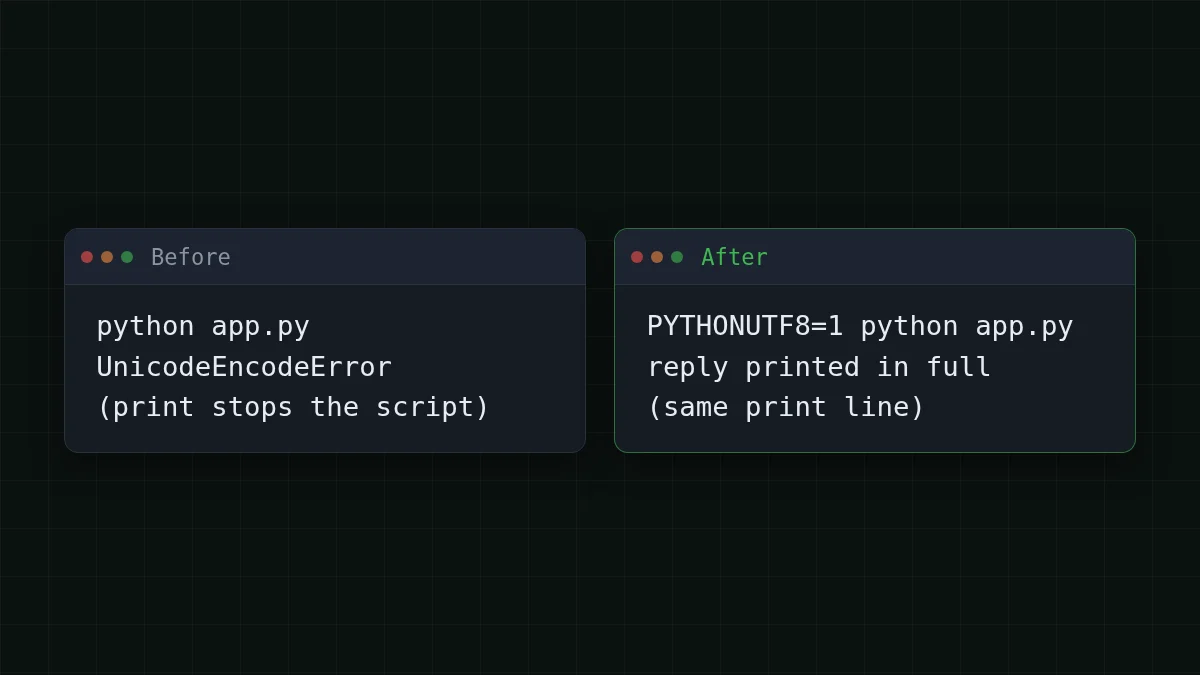
PYTHONUTF8=1 python app.pyTanpa perubahan kode, dan mencakup konsol, pengalihan, dan file dalam jalan itu. Jika Anda tidak ingin mengatur variabel setiap kali, python - memberikan hasil yang sama dari command line.
Ada juga PYTHONIOENCODING=utf-, yang hanya menimpa encoding stdin, stdout, dan stderr. Baca entri dokumentasinya sebelum mengandalkannya di Windows: sejak Python 3.6 ia diabaikan untuk buffer konsol interaktif kecuali PYTHONLEGACYWINDOWSSTDIO diatur. File dan pipe yang dialihkan tidak terpengaruh oleh pengecualian itu. Jadi ia bisa memperbaiki python app. dan tetap tidak melakukan apa pun di jendela konsol. Untuk stderr, error handler-nya selalu backslashreplace.
Perbaikan 2: konfigurasi ulang stdout di dalam skrip#
Jika Anda tidak dapat mengontrol bagaimana orang menjalankan skrip, ubah stream itu sendiri di bagian paling atas:
import sys

sys.stdout.reconfigure(encoding="utf-8")
sys.stderr.reconfigure(encoding="utf-8")

print(reply)
reconfigure didokumentasikan untuk io.TextIOWrapper (ditambahkan di 3.7). Saat Anda memberikan encoding dan membiarkan errors, handler-nya adalah strict, jadi karakter yang tidak cocok tetap memunculkan error; untuk kasus umum UTF-8 tidak ada yang tersisa. Dua detail dari dokumentasi: encoding tidak dapat diubah setelah data dibaca dari stream (bisa setelah penulisan), dan encoding="locale" didukung sejak 3.11.
Perlu skrip agar tidak pernah crash, bahkan di terminal yang benar-benar tidak dapat menampilkan teks? Tambahkan errors="replace". Karakter yang tidak dikenal kemudian muncul sebagai ? alih-alih menghentikan proses. Itu menyembunyikan masalah alih-alih memperbaikinya, jadi simpan untuk log.
Perbaikan 3: berikan encoding eksplisit untuk file#
Menyimpan balasan adalah kegagalan yang sama, hanya lebih senyap di kode:
# before: on Python up to 3.14 this uses the system's default encoding
with open("reply.txt", "w") as f:
    f.write(reply)

# after: the file is UTF-8 on every machine
with open("reply.txt", "w", encoding="utf-8") as f:
    f.write(reply)
Gunakan encoding="utf-8" yang sama saat Anda membaca file kembali, jika tidak teks bisa rusak saat masuk.
Perbaikan mana yang harus Anda gunakan?#
Pilih kasus Anda
Pilih kasus Anda
Pilih opsi untuk melihat jawabannya
Saya menjalankan skrip saya sendiri di terminal
Atur PYTHONUTF8=1 sekali di environment Anda, atau mulai dengan python -. Tidak ada yang berubah di kode.
Saya mengirim skrip ke orang lain
Letakkan sys. di bagian atas, agar berfungsi apa pun cara mereka menjalankannya.
Crash terjadi pada file, bukan di layar
Tambahkan encoding="utf-8" ke open(), untuk menulis dan membaca.
Anda dapat menggabungkannya. Skrip yang mencetak dan menyimpan balasan memerlukan Perbaikan 2 atau Perbaikan 1 untuk layar dan Perbaikan 3 untuk file.
Jika masih gagal#
- Error berpindah ke baris lain. Maka panggilan yang gagal adalah
printatauwritelain; perbaikan harus diterapkan sebelum itu berjalan, jadi letakkanreconfiguredi bagian paling atas. - Error menyebut
PYTHONUTF8. Variabel memiliki nilai selain1atau0. Hapus dan atur ulang. - Tidak crash, tetapi Anda melihat kotak atau
?di konsol. Python menulis UTF-8 yang valid; font atau code page konsol tidak dapat menampilkannya. Alihkan ke file dan buka file di editor untuk memastikan balasan utuh. - Error-nya
JSONDecodeError, bukanUnicodeEncodeError. Masalah berbeda: lihat cara mengekstrak JSON dari balasan model.
Kode permintaan di atas adalah panggilan requests biasa; dokumentasi CheapTokens menunjukkan panggilan yang sama untuk OpenAI SDK. Model lain berfungsi dengan perbaikan yang sama: ganti field model dengan zai- (hingga 8.192 token output per jawaban, konteks 390K). Error encoding tidak ada hubungannya dengan model, hanya dengan ke mana teks itu pergi.


