UnicodeEncodeError al imprimir una respuesta de LLM en Python: 3 soluciones
¿print(reply) falla con cirílico o emoji? Descubre por qué Python falla con salida redirigida o una página de códigos heredada, y soluciónalo con el modo UTF-8, reconfigure o encoding=.
En esta página
Tu solicitud se procesó, el modelo respondió y luego Python falló en print(reply). La API no tiene la culpa. La respuesta está bien; el lugar donde la imprimes no puede representar algunos de sus caracteres. La solución más rápida es activar el modo UTF-8 con PYTHONUTF8=1. Si prefieres mantenerlo dentro del script, llama a sys. al principio, y cuando guardes una respuesta en un archivo, pasa encoding="utf-8" a open().
Cómo se ve el error#
Supón que le haces una pregunta a un modelo en ruso e imprimes la respuesta. Este es el script completo, usando la llamada simple a requests de nuestra guía de primera solicitud:
import os, requests

r = requests.post(
    "https://api.cheaptokens.dev/v1/chat/completions",
    headers={"Authorization": f"Bearer {os.environ['CHEAPTOKENS_API_KEY']}"},
    json={
        "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
        "messages": [{"role": "user", "content": "Ответь одним предложением: что такое токен?"}],
        "max_tokens": 200,
    },
)
reply = r.json()["choices"][0]["message"]["content"]
print(reply)
Cuando stdout se redirige a un archivo o tubería, o Python se inició con una página de códigos heredada para sus flujos, la última línea termina así:
UnicodeEncodeError: 'charmap' codec can't encode characters in position 0-5: character maps to <undefined>El nombre del códec en tu mensaje depende de la codificación del flujo (para una página de códigos de Windows suele ser charmap, para ascii es ascii), y las posiciones dependen de la respuesta. La forma es siempre la misma: el traceback apunta a print, no a la solicitud.
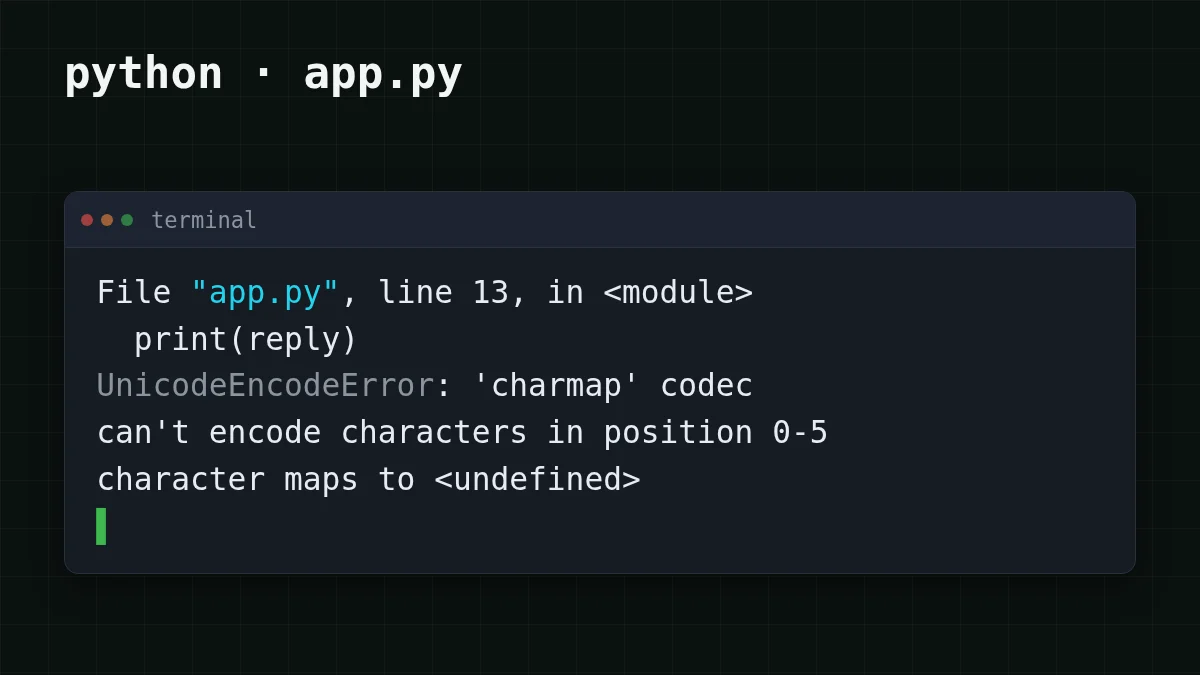
¿Por qué ocurre? print convierte el texto a bytes usando la codificación de sys.stdout. Si esa codificación es una página de códigos heredada, cualquier carácter fuera de ella, como cirílico en una página de códigos occidental, un emoji, a veces un guion tipográfico, no tiene byte al que convertirse. Python lanza una excepción en lugar de adivinar.
Aparece en tres situaciones:
- stdout se redirige o se canaliza (
python app.,py > out. txt | another program), o el script se ejecuta desde un programador de tareas, CI o un editor donde stdout no es una consola; PYTHONLEGACYWINDOWSSTDIOestá establecido, o el flujo recibe de otro modo una codificación estrecha;- escribes la respuesta en un archivo con
open(path, "w")y sinencoding=.
¿Qué Python? Todo lo siguiente se refiere a Python 3.7–3.14, donde la codificación de flujos y archivos proviene del sistema. Según PEP 686 (estado Final, https://peps.python.org/pep-0686/, comprobado el 5 de noviembre de 2026), el modo UTF-8 está activado por defecto desde Python 3.15, así que open() y stdio ya usan UTF-8 allí a menos que alguien lo haya desactivado con PYTHONUTF8=0 o -X utf8=0. Compruébalo con python --version.
Comprueba qué codificación tienes realmente#
Antes de cambiar nada, mira lo que eligió Python. Toma diez segundos.
Pruébalo tú mismoPruébalo: ¿qué cree Python que es tu codificación de stdout?Mostrar respuesta
Ejecuta python - en la misma ventana donde falla el script. En una consola interactiva normalmente imprime utf-8, así que eso solo prueba poco. Ejecútalo de nuevo con > check.txt al final y abre el archivo: la salida redirigida es lo que más a menudo da un nombre cp… o ascii, y ese es tu culpable. Si todo dice utf-8, mira un archivo en el que escribas.
¿Quieres ver el fallo sin esperar a un mal día? En macOS o Linux, fuerza una codificación estrecha para una ejecución:
PYTHONIOENCODING=ascii python -c "print('Привет')"Eso falla con un mensaje de códec ascii, de la misma familia que el error anterior. En Windows la variable se ignora para una consola interactiva, pero funciona cuando la salida se redirige: en cmd ejecuta set PYTHONIOENCODING=ascii, luego python - (en PowerShell: $env:PYTHONIOENCODING = "ascii").
Solución 1: activar el modo UTF-8#
Python tiene un modo que hace que UTF-8 sea el predeterminado para texto. Según la documentación de Python (página de línea de comandos, comprobada el 5 de noviembre de 2026), PYTHONUTF8=1 lo activa y -X utf8 hace lo mismo; ambos existen desde Python 3.7. Una advertencia de la misma página: cualquier otro valor no vacío de PYTHONUTF8 provoca un error al iniciar, así que usa exactamente 1 (o 0 para desactivarlo). En 3.15 solo necesitas esto para habilitar el modo explícitamente en intérpretes más antiguos; si ya está activado allí, busca PYTHONUTF8=0 en tu entorno.
Activar el modo UTF-8 para una ejecución
cmd
set PYTHONUTF8=1
python app.py
PowerShell
$env:PYTHONUTF8 = "1"
python app.py
macOS / Linux
PYTHONUTF8=1 python app.pySin cambios en el código, y cubre la consola, las redirecciones y los archivos en esa ejecución. Si no quieres establecer una variable cada vez, python - da el mismo resultado desde la línea de comandos.
También existe PYTHONIOENCODING=utf-, que anula la codificación solo de stdin, stdout y stderr. Lee su entrada de documentación antes de confiar en ella en Windows: desde Python 3.6 se ignora para un búfer de consola interactiva a menos que PYTHONLEGACYWINDOWSSTDIO esté establecido. Los archivos redirigidos y las tuberías no se ven afectados por esa excepción. Así que puede corregir python app. y seguir sin hacer nada en la ventana de la consola. Para stderr, el manejador de errores es siempre backslashreplace.
Solución 2: reconfigurar stdout dentro del script#
Si no puedes controlar cómo inician el script otras personas, cambia el flujo mismo al principio:
import sys

sys.stdout.reconfigure(encoding="utf-8")
sys.stderr.reconfigure(encoding="utf-8")

print(reply)
reconfigure está documentado para io.TextIOWrapper (añadido en 3.7). Cuando pasas encoding y omites errors, el manejador es strict, así que un carácter que no encaja sigue lanzando una excepción; para el caso común de UTF-8 no queda nada. Dos detalles de la documentación: la codificación no se puede cambiar una vez que se han leído datos del flujo (sí se puede después de una escritura), y encoding="locale" es compatible desde 3.11.
¿Necesitas que el script nunca falle, incluso en un terminal que realmente no puede mostrar el texto? Añade errors="replace". Los caracteres desconocidos aparecen entonces como ? en lugar de detener la ejecución. Eso oculta el problema en lugar de corregirlo, así que resérvalo para registros.
Solución 3: dar a los archivos una codificación explícita#
Guardar una respuesta es el mismo fallo, solo que más silencioso en el código:
# before: on Python up to 3.14 this uses the system's default encoding
with open("reply.txt", "w") as f:
    f.write(reply)

# after: the file is UTF-8 on every machine
with open("reply.txt", "w", encoding="utf-8") as f:
    f.write(reply)
Usa el mismo encoding="utf-8" cuando vuelvas a leer el archivo, de lo contrario el texto puede romperse al entrar.
¿Qué solución deberías usar?#
Elige tu caso
Elige tu caso
Elige una opción para ver la respuesta
Ejecuto mi propio script en un terminal
Establece PYTHONUTF8=1 una vez en tu entorno, o inicia con python -. Nada en el código cambia.
Distribuyo el script a otras personas
Pon sys. al principio, para que funcione sin importar cómo lo inicien.
El fallo es en un archivo, no en pantalla
Añade encoding="utf-8" a open(), tanto para escribir como para leer.
Puedes combinarlas. Un script que imprime y guarda respuestas necesita la Solución 2 o la Solución 1 para la pantalla y la Solución 3 para el archivo.
Si sigue fallando#
- El error se movió a una línea diferente. Entonces la llamada que falla es otro
printowrite; la solución debe aplicarse antes de que se ejecute, así que ponreconfigureal principio. - El error menciona
PYTHONUTF8. La variable tiene un valor distinto de1o0. Elimínala y vuelve a establecerla. - No hay fallo, pero ves cuadrados o
?en la consola. Python escribió UTF-8 válido; la fuente o página de códigos de la consola no puede mostrarlo. Redirige a un archivo y abre el archivo en un editor para confirmar que la respuesta está intacta. - El error es un
JSONDecodeError, noUnicodeEncodeError. Problema diferente: consulta cómo extraer JSON de una respuesta de modelo.
El código de solicitud anterior es la llamada simple a requests; la documentación de CheapTokens muestra la misma llamada para el SDK de OpenAI. Otro modelo funciona con la misma solución: cambia el campo model por zai- (hasta 8.192 tokens de salida por respuesta, contexto de 390K). El error de codificación no tiene nada que ver con el modelo, solo con el destino del texto.


