Primeros pasosGuía
Primera petición a CheapTokens en Python con requests, sin SDK
Un script de Python de 20 líneas solo con requests: una finalización de chat, un timeout, manejo de errores HTTP y la respuesta, finish_reason y usage impresos.
En esta página
No necesitas el paquete openai para hablar con una API compatible con OpenAI. Una llamada requests.post, una clave Bearer y un cuerpo JSON son suficientes, y además ves exactamente qué viaja por la red. Esta guía construye ese script para CheapTokens (https:/) y termina con él imprimiendo la respuesta, finish_reason y el uso de tokens.
Es una buena opción si estás en una máquina restringida donde solo está instalado requests, si un pequeño cron job no debería arrastrar un SDK, o si simplemente quieres entender qué hace el SDK por ti. La guía de la primera petición cubre las rutas del SDK, curl y Node; esta es la de Python puro.
El script completo#
Primero pon tu clave en una variable de entorno (consulta cómo almacenar una clave de API de forma segura), luego guarda esto como ask.py:
import os
import requests

url = "https://api.cheaptokens.dev/v1/chat/completions"
headers = {"Authorization": f"Bearer {os.environ['CHEAPTOKENS_API_KEY']}"}
payload = {
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [
        {"role": "user", "content": "Explain what a token is in two sentences."}
    ],
    "max_tokens": 200,
}

try:
    r = requests.post(url, headers=headers, json=payload, timeout=30)
    r.raise_for_status()
except requests.exceptions.Timeout:
    raise SystemExit("No reply within 30 seconds - try again or raise the timeout")
except requests.exceptions.HTTPError as e:
    raise SystemExit(f"HTTP {e.response.status_code}: {e.response.text}")

data = r.json()
choice = data["choices"][0]
print(choice["message"]["content"])
print("finish_reason:", choice["finish_reason"])
print("usage:", data["usage"])
Ejecuta python ask.py. El id del modelo es el id completo del gateway, deepseek-; si no estás seguro de qué poner ahí, lista los modelos con GET /v1/models. Para probar otro modelo, cambia a zai- y no modifiques nada más: un solo saldo cubre todos los modelos.
Qué hace cada línea#
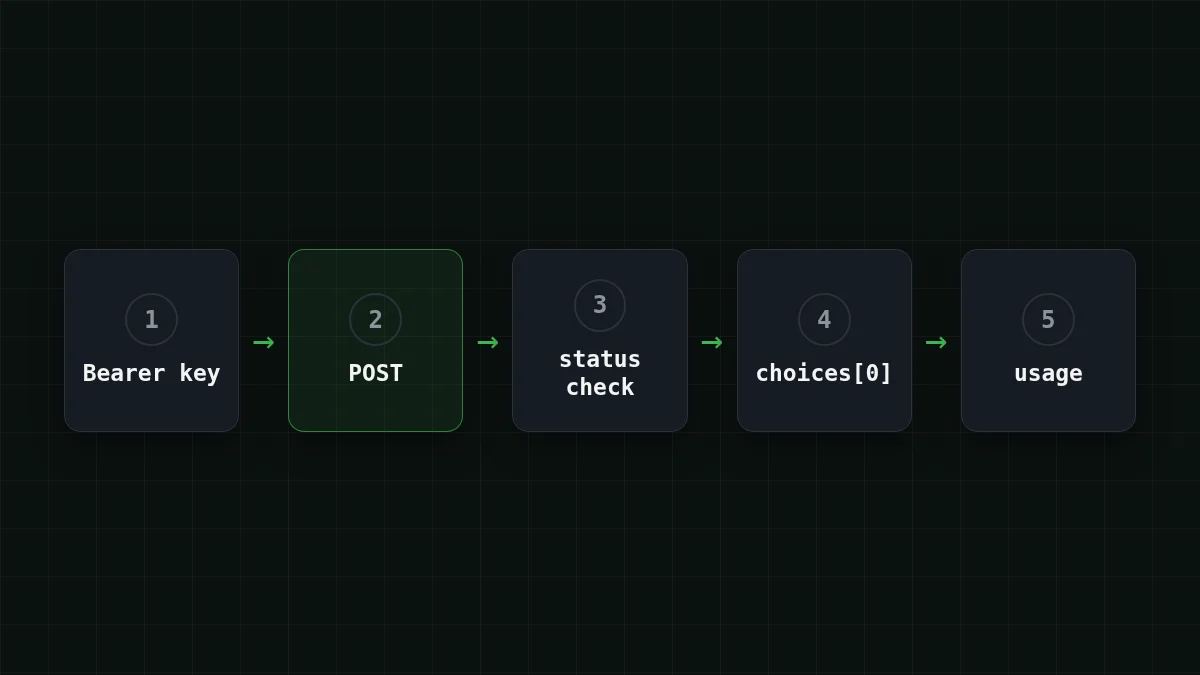
Estas son las cinco ideas en las que se apoya el script. El Quickstart de requests (documentación viva, revisada el 2 de noviembre de 2026) explica la mayoría, y la referencia de Chat Completions de OpenAI define los campos de la respuesta.
Tarjetas de memoria
Cinco cosas en el script
Toca una tarjeta para voltearla
El tercer punto es el que la gente omite. Un script que se cuelga para siempre en un cron job es mucho peor que uno que falla ruidosamente después de 30 segundos.
Leer la respuesta#
Una respuesta exitosa es JSON. Las partes que te importan, según la referencia de Chat Completions:
choices[0].es el texto. Puede sermessage. content null, así que no le apliques métodos de cadena a ciegas.choices[0].indica por qué se detuvo el modelo:finish_ reason stop(terminó),length(el límitemax_tokenslo cortó),tool_calls,content_filter.usage.,prompt_ tokens usage.ycompletion_ tokens usage.son lo que se te factura: entrada, salida y su suma.total_ tokens
La respuesta tiene esta forma (los números son marcadores de posición):
{
  "choices": [
    {
      "message": {"role": "assistant", "content": "A token is a small piece of text..."},
      "finish_reason": "stop"
    }
  ],
  "usage": {"prompt_tokens": 18, "completion_tokens": 52, "total_tokens": 70}
}
Pruébalo tú mismoPruébalo: establece max_tokens en 5 y ejecuta el script de nuevo. ¿Qué dice finish_reason?Mostrar respuesta
Dice length: el modelo se detuvo por tu límite max_tokens, así que la respuesta termina a mitad de frase. Sube el límite y vuelves a obtener stop. La historia completa está en ¿Respuesta de IA cortada? Soluciona finish_reason "length".
Cuando no funciona#
El script convierte la mayoría de los fallos en una línea de salida. Esto es lo que suele significar cada uno:
Emparejar los pares
Relaciona cada mensaje con su causa habitual
Toca un elemento de la izquierda, luego su par
- HTTP 401La clave falta, está mal escrita o no es la que querías enviar
- HTTP 404La ruta de la URL o el id del modelo es incorrecto
- requests.exceptions.TimeoutNo llegaron bytes dentro del tiempo de espera
- KeyError: 'CHEAPTOKENS_API_KEY'La variable de entorno no está establecida en esta terminal
Para ver los cuerpos de error reales y una comprobación paso a paso de la clave, la URL base y el id del modelo, usa Error 401 o 404 de API: clave, URL base o id de modelo incorrectos. Dos trampas menores: si ves KeyError: 'choices', analizaste un cuerpo de error como si fuera un éxito, lo que significa que se omitió raise_. Y si tu máquina tiene un archivo ~/.netrc, requests puede usar sus credenciales en lugar de la cabecera Authorization que estableciste.
Cuánto cuesta una llamada#
Con los números de marcador de posición de la respuesta anterior (unos 18 tokens de entrada, 52 de salida), una llamada a DeepSeek-V4-Flash cuesta $0.0000055. Es una cifra que no puedes percibir, así que escálala. Digamos que tu script resume 1.000 tickets de soporte al día, aproximadamente 800 tokens de entrada y 300 de salida cada uno:
| Modelo | Entrada $/1M | Salida $/1M | Por solicitud | 1000 solicitudes | OpenRouter, 1000 solicitudes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.028 | $0.0517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.042 | $0.098 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.085 | $1.02 |
800 tokens de entrada y 300 tokens de salida por solicitud. Los precios por 1M de tokens son actuales y cambian junto con nuestras tarifas; la columna de OpenRouter muestra precios de referencia para la misma carga de trabajo.
Los precios son fijos por modelo, sin horas punta, así que el mismo script cuesta lo mismo a las 3 de la madrugada que al mediodía. Los precios actuales por modelo están en la página de precios, y la documentación enumera los endpoints.
A dónde ir desde aquí#
Una vez que esto funciona, los siguientes pasos habituales son un bucle sobre muchas entradas, un reintento ante 429 (consulta 429 Too Many Requests: reintentos con backoff), o la misma llamada con streaming. Si prefieres no gestionar HTTP tú mismo, la ruta del SDK está a un cambio de base_url de distancia.


