API y SDKGuía
Genera una herramienta HTML desde un prompt con una API (Python)
Un script de Python que convierte un prompt en un tool.html funcional, detecta una respuesta cortada mediante finish_reason e imprime tokens y coste.
En esta página
Puedes obtener una herramienta funcional de un solo archivo con una sola llamada a la API: envía un prompt bien estructurado, asegúrate de que max_tokens sea lo bastante grande para una página completa, comprueba que finish_reason sea stop y guarda la respuesta como tool.html. Abajo está el script que hace exactamente eso, y una plantilla de prompt que puedes adaptar para tu propia herramienta.
La idea es simple, y DeepSeek acaba de mostrarla. Publicó una colección de siete prompts de demostración para Creator Mode en DeepSeek Harness (la página, consultada el 3 de noviembre de 2026): una galería de hitos 3D, un banco de trabajo de pósteres, un banco de trabajo de edición de vídeo, un lector de artículos, un panel de estadísticas de conversación y algunos más. Creator Mode vive dentro de la app Harness. Si quieres el mismo flujo de "prompt dentro, herramienta fuera" en tu propio script y con tu propia clave, una chat completion normal basta para el caso de un solo archivo. Si usas Harness directamente, conectarlo a CheapTokens es una guía breve aparte.
Qué necesita un prompt de "constrúyeme una herramienta"#
Lee algunos de esos prompts de demostración y aparece un patrón. Cada uno dice qué es la herramienta, qué hay en pantalla, qué hacen los controles, cuál es el estado inicial y qué no debe hacer. Omite uno de esos y el modelo rellena el hueco con su propia suposición, que normalmente no es la tuya.
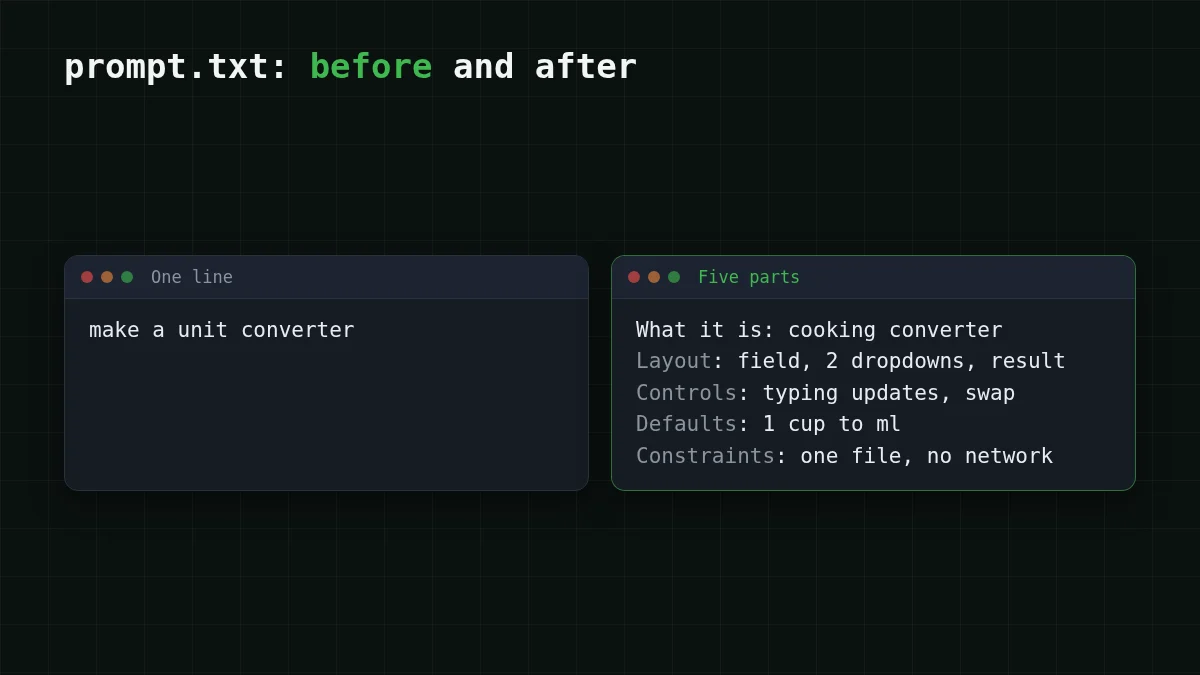
Aquí está la plantilla, cinco partes:
What it is: <one sentence: the tool and who uses it>
Layout: <what is on the screen, top to bottom>
Controls: <every input and button, and what each one does>
Defaults: <what the page shows before the user touches anything>
Constraints: <single HTML file, no external requests, no libraries, size of the page>
Y una versión rellenada. Digamos que conviertes medidas de cocina continuamente y estás cansado de buscar un conversor:
What it is: a unit converter for cooking, for someone standing in a kitchen with a phone.
Layout: a title, one number field, two dropdowns (from, to), a large result line under them.
Controls: the dropdowns hold cup, tablespoon, teaspoon, ml, oz, g (flour) and g (sugar). Typing a number updates the result immediately. A swap button exchanges the two dropdowns.
Defaults: 1 cup to ml, result already shown.
Constraints: one HTML file with inline CSS and JavaScript, no external libraries, fonts or network requests, works on a narrow phone screen, dark text on a light background.
Guarda eso como prompt.txt junto al script. La línea "Constraints" es la que más peso tiene: sin "no external requests" al modelo le gusta traer una librería de CDN, y entonces la página se rompe sin conexión.
El script: petición, comprobación, guardado#
La API de CheapTokens es compatible con OpenAI Chat Completions en https:/, así que el paquete openai funciona con dos cambios: la URL base y la clave. Para una página completa usamos deepseek-: permite hasta 32.768 tokens de salida por respuesta y tiene una ventana de contexto de 380K. Los detalles completos de la API están en la documentación de CheapTokens.
Instala el paquete, pon tu clave en una variable de entorno y configura los dos precios de la tabla de precios (el script los usa para imprimir el coste):
pip install openai
export CHEAPTOKENS_API_KEY="your-key"
export PRICE_IN_PER_M="<input price per 1M from the table>"
export PRICE_OUT_PER_M="<output price per 1M from the table>"
Luego make_tool.py:
import os
import re
import sys

from openai import OpenAI

MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
PRICE_IN = float(os.environ['PRICE_IN_PER_M'])    # USD per 1M input tokens (from the table)
PRICE_OUT = float(os.environ['PRICE_OUT_PER_M'])  # USD per 1M output tokens (from the table)
FENCE = '`' * 3

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

prompt = open('prompt.txt', encoding='utf-8').read()

resp = client.chat.completions.create(
    model=MODEL,
    max_tokens=16000,
    messages=[
        {'role': 'system', 'content': 'You write one self-contained HTML file. Reply with the file only, no commentary.'},
        {'role': 'user', 'content': prompt},
    ],
)

choice = resp.choices[0]
if choice.finish_reason == 'length':
    sys.exit('Cut off at max_tokens: the page is unfinished. Raise max_tokens or shrink the request.')

text = choice.message.content or ''
m = re.search(FENCE + r'(?:html)?\s*(.*?)' + FENCE, text, re.DOTALL)
html = (m.group(1) if m else text).strip()
if '</html>' not in html.lower():
    sys.exit('The reply has no closing </html>; not saving it.')

with open('tool.html', 'w', encoding='utf-8') as f:
    f.write(html)

u = resp.usage
cost = (u.prompt_tokens * PRICE_IN + u.completion_tokens * PRICE_OUT) / 1_000_000
print(f'saved tool.html, {u.prompt_tokens} in / {u.completion_tokens} out, about ${cost:.6f}')
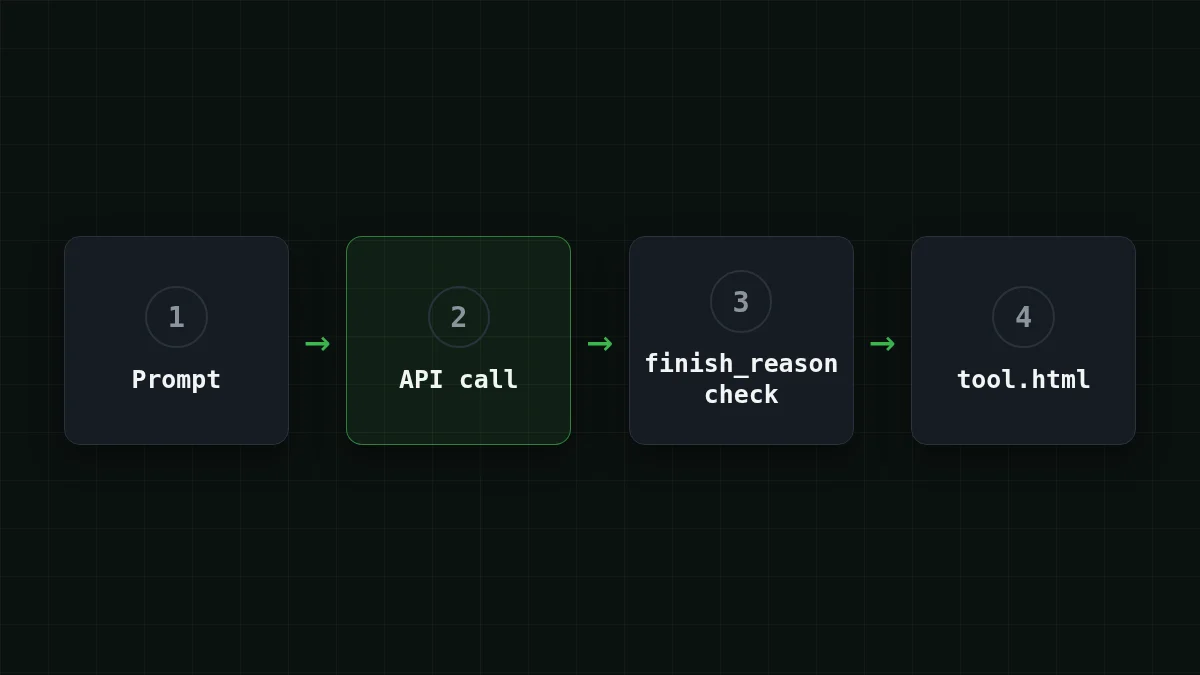
El orden de los pasos importa, y es fácil equivocarse:
Poner en orden
Pon los pasos del script en el orden en que los ejecuta
Arrastra los elementos o usa las flechas
- Enviar el prompt con un max_tokens generoso
- Comprobar finish_reason antes de tocar el texto
- Extraer el HTML del bloque de código, si lo hay
- Confirmar que está el </html> de cierre
- Guardar tool.html e imprimir el uso
Por qué max_tokens decide si la página funciona#
Una página interactiva completa es una respuesta larga. HTML, CSS y JavaScript se acumulan rápido, y el modelo los escribe en ese orden: si la respuesta se corta, pierdes primero el final del script, que es justo la parte que hace funcionar los botones. El navegador puede abrir la página igualmente. Simplemente no hace nada.
Por eso el script comprueba finish_reason antes de mirar el texto. stop significa que el modelo terminó por su cuenta. length significa que alcanzó el límite de max_tokens a mitad del archivo. La versión general de este problema se trata en ¿Respuesta de IA cortada? Arregla finish_reason length; aquí la regla es corta: nunca guardes una página cuyo finish_reason sea length.
Si lo ves:
- sube
max_tokens(DeepSeek-V4-Flash permite hasta 32.768 por respuesta); - o pide menos: menos controles, una sola pantalla, sin animaciones;
- en GLM-5.3-Flash (
zai-) el límite es de 8.192 tokens de salida, así que ese modelo sirve para herramientas pequeñas, como el conversor de arriba.org/ GLM- 5. 3- Flash
La segunda comprobación, </html> en el texto, detecta el fallo más silencioso, cuando un modelo termina la respuesta con educación sin acabar el archivo. Configurar max_tokens tampoco hace que el modelo escriba más: solo es un límite, y pagas por los tokens realmente producidos (más sobre esto en Recortar tokens de salida).
Verificación rápida
El script imprimió finish_reason = length. ¿Qué haces?
Mostrar respuesta
Respuesta: No guardarlo; sube max_tokens o reduce la petición
length significa que la respuesta se cortó en el límite, así que falta el final del script. Un límite más bajo hace que el corte llegue antes.
Ábrela y mira la página#
Abre tool.html haciendo doble clic, o desde la terminal: open tool.html en macOS, xdg- en Linux, start tool.html en Windows.
Esto es código que un modelo escribió para ti, así que dedica un minuto antes de confiar en él. Abre las herramientas de desarrollo del navegador (F12), mira la pestaña Network y recarga: con la restricción "no external requests" debería quedarse vacía. Luego pulsa cada control de la parte "Controls" de tu prompt una vez.
Si algo falla, no regeneres desde cero. Añade una frase al prompt sobre lo concreto ("el botón de intercambio también debe intercambiar los dos valores") y ejecuta de nuevo. La propia página de DeepSeek señala que algunas de sus demos se refinaron a lo largo de varias rondas de conversación, así que una segunda pasada es normal.
Pruébalo tú mismoPruébalo: ¿qué esperas ver en la pestaña Network para el conversor?Mostrar respuesta
Nada: la página es un solo archivo con CSS y JavaScript en línea, así que tras la primera carga no hay más peticiones. Si ves una petición a un CDN, el modelo ignoró la restricción; añádela al prompt en mayúsculas y ejecuta de nuevo.
Cuánto cuesta una generación#
Digamos que el prompt son unos 600 tokens de entrada y la página terminada son unos 6.000 tokens de salida (una suposición para una herramienta de tamaño medio; tu propia línea usage mostrará los números reales). Una ejecución en DeepSeek-V4-Flash es $0.00061, y en GLM-5.3-Flash $0.00025. Ambas son cifras en vivo de la lista de precios actual, y en total, contando entrada y salida juntas, ambas son más baratas que OpenRouter.
| Modelo | Entrada $/1M | Salida $/1M | Costo | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00025 | $0.00052 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00061 | $0.00088 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00093 | $0.0112 |
600 tokens de entrada y 6000 tokens de salida en total. Los precios por 1M de tokens son actuales y cambian junto con nuestras tarifas; la columna de OpenRouter muestra precios de referencia para la misma carga de trabajo.
En la práctica no acertarás con la herramienta al primer intento, así que piensa en iteraciones: diez ajustes del prompt son diez veces esa línea, aún una suma pequeña para una herramienta que de otro modo escribirías a mano. Casi todo es el lado de la salida, la página en sí, por lo que reducir la petición (menos controles) acorta la respuesta y la factura.
Si no funciona#
Desplaza la tabla hacia la derecha →
| Qué ves | Causa probable | Qué hacer |
|---|---|---|
401 o 404 de la API |
clave, URL base o id de modelo incorrectos | comprueba los tres, ver Error 401 o 404 de la API |
Cut off at max_ |
página más larga que el límite | sube max_tokens o pide menos |
The reply has no closing </ |
el modelo se detuvo antes o añadió texto | ejecuta de nuevo; añade "end with </html>" al prompt |
| La página se abre pero los botones no hacen nada | error de JavaScript | abre la consola (F12), pega el error en rojo en un prompt de seguimiento |
Si quieres que la respuesta del modelo se analice como datos en lugar de como página, el truco de extracción es el mismo que en json.JSONDecodeError en una respuesta de LLM. ¿Nuevo en la API? Empieza con tu primera petición a la API.


