API e SDKGuida
Genera uno strumento HTML da un solo prompt con un'API (Python)
Uno script Python che trasforma un prompt in un tool.html funzionante, intercetta una risposta troncata tramite finish_reason e stampa token e costo.
In questa pagina
Puoi ottenere uno strumento funzionante in un singolo file da una sola chiamata API: invia un prompt ben strutturato, assicurati che max_tokens sia abbastanza grande per un'intera pagina, verifica che finish_reason sia stop e salva la risposta come tool.html. Qui sotto c'è lo script che fa esattamente questo, e un template di prompt che puoi adattare al tuo strumento.
L'idea è semplice, e DeepSeek l'ha appena dimostrata. Ha pubblicato una raccolta di sette prompt demo per la Creator Mode in DeepSeek Harness (la pagina, verificata il 3 novembre 2026): una galleria di landmark 3D, un banco di lavoro per poster, un banco di lavoro per il montaggio video, un lettore di paper, una dashboard di statistiche sulle conversazioni e qualche altro. La Creator Mode vive dentro l'app Harness. Se vuoi lo stesso flusso "prompt in, tool out" nel tuo script e con la tua chiave, una normale chat completion basta per il caso del singolo file. Se invece usi Harness stesso, collegarlo a CheapTokens è una guida breve a parte.
Cosa serve a un prompt "costruiscimi uno strumento"#
Leggi un paio di quei prompt demo e salta fuori un pattern. Ognuno dice cos'è lo strumento, cosa c'è sullo schermo, cosa fanno i controlli, qual è lo stato iniziale e cosa non deve fare. Se ne salti uno, il modello riempie il vuoto con una sua ipotesi, che di solito non è la tua.
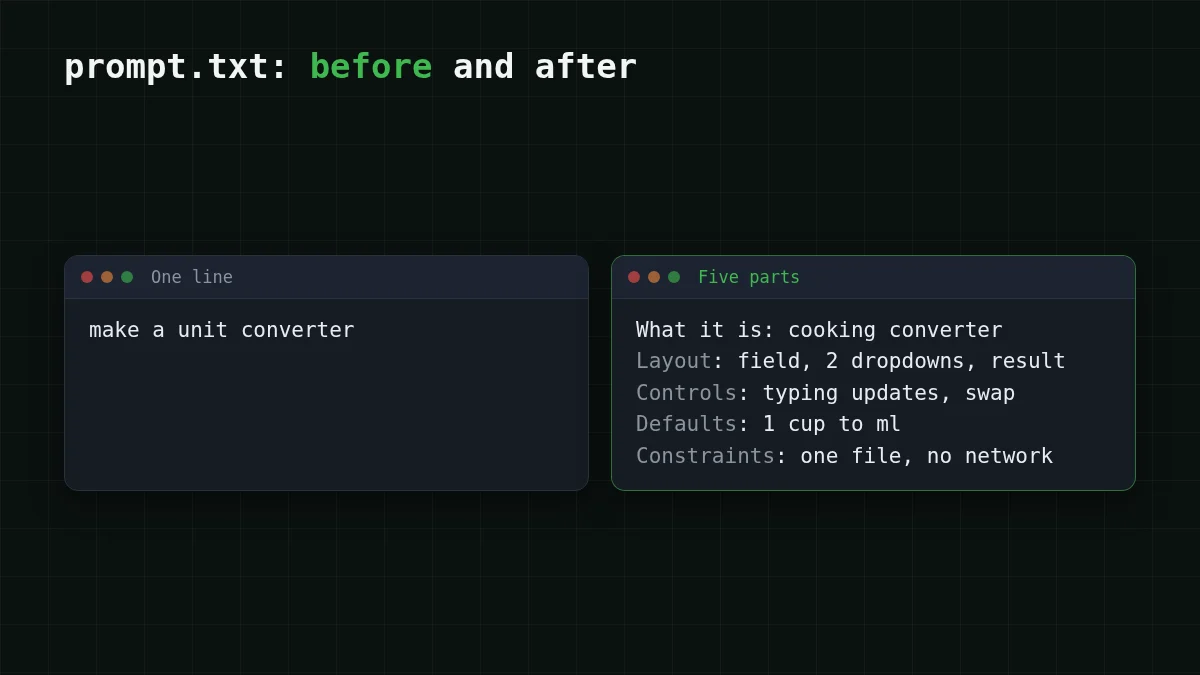
Ecco il template, in cinque parti:
What it is: <one sentence: the tool and who uses it>
Layout: <what is on the screen, top to bottom>
Controls: <every input and button, and what each one does>
Defaults: <what the page shows before the user touches anything>
Constraints: <single HTML file, no external requests, no libraries, size of the page>
E una versione compilata. Diciamo che continui a convertire misure di cucina e sei stanco di cercare un convertitore:
What it is: a unit converter for cooking, for someone standing in a kitchen with a phone.
Layout: a title, one number field, two dropdowns (from, to), a large result line under them.
Controls: the dropdowns hold cup, tablespoon, teaspoon, ml, oz, g (flour) and g (sugar). Typing a number updates the result immediately. A swap button exchanges the two dropdowns.
Defaults: 1 cup to ml, result already shown.
Constraints: one HTML file with inline CSS and JavaScript, no external libraries, fonts or network requests, works on a narrow phone screen, dark text on a light background.
Salvalo come prompt.txt accanto allo script. La riga "Constraints" porta il peso maggiore: senza "no external requests" al modello piace tirare dentro una libreria da CDN, e poi la pagina si rompe offline.
Lo script: richiesta, controllo, salvataggio#
L'API di CheapTokens è compatibile con OpenAI Chat Completions su https:/, quindi il pacchetto openai funziona con due modifiche: la base URL e la chiave. Per un'intera pagina usiamo deepseek-: consente fino a 32.768 token di output per risposta e ha una finestra di contesto di 380K. I dettagli completi dell'API sono nella documentazione di CheapTokens.
Installa il pacchetto, metti la tua chiave in una variabile d'ambiente e imposta i due prezzi dalla tabella dei prezzi (lo script li usa per stampare il costo):
pip install openai
export CHEAPTOKENS_API_KEY="your-key"
export PRICE_IN_PER_M="<input price per 1M from the table>"
export PRICE_OUT_PER_M="<output price per 1M from the table>"
Poi make_tool.py:
import os
import re
import sys

from openai import OpenAI

MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
PRICE_IN = float(os.environ['PRICE_IN_PER_M'])    # USD per 1M input tokens (from the table)
PRICE_OUT = float(os.environ['PRICE_OUT_PER_M'])  # USD per 1M output tokens (from the table)
FENCE = '`' * 3

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

prompt = open('prompt.txt', encoding='utf-8').read()

resp = client.chat.completions.create(
    model=MODEL,
    max_tokens=16000,
    messages=[
        {'role': 'system', 'content': 'You write one self-contained HTML file. Reply with the file only, no commentary.'},
        {'role': 'user', 'content': prompt},
    ],
)

choice = resp.choices[0]
if choice.finish_reason == 'length':
    sys.exit('Cut off at max_tokens: the page is unfinished. Raise max_tokens or shrink the request.')

text = choice.message.content or ''
m = re.search(FENCE + r'(?:html)?\s*(.*?)' + FENCE, text, re.DOTALL)
html = (m.group(1) if m else text).strip()
if '</html>' not in html.lower():
    sys.exit('The reply has no closing </html>; not saving it.')

with open('tool.html', 'w', encoding='utf-8') as f:
    f.write(html)

u = resp.usage
cost = (u.prompt_tokens * PRICE_IN + u.completion_tokens * PRICE_OUT) / 1_000_000
print(f'saved tool.html, {u.prompt_tokens} in / {u.completion_tokens} out, about ${cost:.6f}')
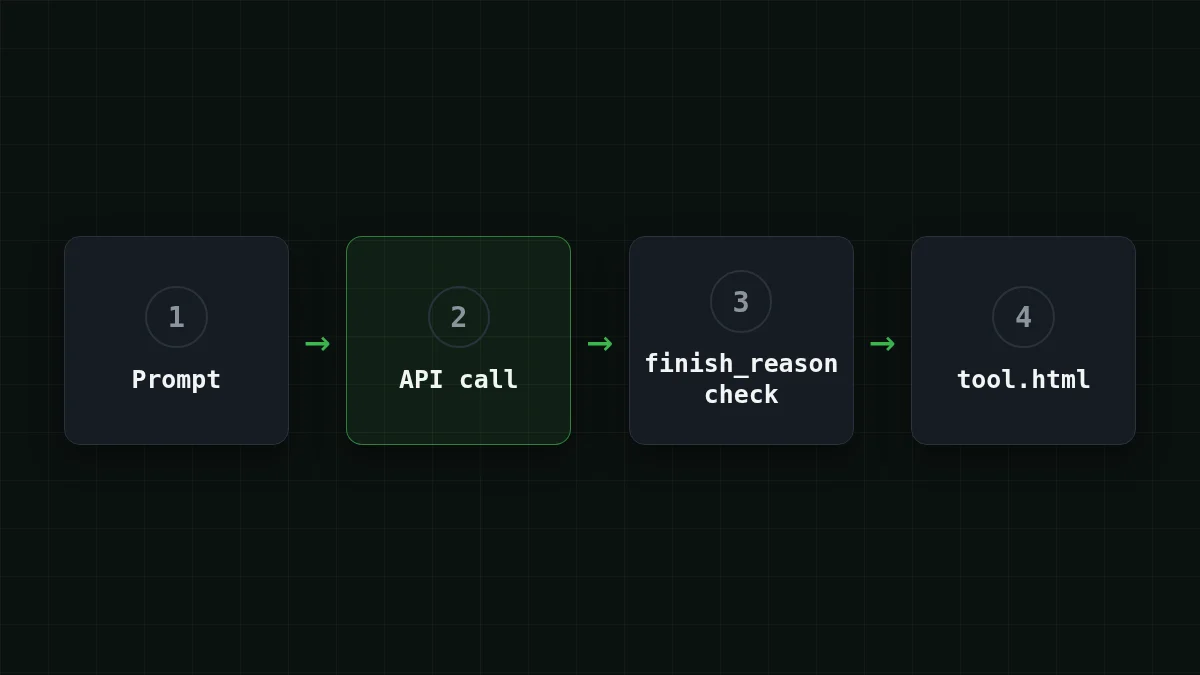
L'ordine dei passaggi conta, ed è facile sbagliarlo:
Metti in ordine
Metti i passaggi dello script nell'ordine in cui li esegue
Trascina gli elementi o usa le frecce
- Invia il prompt con un max_tokens generoso
- Controlla finish_reason prima di toccare il testo
- Estrai l'HTML dal code fence, se c'è
- Verifica che ci sia il </html> di chiusura
- Salva tool.html e stampa l'usage
Perché max_tokens decide se la pagina funziona#
Una pagina interattiva completa è una risposta lunga. HTML, CSS e JavaScript si sommano in fretta, e il modello li scrive in quest'ordine: se la risposta viene tagliata, perdi prima la fine dello script, che è esattamente la parte che fa funzionare i pulsanti. Il browser può comunque aprire la pagina. Semplicemente non fa nulla.
Ecco perché lo script controlla finish_reason prima di guardare il testo. stop significa che il modello ha finito da solo. length significa che ha sbattuto contro il tetto di max_tokens a metà file. La versione generale di questo problema è trattata in Risposta AI troncata? Correggi finish_reason length; qui la regola è breve: non salvare mai una pagina la cui finish_reason è length.
Se lo vedi davvero:
- alza
max_tokens(DeepSeek-V4-Flash consente fino a 32.768 per risposta); - oppure chiedi di meno: meno controlli, una sola schermata, niente animazioni;
- su GLM-5.3-Flash (
zai-) il tetto è 8.192 token di output, quindi quel modello va bene per strumenti piccoli, come il convertitore qui sopra.org/ GLM- 5. 3- Flash
Il secondo controllo, </html> nel testo, intercetta il fallimento più silenzioso, in cui il modello chiude la risposta con cortesia senza finire il file. Impostare max_tokens non fa nemmeno scrivere di più al modello: è solo un tetto, e paghi i token effettivamente prodotti (ne parliamo di più in Ridurre i token di output).
Verifica rapida
Lo script ha stampato finish_reason = length. Cosa fai?
Mostra risposta
Risposta: Non lo salvi; alzi max_tokens o riduci la richiesta
length significa che la risposta è stata tagliata al tetto, quindi manca la fine dello script. Un tetto più basso fa arrivare il taglio prima.
Aprila e guarda la pagina#
Apri tool.html facendo doppio clic, oppure dal terminale: open tool.html su macOS, xdg- su Linux, start tool.html su Windows.
Questo è codice che un modello ha scritto per te, quindi dedica un minuto prima di fidarti. Apri gli strumenti per sviluppatori del browser (F12), guarda la scheda Network e ricarica: con il vincolo "no external requests" dovrebbe restare vuota. Poi clicca una volta ogni controllo della parte "Controls" del tuo prompt.
Se qualcosa non va, non rigenerare da zero. Aggiungi al prompt una frase sulla cosa specifica ("il pulsante di scambio deve scambiare anche i due valori") e rilancia. La pagina di DeepSeek stessa nota che alcune delle sue demo sono state rifinite in più round di conversazione, quindi un secondo passaggio è normale.
Provalo tu stessoProva: cosa ti aspetti di vedere nella scheda Network per il convertitore?Mostra risposta
Niente: la pagina è un singolo file con CSS e JavaScript inline, quindi dopo il primo caricamento non ci sono altre richieste. Se vedi una richiesta a una CDN, il modello ha ignorato il vincolo; aggiungilo al prompt in maiuscolo e rilancia.
Quanto costa una generazione#
Diciamo che il prompt sia circa 600 token di input e la pagina finita circa 6.000 token di output (un'ipotesi per uno strumento di medie dimensioni; la tua riga usage mostrerà i numeri reali). Un'esecuzione su DeepSeek-V4-Flash è $0.00061, e su GLM-5.3-Flash $0.00025. Entrambi sono numeri live dal listino prezzi attuale, e in totale, contando insieme input e output, entrambi costano meno di OpenRouter.
| Modello | Input $/1M | Output $/1M | Costo | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00025 | $0.00052 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00061 | $0.00088 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00093 | $0.0112 |
600 token di input e 6000 token di output in totale. I prezzi per 1M di token sono attuali e cambiano insieme alle nostre tariffe; la colonna OpenRouter mostra i prezzi di riferimento per lo stesso carico di lavoro.
In pratica non otterrai lo strumento giusto al primo tentativo, quindi ragiona in iterazioni: dieci ritocchi al prompt sono dieci volte quella riga, comunque una cifra piccola per uno strumento che altrimenti scriveresti a mano. Quasi tutto è il lato output, la pagina stessa, ed è per questo che ridurre la richiesta (meno controlli) accorcia la risposta e il conto.
Se non funziona#
Scorri la tabella verso destra →
| Cosa vedi | Causa probabile | Cosa fare |
|---|---|---|
401 o 404 dall'API |
chiave, base URL o model id sbagliati | controlla i tre, vedi Errore API 401 o 404 |
Cut off at max_ |
pagina più lunga del tetto | alza max_tokens o chiedi di meno |
The reply has no closing </ |
il modello si è fermato prima o ha aggiunto testo | rilancia; aggiungi "end with </html>" al prompt |
| La pagina si apre ma i pulsanti non fanno nulla | errore JavaScript | apri la console (F12), incolla l'errore rosso in un prompt di follow-up |
Se vuoi che la risposta del modello venga interpretata come dati invece che come pagina, il trucco di estrazione è lo stesso di json.JSONDecodeError su una risposta LLM. Nuovo all'API? Inizia da la tua prima richiesta API.


