API & SDKPanduan
Hasilkan alat HTML dari satu prompt dengan API (Python)
Skrip Python yang mengubah satu prompt menjadi tool.html yang berfungsi, menangkap jawaban terpotong lewat finish_reason, dan mencetak token serta biaya.
Di halaman ini
Anda bisa mendapatkan alat satu file yang berfungsi dari satu panggilan API: kirim prompt yang terstruktur dengan baik, pastikan max_tokens cukup besar untuk satu halaman penuh, periksa bahwa finish_reason adalah stop, dan simpan balasannya sebagai tool.html. Di bawah ini adalah skrip yang melakukan hal itu, dan templat prompt yang bisa Anda ubah untuk alat Anda sendiri.
Idenya sederhana, dan DeepSeek baru saja menunjukkannya. Ia menerbitkan kumpulan tujuh prompt demo untuk Creator Mode di DeepSeek Harness (halaman, diperiksa 3 November 2026): galeri landmark 3D, meja kerja poster, meja kerja pengeditan video, pembaca makalah, papan statistik percakapan dan beberapa lainnya. Creator Mode berada di dalam aplikasi Harness. Jika Anda ingin alur "prompt masuk, alat keluar" yang sama di skrip Anda sendiri dan dengan kunci Anda sendiri, chat completion biasa sudah cukup untuk kasus satu file. Jika Anda memang menggunakan Harness itu sendiri, menghubungkannya ke CheapTokens adalah panduan singkat terpisah.
Apa yang dibutuhkan prompt "buatkan saya alat"#
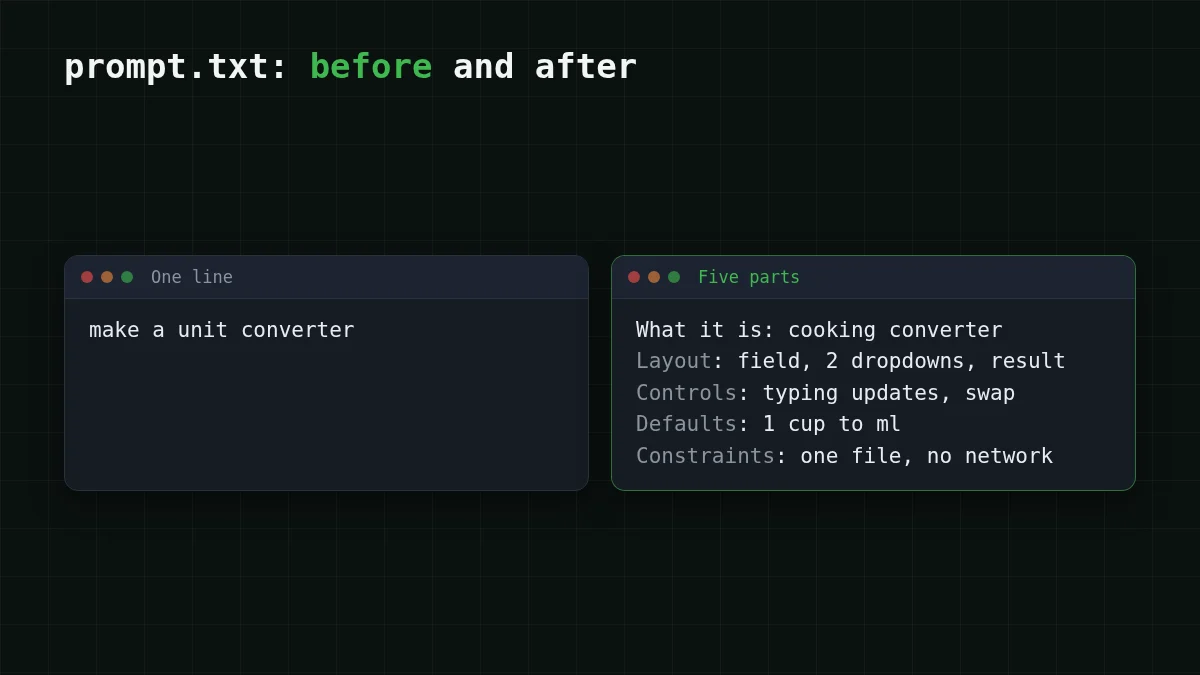
Baca beberapa prompt demo itu dan sebuah pola muncul. Masing-masing menyebutkan apa alat itu, apa yang ada di layar, apa yang dilakukan kontrol, apa keadaan awalnya, dan apa yang tidak boleh dilakukannya. Lewatkan salah satunya dan model akan mengisi celah itu dengan tebakannya sendiri, yang biasanya bukan tebakan Anda.
Berikut templatnya, lima bagian:
What it is: <one sentence: the tool and who uses it>
Layout: <what is on the screen, top to bottom>
Controls: <every input and button, and what each one does>
Defaults: <what the page shows before the user touches anything>
Constraints: <single HTML file, no external requests, no libraries, size of the page>
Dan versi yang sudah diisi. Katakanlah Anda sering mengonversi takaran masak dan lelah mencari konverter:
What it is: a unit converter for cooking, for someone standing in a kitchen with a phone.
Layout: a title, one number field, two dropdowns (from, to), a large result line under them.
Controls: the dropdowns hold cup, tablespoon, teaspoon, ml, oz, g (flour) and g (sugar). Typing a number updates the result immediately. A swap button exchanges the two dropdowns.
Defaults: 1 cup to ml, result already shown.
Constraints: one HTML file with inline CSS and JavaScript, no external libraries, fonts or network requests, works on a narrow phone screen, dark text on a light background.
Simpan itu sebagai prompt.txt di samping skrip. Baris "Constraints" memikul sebagian besar beban: tanpa "no external requests" model cenderung menarik pustaka CDN, dan halaman kemudian rusak saat offline.
Skrip: minta, periksa, simpan#
API CheapTokens kompatibel dengan OpenAI Chat Completions di https:/, jadi paket openai berfungsi dengan dua perubahan: base URL dan kunci. Untuk satu halaman penuh kita menggunakan deepseek-: ia mengizinkan hingga 32.768 token keluaran per jawaban dan memiliki jendela konteks 380K. Detail API lengkap ada di dokumentasi CheapTokens.
Pasang paketnya, taruh kunci Anda di variabel lingkungan, dan atur kedua harga dari tabel harga (skrip menggunakannya untuk mencetak biaya):
pip install openai
export CHEAPTOKENS_API_KEY="your-key"
export PRICE_IN_PER_M="<input price per 1M from the table>"
export PRICE_OUT_PER_M="<output price per 1M from the table>"
Lalu make_tool.py:
import os
import re
import sys

from openai import OpenAI

MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
PRICE_IN = float(os.environ['PRICE_IN_PER_M'])    # USD per 1M input tokens (from the table)
PRICE_OUT = float(os.environ['PRICE_OUT_PER_M'])  # USD per 1M output tokens (from the table)
FENCE = '`' * 3

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

prompt = open('prompt.txt', encoding='utf-8').read()

resp = client.chat.completions.create(
    model=MODEL,
    max_tokens=16000,
    messages=[
        {'role': 'system', 'content': 'You write one self-contained HTML file. Reply with the file only, no commentary.'},
        {'role': 'user', 'content': prompt},
    ],
)

choice = resp.choices[0]
if choice.finish_reason == 'length':
    sys.exit('Cut off at max_tokens: the page is unfinished. Raise max_tokens or shrink the request.')

text = choice.message.content or ''
m = re.search(FENCE + r'(?:html)?\s*(.*?)' + FENCE, text, re.DOTALL)
html = (m.group(1) if m else text).strip()
if '</html>' not in html.lower():
    sys.exit('The reply has no closing </html>; not saving it.')

with open('tool.html', 'w', encoding='utf-8') as f:
    f.write(html)

u = resp.usage
cost = (u.prompt_tokens * PRICE_IN + u.completion_tokens * PRICE_OUT) / 1_000_000
print(f'saved tool.html, {u.prompt_tokens} in / {u.completion_tokens} out, about ${cost:.6f}')
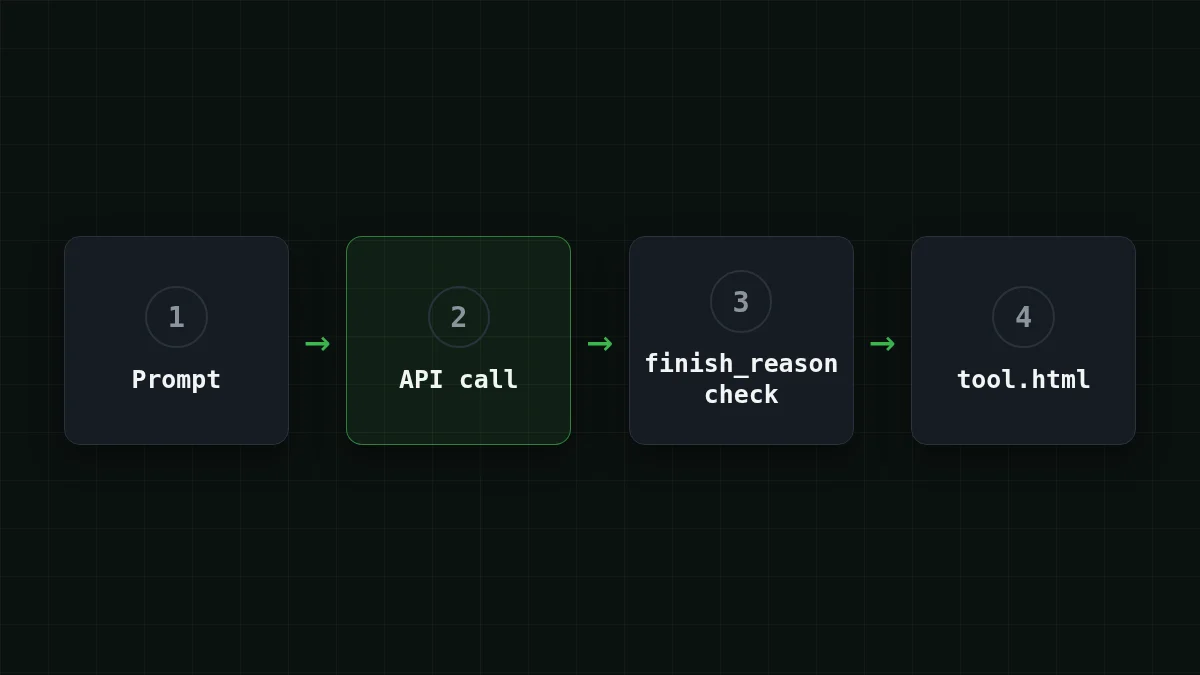
Urutan langkahnya penting, dan mudah salah:
Urutkan
Susun langkah-langkah skrip sesuai urutan ia menjalankannya
Seret item atau gunakan panah
- Kirim prompt dengan max_tokens yang lapang
- Periksa finish_reason sebelum menyentuh teks
- Ambil HTML dari code fence, jika ada
- Pastikan </html> penutup ada
- Simpan tool.html dan cetak usage
Mengapa max_tokens menentukan apakah halaman berfungsi#
Halaman interaktif penuh adalah jawaban yang panjang. HTML, CSS dan JavaScript bertambah dengan cepat, dan model menulisnya dalam urutan itu: jika jawaban terpotong, Anda kehilangan bagian akhir skrip lebih dulu, yang justru bagian yang membuat tombol berfungsi. Browser mungkin masih membuka halaman. Hanya saja tidak melakukan apa-apa.
Itulah sebabnya skrip memeriksa finish_reason sebelum melihat teks. stop berarti model selesai dengan sendirinya. length berarti ia mencapai batas max_tokens di tengah file. Versi umum dari masalah ini dibahas di Jawaban AI terpotong? Perbaiki finish_reason length; di sini aturannya singkat: jangan pernah menyimpan halaman yang finish_reason-nya adalah length.
Jika Anda memang melihatnya:
- naikkan
max_tokens(DeepSeek-V4-Flash mengizinkan hingga 32.768 per jawaban); - atau minta lebih sedikit: kontrol lebih sedikit, satu layar, tanpa animasi;
- pada GLM-5.3-Flash (
zai-) batasnya adalah 8.192 token keluaran, jadi model itu cocok untuk alat kecil, seperti konverter di atas.org/ GLM- 5. 3- Flash
Pemeriksaan kedua, </html> dalam teks, menangkap kegagalan yang lebih senyap di mana model mengakhiri balasan dengan sopan tanpa menyelesaikan file. Mengatur max_tokens juga tidak membuat model menulis lebih banyak: itu hanya batas atas, dan Anda membayar untuk token yang benar-benar dihasilkan (lebih lanjut di Pangkas token keluaran).
Cek cepat
Skrip mencetak finish_reason = length. Apa yang Anda lakukan?
Tampilkan jawaban
Jawaban: Jangan simpan; naikkan max_tokens atau perkecil permintaan
length berarti jawaban terpotong di batas atas, jadi bagian akhir skrip hilang. Batas atas yang lebih rendah membuat potongan datang lebih cepat.
Buka dan lihat halamannya#
Buka tool.html dengan mengklik gandanya, atau dari terminal: open tool.html di macOS, xdg- di Linux, start tool.html di Windows.
Ini adalah kode yang ditulis model untuk Anda, jadi luangkan waktu sebentar sebelum mempercayainya. Buka developer tools browser (F12), lihat tab Network dan muat ulang: dengan batasan "no external requests" tab itu seharusnya tetap kosong. Lalu klik setiap kontrol dari bagian "Controls" pada prompt Anda satu kali.
Jika ada yang tidak beres, jangan regenerasi dari awal. Tambahkan satu kalimat ke prompt tentang hal spesifik itu ("tombol swap juga harus menukar kedua nilai") dan jalankan lagi. Halaman DeepSeek sendiri mencatat bahwa beberapa demonya disempurnakan melalui beberapa putaran percakapan, jadi putaran kedua itu normal.
Coba sendiriCoba: apa yang Anda harapkan terlihat di tab Network untuk konverter?Tampilkan jawaban
Tidak ada: halaman itu adalah satu file dengan CSS dan JavaScript inline, jadi setelah pemuatan pertama tidak ada permintaan lebih lanjut. Jika Anda melihat permintaan ke CDN, model mengabaikan batasannya; tambahkan ke prompt dengan huruf kapital dan jalankan lagi.
Berapa biaya satu generasi#
Katakanlah prompt sekitar 600 token masukan dan halaman jadi sekitar 6.000 token keluaran (asumsi untuk alat berukuran sedang; baris usage Anda sendiri akan menunjukkan angka sebenarnya). Satu kali jalan pada DeepSeek-V4-Flash adalah $0.00061, dan pada GLM-5.3-Flash $0.00025. Keduanya angka langsung dari daftar harga saat ini, dan secara total, dengan masukan dan keluaran dihitung bersama, keduanya lebih murah daripada OpenRouter.
| Model | Input $/1Jt | Output $/1Jt | Biaya | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00025 | $0.00052 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00061 | $0.00088 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00093 | $0.0112 |
Total 600 token input dan 6.000 token output. Harga per 1 juta token adalah harga saat ini dan berubah seiring tarif kami; kolom OpenRouter menunjukkan harga referensi untuk beban kerja yang sama.
Dalam praktiknya Anda tidak akan mendapatkan alat itu benar pada percobaan pertama, jadi berpikirlah dalam iterasi: sepuluh penyesuaian prompt adalah sepuluh kali baris itu, tetap jumlah kecil untuk alat yang jika tidak akan Anda tulis sendiri. Hampir semuanya ada di sisi keluaran, halaman itu sendiri, itulah sebabnya memperkecil permintaan (kontrol lebih sedikit) memperpendek jawaban dan tagihan.
Jika tidak berhasil#
Gulir tabel ke kanan →
| Yang Anda lihat | Kemungkinan penyebab | Yang harus dilakukan |
|---|---|---|
401 atau 404 dari API |
kunci, base URL atau id model salah | periksa ketiganya, lihat Kesalahan API 401 atau 404 |
Cut off at max_ |
halaman lebih panjang dari batas atas | naikkan max_tokens atau minta lebih sedikit |
The reply has no closing </ |
model berhenti lebih awal atau menambahkan teks | jalankan lagi; tambahkan "end with </html>" ke prompt |
| Halaman terbuka tetapi tombol tidak berfungsi | kesalahan JavaScript | buka konsol (F12), tempel kesalahan merah ke prompt lanjutan |
Jika Anda ingin balasan model diurai sebagai data alih-alih halaman, trik ekstraksinya sama seperti di json.JSONDecodeError pada balasan LLM. Baru mengenal API? Mulai dengan permintaan API pertama Anda.


