Optimasi biayaPanduan
Potong token output: panjang jawaban, max_tokens, urutan stop
Perpendek jawaban AI secara desain: minta format terbatas, pertahankan max_tokens sebagai batas, gunakan urutan stop, lalu lihat biaya 1.000 permintaan.
Di halaman ini
Bot Anda menjawab dengan 400 token padahal 100 sudah cukup, dan Anda membayar untuk setiap tokennya. Perbaikannya sebagian besar ada di prompt: minta format yang terbatas, pertahankan max_tokens sebagai batas pengaman alih-alih pengatur panjang, dan periksa usage. untuk melihat apa yang sebenarnya dikembalikan.
Ini penting karena output adalah sisi yang lebih mahal pada setiap model yang kami tawarkan: lihat harga langsung di halaman harga. Pertanyaan sama, jawaban lebih pendek, tagihan lebih kecil.
Mulai dari prompt, bukan dari batas#
Misalkan Anda menjalankan bot dukungan dengan 2.000 tiket sehari. Setiap tiket membutuhkan kategori dan satu kalimat alasan. Model, jika dibiarkan, menulis paragraf ramah, daftar peringatan, dan tawaran bantuan lebih lanjut. Di situlah 400 token pergi.
Bandingkan
Tiket sama, dua prompt
Terbuka
System: Anda adalah asisten dukungan yang membantu. User: Beri tahu saya jenis tiket ini: "Kartu saya ditagih dua kali untuk pesanan 1182." Jawaban: paragraf dengan sapaan, penjelasan, dan tawaran bantuan (sekitar 400 token).
Terbatas
System: Balas dengan tepat dua baris. Baris 1: kategori, salah satu dari billing, bug, other. Baris 2: alasan dalam maksimal 15 kata. Tanpa sapaan.
User: tiket yang sama.
Jawaban: billing dan satu alasan singkat (sekitar 100 token atau kurang).
Triknya adalah Anda mendeskripsikan bentuk jawaban: jumlah baris, daftar label tertutup, batas kata. "Singkat saja" bekerja lebih buruk daripada "dua baris, 15 kata", karena model memiliki sesuatu yang konkret untuk dihitung. Jika Anda hanya membutuhkan label, minta labelnya saja. Pengklasifikasi yang harus mengembalikan billing tidak boleh diizinkan menjelaskan dirinya sendiri.
Hal yang sama berlaku untuk ekstraksi JSON. Ketika model membungkus JSON Anda dalam prosa, prosa itu adalah output yang Anda bayar lalu buang. Letakkan "Kembalikan hanya objek JSON, tanpa teks sebelum atau sesudahnya" di pesan sistem. Untuk mengurai apa yang dikembalikan, lihat cara mengekstrak JSON dari balasan LLM.
max_tokens adalah sabuk pengaman#
Menggoda untuk mengatur max_tokens: 100 dan menganggapnya selesai. Jangan berharap jawaban pendek darinya. Referensi API DeepSeek (diperiksa 2 November 2026) mendeskripsikan max_tokens sebagai jumlah maksimum token yang dapat dihasilkan dalam completion, dengan input ditambah output dibatasi oleh panjang konteks model. Ini menghentikan generasi. Ini tidak membuat model merencanakan jawaban yang lebih pendek.
Jadi model yang ingin menulis 400 token dan mendapat 100 memberi Anda kalimat yang berakhir di tengah, finish_reason diatur ke length, dan tagihan untuk semua 100 token. Anda membayar untuk jawaban yang tidak dapat digunakan. Mengapa itu terjadi dan cara memperbaikinya dibahas di mengapa jawaban AI berhenti di tengah kalimat dan perbaikan finish_reason "length". Saya tidak akan mengulanginya di sini.
Pembagian yang berfungsi sederhana:
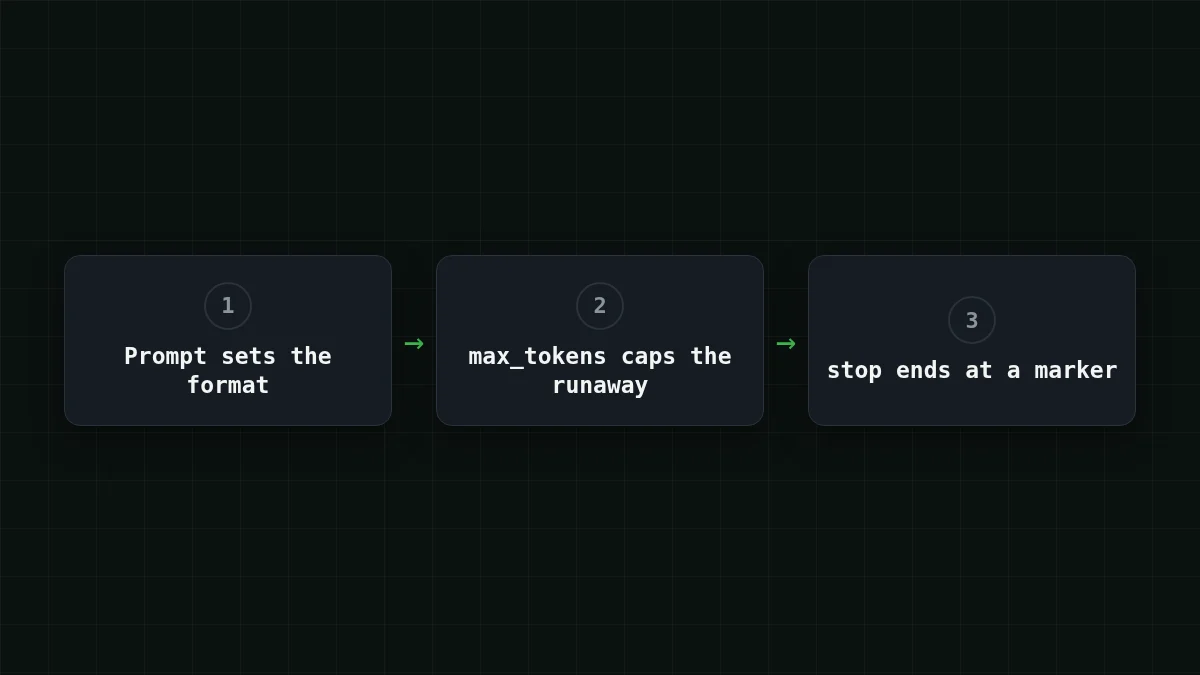
- prompt menentukan seberapa panjang jawaban yang baik;
max_tokensberada sedikit di atas jawaban baik terpanjang, sehingga balasan yang lepas kendali dipotong alih-alih tumbuh hingga batas output model (hingga 32.768 token pada DeepSeek-V4-Flash).
Untuk jawaban tiket dua baris, 150 sudah cukup. Untuk label satu kata, 20.
Urutan stop mengakhiri jawaban pada penanda#
Dalam referensi DeepSeek, stop menerima hingga 16 urutan, dan generasi berhenti ketika model akan menghasilkan salah satunya. Ketika itu terjadi, finish_reason adalah stop, sama seperti akhir alami. Ini berguna ketika format Anda memiliki penanda akhir. Minta jawabannya, lalu baris dengan END, dan letakkan END di stop. Uji sekali pada pengaturan Anda sendiri: lakukan satu panggilan dan periksa bahwa finish_reason adalah stop dan teks berakhir sebelum penanda.
Satu aturan: teks stop harus sesuatu yang tidak dapat muncul di dalam jawaban yang baik. Stop pada \n\n memotong jawaban dua paragraf setelah paragraf pertama.
Permintaan yang dapat Anda jalankan dan ukur#
Berikut adalah panggilan tiket terbatas. ID model adalah gateway_id lengkap dari dokumentasi CheapTokens, dan URL dasar adalah https:/. Dokumentasi menunjukkan cara membuat kunci; letakkan di variabel lingkungan.
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "max_tokens": 150,
    "messages": [
      {"role": "system", "content": "Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting."},
      {"role": "user", "content": "My card was charged twice for order 1182."}
    ]
  }'
Dalam respons, dua hal penting: choices[0]. dan objek usage dengan prompt_tokens dan completion_. Dalam Python dengan paket openai tampilannya seperti ini:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

r = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    max_tokens=150,
    messages=[
        {"role": "system", "content": "Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting."},
        {"role": "user", "content": "My card was charged twice for order 1182."},
    ],
)

print(r.choices[0].message.content)
print(r.choices[0].finish_reason, r.usage.completion_tokens)
Jalankan pada sepuluh tiket nyata sebelum Anda mempercayai formatnya. Jika completion_ tetap kecil dan finish_reason selalu stop, prompt melakukan tugasnya. Jika Anda melihat length, batas Anda di bawah kebutuhan jawaban yang baik: naikkan atau perketat prompt, jangan keduanya secara buta.
Cocokkan pasangan
Apa yang dikatakan bidang-bidang itu
Ketuk item di kiri, lalu pasangannya
- lengthBatas max_tokens tercapai
- stopTitik stop alami atau urutan stop
- usage.completion_tokensToken dalam jawaban, sisi output tagihan Anda
Jika finish_reason bukan stop, lihat batasnya terlebih dahulu.
Apa yang dihemat pada 1.000 permintaan#
Sekarang tagihannya. Asumsikan tiket plus instruksi adalah 300 token input, jawaban terbuka adalah 400 token output dan yang terbatas adalah 100. Ini adalah asumsi untuk contoh; ganti dengan angka dari usage Anda sendiri. Selama 1.000 permintaan, itu adalah 300 × 1.000 = 300.000 token input dalam kedua kasus, dan 400 × 1.000 = 400.000 token output versus 100 × 1.000 = 100.000.
Jawaban terbuka, 1.000 permintaan:
| Model | Input $/1Jt | Output $/1Jt | Per permintaan | 1.000 permintaan | OpenRouter, 1.000 permintaan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000022 | $0.022 | $0.0433 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000045 | $0.0445 | $0.077 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000075 | $0.075 | $0.90 |
300 token input dan 400 token output per permintaan. Harga per 1 juta token adalah harga saat ini dan berubah seiring tarif kami; kolom OpenRouter menunjukkan harga referensi untuk beban kerja yang sama.
Jawaban terbatas, 1.000 permintaan:
| Model | Input $/1Jt | Output $/1Jt | Per permintaan | 1.000 permintaan | OpenRouter, 1.000 permintaan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00001 | $0.01 | $0.0184 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000015 | $0.0145 | $0.035 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00003 | $0.03 | $0.36 |
300 token input dan 100 token output per permintaan. Harga per 1 juta token adalah harga saat ini dan berubah seiring tarif kami; kolom OpenRouter menunjukkan harga referensi untuk beban kerja yang sama.
Sisi input tidak bergerak, dan itulah intinya: hanya bagian yang Anda perpendek yang menjadi lebih murah, dan itu adalah bagian dengan harga lebih tinggi. Per model, 1.000 tiket yang sama biayanya $0.0445 terbuka dan $0.0145 terbatas pada DeepSeek-V4-Flash. Secara total, dengan input dan output dihitung bersama, ketiga model dalam tabel menjadi lebih murah daripada harga referensi OpenRouter. Untuk jawaban pendek, pilih model dari tabel di atas: bandingkan baris untuk input dan output Anda sendiri. GLM-5.3-Flash ($0.04 per 1 juta token output) cocok di mana jawaban tetap lebih panjang, hingga 8.192 token; halaman DeepSeek memiliki sisanya.
Urutan yang akan saya terapkan#
Urutkan
Letakkan langkah-langkah dalam urutan yang masuk akal
Seret item atau gunakan panah
- Tulis format jawaban ke dalam prompt
- Atur max_tokens sedikit di atas jawaban baik terpanjang
- Jika API menerima stop dan format memiliki penanda akhir, tambahkan urutan stop
- Catat completion_tokens dan finish_reason untuk setiap panggilan
- Bandingkan biaya batch 1.000 permintaan sebelum dan sesudah
Langkah 4 adalah yang dilewatkan orang. Tanpa itu Anda tidak tahu apakah perubahan prompt berhasil atau apakah beberapa jawaban panjang menyeret rata-rata naik. Jika Anda sudah melacak pengeluaran, pendekatan penghitungan token dalam Python dan token input vs output adalah tempat yang baik untuk melanjutkan.


