AI untuk pemulaPanduan
Batasi biaya batch LLM di Python: ledger dan anggaran keras
Catat token dan biaya setiap panggilan API ke file JSONL, hentikan batch pada anggaran, dan perkirakan tagihan sebelum menjalankannya. Termasuk kode Python.
Di halaman ini
Skrip Anda mengulang 200 prompt, Anda menutup laptop, dan paginya Anda tahu berapa biaya malam itu. Dua kebiasaan kecil memperbaikinya. Setelah setiap panggilan API, tambahkan satu baris berisi token dan biaya ke file ledger. Sebelum setiap panggilan, bandingkan total berjalan dengan anggaran dan berhenti jika sudah tercapai. Itu kurang dari 50 baris Python, dan uji coba 5 prompt memberi tahu tagihan sebelum proses sebenarnya dimulai.
Apa yang dilakukan Clocktower yang bisa Anda tiru#
Dwarkesh Patel, host Podcast Dwarkesh, menjalankan 11 model saling berhadapan di Blood on the Clocktower, 386 permainan menurut README, dan menerbitkan kode, log, dan peringkat (github.com/dwarkeshsp/clocktower, diperiksa 8 November 2026). Dua detail dari repo itu layak dicuri. Setiap direktori permainan menyimpan log per panggilan dengan token dan biaya, dan pengeluaran masuk ke games/. Flag --budget membatasi total pengeluaran; defaultnya $1.000. Situs benchmark menambahkan penjaga ketiga: setiap model mendapat batas 8.000 token yang sama per giliran (clocktowerbench.com).
Jadi: batas atas setiap panggilan, log setiap panggilan, batas total. Turnamen membutuhkan ketiganya, begitu juga proses semalam Anda, hanya lebih kecil.
Anggap ledger sebagai gulungan struk di mesin kasir toko. Setiap penjualan mencetak satu baris; manajer dapat menjumlahkan gulungan kapan saja dan tahu kapan uang kembalian hari itu habis.
Ledger: satu file, satu baris per panggilan#
Inilah keseluruhannya. Ini menggunakan paket openai yang diarahkan ke CheapTokens (https:/, lihat dokumentasi untuk kunci dan id model).
import json
import os
from pathlib import Path

from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
PRICE_IN, PRICE_OUT = 1.00, 2.00  # USD per 1M tokens: example, substitute current ones


class BudgetExceeded(Exception):
    pass


class Ledger:
    def __init__(self, path, budget_usd):
        self.path = Path(path)
        self.budget = budget_usd
        self.rows = []
        if self.path.exists():
            with self.path.open() as f:
                self.rows = [json.loads(line) for line in f if line.strip()]

    @property
    def spent(self):
        return sum(r['cost_usd'] for r in self.rows)

    def done(self):
        return {r['unit'] for r in self.rows}

    def check(self, unit):
        if self.spent >= self.budget:
            raise BudgetExceeded(
                f'stopped before {unit}: spent {self.spent:.4f} of {self.budget} USD'
            )

    def add(self, unit, usage, finish_reason):
        cost = (usage.prompt_tokens * PRICE_IN
                + usage.completion_tokens * PRICE_OUT) / 1_000_000
        row = {
            'unit': unit,
            'model': MODEL,
            'prompt_tokens': usage.prompt_tokens,
            'completion_tokens': usage.completion_tokens,
            'finish_reason': finish_reason,
            'cost_usd': round(cost, 6),
        }
        self.rows.append(row)
        with self.path.open('a') as f:
            f.write(json.dumps(row) + '\n')


def ask(ledger, unit, prompt, max_tokens=400):
    ledger.check(unit)
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[{'role': 'user', 'content': prompt}],
        max_tokens=max_tokens,
    )
    ledger.add(unit, resp.usage, resp.choices[0].finish_reason)
    return resp.choices[0].message.content
Setiap panggilan melewati empat langkah yang sama:
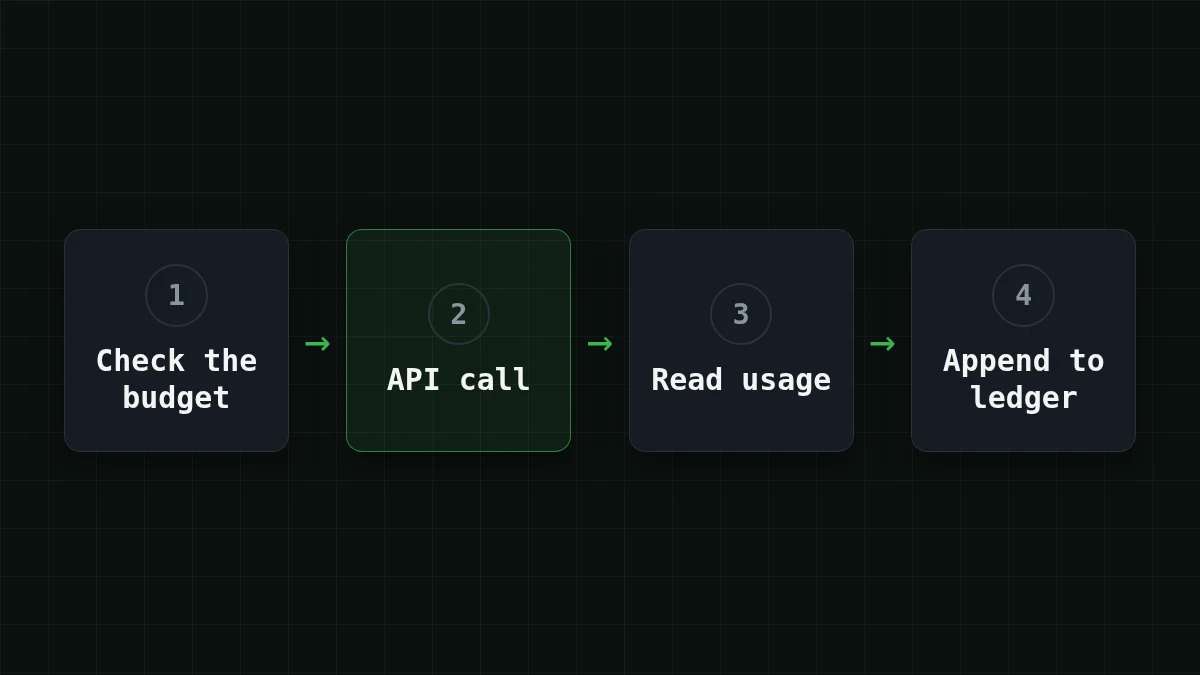
Tiga pilihan di sana disengaja.
- Satu objek JSON per baris (JSONL), dibuka dalam mode append. Jika skrip crash pada panggilan 130, panggilan 1 hingga 129 sudah tersimpan di disk.
- Total berasal dari file, bukan dari variabel. Mulai ulang skrip dan batas tetap berlaku, karena ledger mengingat apa yang dihabiskan proses sebelumnya.
finish_reasondicatat di samping token. Baris yang menyebutlengthberarti jawaban mencapaimax_tokensAnda dan terpotong. Anda akan ingin tahu itu nanti.
Dua konstanta PRICE_ adalah placeholder. Ambil angka terkini dari tabel harga. Untuk DeepSeek-V4-Flash saat Anda membaca ini, itu $0.015 per 1 juta token input dan $0.10 per 1 juta token output. Ubah MODEL menjadi zai- atau MiniMaxAI/ dan kedua konstanta, dan ledger yang sama berfungsi untuk mereka.
Loop batch: lewati yang sudah selesai, berhenti di batas#
Loopnya singkat. Katakanlah prompt Anda ada dalam dict dengan kunci id unit, nama satu unit pekerjaan, seperti doc-001:
prompts = {
    'doc-001': 'Summarize this ticket in one sentence: ...',
    'doc-002': 'Summarize this ticket in one sentence: ...',
    # ... your 200 prompts
}

ledger = Ledger('ledger.jsonl', budget_usd=0.50)
already = ledger.done()

for unit, prompt in prompts.items():
    if unit in already:
        continue
    try:
        answer = ask(ledger, unit, prompt)
    except BudgetExceeded as e:
        print(e)
        break
    Path(f'out-{unit}.txt').write_text(answer)
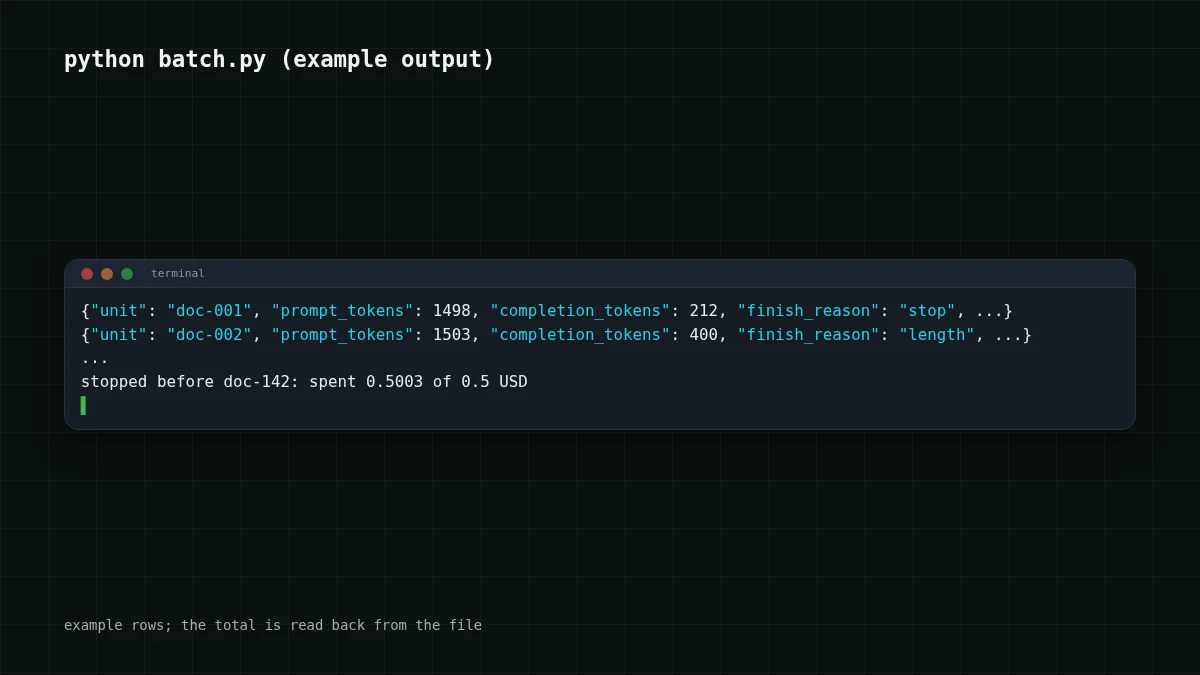
Jalankan, tekan Ctrl+C di tengah jalan, jalankan lagi: unit yang selesai dilewati, jadi ledger sekaligus menjadi file kemajuan Anda. Biarkan anggaran habis dan Anda mendapat satu baris alih-alih kejutan, kira-kira seperti stopped before doc-.
Perhatikan kata sebelum. Pemeriksaan terjadi sebelum setiap panggilan, jadi panggilan terakhir bisa mendorong total sedikit melebihi anggaran. Seberapa jauh melebihi dibatasi: satu panggilan tidak bisa lebih mahal dari prompt terpanjang Anda ditambah max_tokens. Untuk prompt 1.500 token dan max_tokens=400 itu paling banyak $0.000063. Itulah sebabnya setiap panggilan dalam wrapper memiliki max_tokens: ini mengubah risiko tak terbatas menjadi angka yang bisa Anda rencanakan.
Perkirakan tagihan sebelum menekan run#
Sekarang bagian lainnya: mengetahui biaya sebelum peluncuran. Jalankan lima prompt pertama melalui ask() dengan anggaran kecil dan baca ledger. Katakanlah lima baris rata-rata 1.500 token input dan 400 token output. Itu angka Anda untuk seluruh batch.
Untuk 200 prompt itu 200 × 1.500 = 300.000 token input dan 200 × 400 = 80.000 token output. Berikut beban kerja itu pada harga langsung:
| Model | Input $/1Jt | Output $/1Jt | Per permintaan | 200 permintaan | OpenRouter, 200 permintaan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000046 | $0.0092 | $0.0167 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000063 | $0.0125 | $0.0322 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00014 | $0.027 | $0.324 |
1.500 token input dan 400 token output per permintaan. Harga per 1 juta token adalah harga saat ini dan berubah seiring tarif kami; kolom OpenRouter menunjukkan harga referensi untuk beban kerja yang sama.
Tabel ini juga memiliki kolom OpenRouter. Dengan input dan output dihitung bersama, DeepSeek-V4-Flash lebih murah daripada OpenRouter untuk beban ini, dan jumlah itulah yang sebenarnya dibayar batch.
Panjang prompt berbeda-beda, jadi lima sampel adalah tebakan, bukan janji. Gunakan yang terpanjang dari lima ketika Anda ingin sisi atas yang aman, lalu biarkan batas anggaran menangkap sisanya. Ingin membandingkan dua model pada 200 prompt yang sama? Beri setiap model file ledger sendiri, misalnya Ledger(f'ledger-, dan kedua total akan berdampingan setelahnya.
Coba batch Anda sendiri di sini: atur token per permintaan dari sampel Anda dan berapa banyak permintaan yang Anda rencanakan.
Kalkulator biaya
Batch Anda: token dari sampel 5 prompt Anda
Token input per permintaan: 1.500 · Token output per permintaan: 400 · Permintaan per hari: 200
| Model | Per hari | Per bulan |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0092 | $0.276 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0125 | $0.375 |
| MiniMax-M2.7$0.05$0.15 | $0.027 | $0.81 |
Untuk lebih lanjut tentang menghitung token sebelum mengirim, lihat menghitung token dengan tiktoken.
Ketika tagihan lebih besar dari perkiraan: baca ledger#
Skenario pembaca ketiga adalah yang paling tidak menyenangkan. Proses agen berjalan salah dan berulang, dan dasbor hanya menunjukkan total. Ledger menunjukkan di mana masalahnya. Urutkan baris berdasarkan biaya:
rows = [json.loads(line) for line in open('ledger.jsonl')]
for r in sorted(rows, key=lambda r: r['cost_usd'], reverse=True)[:5]:
    print(r['unit'], r['prompt_tokens'], r['completion_tokens'], r['finish_reason'])
Untuk agen, beri nama unit sesuai langkahnya (step-17) sehingga Anda dapat melihat bentuk prosesnya. Beberapa pola muncul berulang kali; cocokkan masing-masing dengan penyebab biasanya:
Cocokkan pasangan
Cocokkan setiap pola ledger dengan penyebab biasanya
Ketuk item di kiri, lalu pasangannya
- prompt_tokens bertambah sedikit di setiap barisLoop mengirim ulang seluruh riwayat di setiap langkah
- completion_tokens sama dengan max_tokens dan finish_reason adalah lengthJawaban terpotong pada batas Anda, dan Anda membayar untuk teks yang terpotong
- Unit yang sama muncul berkali-kali berturut-turutLoop percobaan ulang, atau agen mengulangi satu langkah
- Satu baris jauh lebih mahal dari yang lainSatu input kebesaran, seperti seluruh file ditempel ke prompt
Setiap pola terlihat di ledger jauh sebelum tagihan. Yang pertama dibahas di mengapa agen membaca ulang riwayatnya.
Jika Anda juga ingin pengeluaran per proyek dan peringatan di luar skrip, panduan peringatan anggaran per proyek ini membahas sisi itu. Ledger di sini adalah bagian yang hidup di kode Anda dan bisa mengatakan berhenti.
Sebelum Anda meluncurkan#
Daftar periksa
Sebelum proses nyata pertama
Ukuran konteks dan batas jawaban DeepSeek-V4-Flash, berguna saat Anda memilih max_tokens, ada di halamannya: DeepSeek-V4-Flash di CheapTokens.


