AI入門ガイド
PythonでLLMバッチのコストに上限を設ける: 台帳とハード予算
すべてのAPI呼び出しのトークン数とコストをJSONLファイルに記録し、予算でバッチを停止し、実行前に請求額を見積もる。Pythonコード付き。
このページの内容
スクリプトが200件のプロンプトをループ処理している間にノートPCの蓋を閉じ、翌朝に夜間のコストを知ることになる。小さな習慣を2つ身につければ解決する。API呼び出しのたびにトークン数とコストを1行で台帳ファイルに追記する。呼び出しの前に、累計を予算と比較し、到達していれば停止する。Pythonで50行未満で済み、5プロンプトの試し実行で本番前に請求額がわかる。
Clocktowerの実行から真似できること#
Dwarkesh PodcastのホストであるDwarkesh Patelは、Blood on the Clocktowerで11モデルを対戦させ、READMEによれば386ゲームを実施し、コード・ログ・レーティングを公開した(github.com/dwarkeshsp/clocktower、2026年11月8日確認)。リポジトリから盗む価値のある詳細が2つある。各ゲームのディレクトリには呼び出しごとのトークン数とコストのログが残り、支出はgames/に記録される。--budgetフラグで総支出に上限を設定でき、デフォルトは$1,000だ。ベンチマークサイトはさらに3つ目のガードを加えている。すべてのモデルにターンあたり8,000トークンの上限を課している(clocktowerbench.com)。
つまり、呼び出しごとの上限、呼び出しごとのログ、総額の上限。トーナメントにはこの3つすべてが必要で、夜間実行にも必要だ。ただし規模は小さい。
台帳は店のレジのレシートロールのようなものだ。売上のたびに1行印字され、店長はいつでもロールを合計でき、その日の釣り銭が尽きたことを知る。
台帳: 1ファイル、呼び出しごとに1行#
全体はこれだ。CheapTokensを指すopenaiパッケージを使う(https:/、キーとモデルIDについてはドキュメントを参照)。
import json
import os
from pathlib import Path

from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
PRICE_IN, PRICE_OUT = 1.00, 2.00  # USD per 1M tokens: example, substitute current ones


class BudgetExceeded(Exception):
    pass


class Ledger:
    def __init__(self, path, budget_usd):
        self.path = Path(path)
        self.budget = budget_usd
        self.rows = []
        if self.path.exists():
            with self.path.open() as f:
                self.rows = [json.loads(line) for line in f if line.strip()]

    @property
    def spent(self):
        return sum(r['cost_usd'] for r in self.rows)

    def done(self):
        return {r['unit'] for r in self.rows}

    def check(self, unit):
        if self.spent >= self.budget:
            raise BudgetExceeded(
                f'stopped before {unit}: spent {self.spent:.4f} of {self.budget} USD'
            )

    def add(self, unit, usage, finish_reason):
        cost = (usage.prompt_tokens * PRICE_IN
                + usage.completion_tokens * PRICE_OUT) / 1_000_000
        row = {
            'unit': unit,
            'model': MODEL,
            'prompt_tokens': usage.prompt_tokens,
            'completion_tokens': usage.completion_tokens,
            'finish_reason': finish_reason,
            'cost_usd': round(cost, 6),
        }
        self.rows.append(row)
        with self.path.open('a') as f:
            f.write(json.dumps(row) + '\n')


def ask(ledger, unit, prompt, max_tokens=400):
    ledger.check(unit)
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[{'role': 'user', 'content': prompt}],
        max_tokens=max_tokens,
    )
    ledger.add(unit, resp.usage, resp.choices[0].finish_reason)
    return resp.choices[0].message.content
各呼び出しは同じ4ステップを通る:
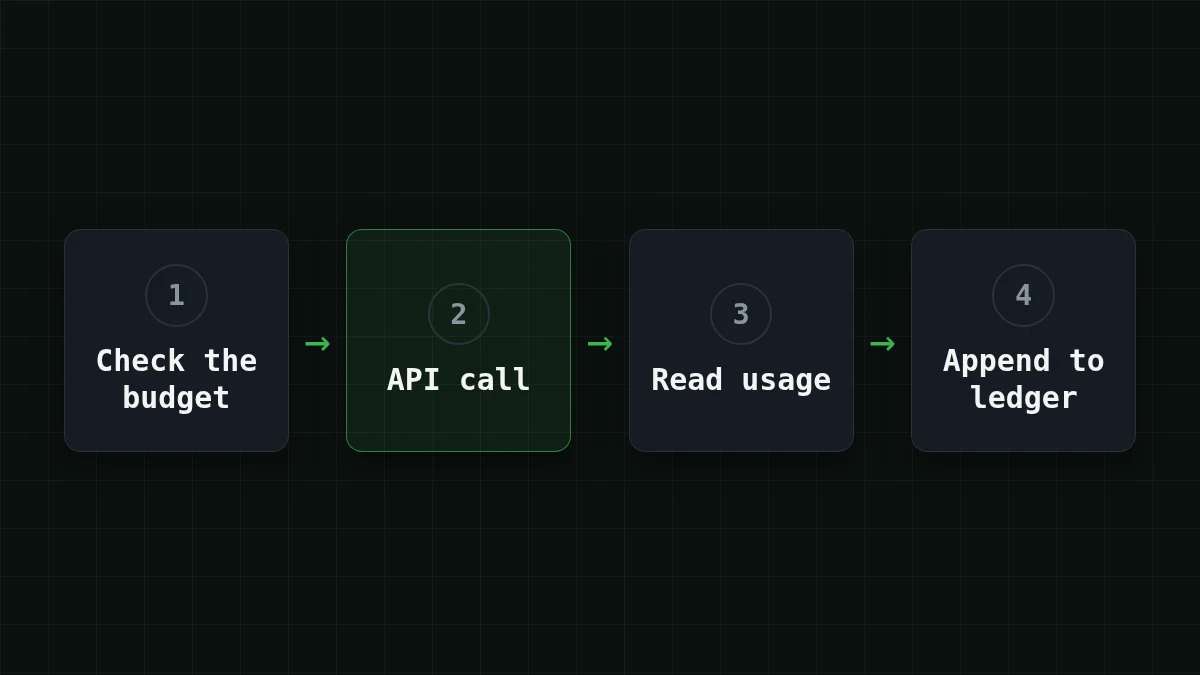
ここでの3つの選択は意図的だ。
- 1行1つのJSONオブジェクト(JSONL)、追記モードで開く。 130回目の呼び出しでスクリプトがクラッシュしても、1〜129回目はすでにディスク上にある。
- 合計は変数ではなくファイルから取得する。 スクリプトを再起動しても上限は維持される。台帳が前回の実行で使った額を覚えているからだ。
finish_reasonはトークンと並べて記録する。lengthと書かれた行は、回答がmax_tokensに達して打ち切られたことを意味する。後で知りたくなるはずだ。
2つのPRICE_定数はプレースホルダーだ。現在の数値は料金表から取得すること。これを書いている時点のDeepSeek-V4-Flashでは、100万入力トークンあたり$0.015、100万出力トークンあたり$0.10だ。MODELをzai-やMiniMaxAI/に変え、2つの定数を変えれば、同じ台帳がそれらでも機能する。
バッチループ: 済んだものはスキップ、上限で停止#
ループは短い。プロンプトが作業単位のID(doc-001など、1つの作業の名前)をキーとするdictにあるとする:
prompts = {
    'doc-001': 'Summarize this ticket in one sentence: ...',
    'doc-002': 'Summarize this ticket in one sentence: ...',
    # ... your 200 prompts
}

ledger = Ledger('ledger.jsonl', budget_usd=0.50)
already = ledger.done()

for unit, prompt in prompts.items():
    if unit in already:
        continue
    try:
        answer = ask(ledger, unit, prompt)
    except BudgetExceeded as e:
        print(e)
        break
    Path(f'out-{unit}.txt').write_text(answer)
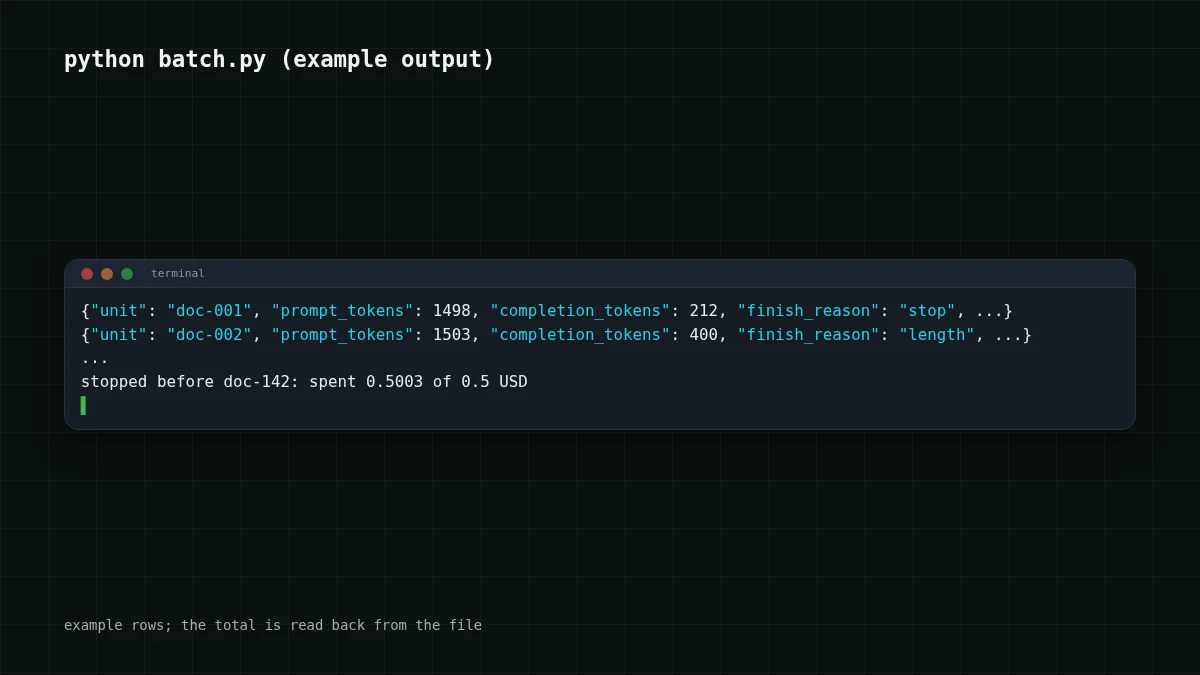
実行して途中でCtrl+Cを押し、もう一度実行する: 完了した単位はスキップされるので、台帳が進捗ファイルも兼ねる。予算を使い切れば、驚きではなく1行が返る。stopped before doc-のようなものだ。
前という言葉に注目してほしい。チェックは各呼び出しの前に行われるので、最後の呼び出しで合計が予算をわずかに超える可能性がある。超過幅には上限がある: 1回の呼び出しは最長のプロンプトとmax_tokensを足した額を超えられない。1,500トークンのプロンプトとmax_tokens=400なら、最大で$0.000063だ。だからラッパーのすべての呼び出しにmax_tokensがある: 際限のないリスクを、計画できる数値に変えるのだ。
実行前に請求額を見積もる#
次はもう半分: 起動前にコストを知ること。最初の5プロンプトを小さな予算でask()経由で実行し、台帳を読む。5行が平均1,500入力トークン、400出力トークンだったとする。これがバッチ全体の数値になる。
200プロンプトなら200 × 1,500 = 300,000入力トークン、200 × 400 = 80,000出力トークンだ。このワークロードを実際の価格で計算すると:
| モデル | 入力 $/1M | 出力 $/1M | リクエストあたり | 200 リクエスト | OpenRouter、200 リクエスト |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000046 | $0.0092 | $0.0167 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000063 | $0.0125 | $0.0322 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00014 | $0.027 | $0.324 |
リクエストあたり 1,500 入力トークンと 400 出力トークン。100万トークンあたりの価格は現行のもので、当社の料金体系に合わせて変動します。OpenRouter 列は同じワークロードの参考価格を示しています。
表にはOpenRouterの列もある。入力と出力を合計すると、この負荷ではDeepSeek-V4-FlashがOpenRouterより安くなり、その合計がバッチの実際の支払額だ。
プロンプトの長さは異なるので、5つのサンプルは推測であって約束ではない。安全側の上限が欲しいときは5つのうち最長を使い、残りは予算上限に任せよう。同じ200プロンプトで2つのモデルを比較したいなら、各モデルに独自の台帳ファイル(例えばLedger(f'ledger-)を与えれば、後で2つの合計を並べて見られる。
自分のバッチをここで試そう: サンプルからリクエストあたりのトークン数と、予定しているリクエスト数を設定する。
コスト計算機
あなたのバッチ: 5プロンプトのサンプルからのトークン数
リクエストあたりの入力トークン数: 1,500 · リクエストあたりの出力トークン数: 400 · 1日あたりのリクエスト数: 200
| モデル | 1日あたり | 1か月あたり |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0092 | $0.276 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0125 | $0.375 |
| MiniMax-M2.7$0.05$0.15 | $0.027 | $0.81 |
送信前にトークンを数える方法については、tiktokenでトークンを数えるを参照。
請求額が予想より大きいとき: 台帳を読む#
3つ目の読者のシナリオは厄介だ。エージェントの実行がおかしくなってループし、ダッシュボードには合計しか表示されない。台帳はどこでそうなったかを示す。行をコストでソートする:
rows = [json.loads(line) for line in open('ledger.jsonl')]
for r in sorted(rows, key=lambda r: r['cost_usd'], reverse=True)[:5]:
print(r['unit'], r['prompt_tokens'], r['completion_tokens'], r['finish_reason'])エージェントなら、単位をステップの名前(step-17)にすれば実行の形が見える。いくつかのパターンが繰り返し現れる。それぞれを通常の原因と照合しよう:
ペアを合わせる
各台帳パターンを通常の原因と照合する
左の項目をタップしてから、そのペアをタップ
- prompt_tokensが行ごとに少しずつ増えるループが各ステップで履歴全体を再送している
- completion_tokensがmax_tokensと等しく、finish_reasonがlength回答が上限で打ち切られ、打ち切られたテキストにも支払っている
- 同じ単位が何度も連続して現れるリトライループ、またはエージェントが1つのステップを繰り返している
- 1行のコストが他のすべてよりはるかに高い1つの巨大な入力、例えばファイル全体をプロンプトに貼り付けた
どのパターンも請求書よりずっと早く台帳に現れる。最初のものはエージェントが履歴を再読する理由で扱っている。
スクリプト外でプロジェクトごとの支出とアラートも欲しいなら、プロジェクト別予算アラートのガイドがその側面を扱っている。ここでの台帳はコード内にあり、停止を指示できる部分だ。
起動前に#
チェックリスト
最初の本番実行の前に
max_tokensを選ぶときに便利なDeepSeek-V4-Flashのコンテキストサイズと回答上限は、そのページにある: CheapTokensのDeepSeek-V4-Flash。


