AI 入门指南
在 Python 中限制 LLM 批处理的成本:账本与硬预算
将每次 API 调用的 token 数和费用记录到 JSONL 文件,在达到预算时停止批处理,并在运行前估算账单。包含 Python 代码。
你的脚本循环处理 200 条提示词,你合上笔记本电脑,第二天早上才发现这一夜花了多少钱。两个小习惯就能解决这个问题。每次 API 调用后,向账本文件追加一行,记录 token 数和费用。每次调用前,将累计总额与预算比较,达到预算就停止。这不到 50 行 Python 代码,而且用 5 条提示词试跑一次,就能在正式运行开始前知道账单。
Clocktower 运行中你可以借鉴的做法#
Dwarkesh Podcast 的主持人 Dwarkesh Patel 让 11 个模型在 Blood on the Clocktower 中互相对战,根据 README 共进行了 386 局游戏,并公开了代码、日志和评分(github.com/dwarkeshsp/clocktower,2026 年 11 月 8 日检查)。仓库中有两个细节值得借鉴。每个游戏目录都保留一份逐次调用的日志,记录 token 数和费用,支出写入 games/。一个 --budget 标志用于限制总支出;默认值为 $1,000。基准测试网站还增加了第三道防线:每个模型每回合都有相同的 8,000 token 上限(clocktowerbench.com)。
所以:每次调用有上限,每次调用有日志,总支出有封顶。锦标赛需要这三样,你的夜间运行也需要,只是规模更小。
把账本想象成商店收银机里的收据卷。每笔销售打印一行;经理随时可以汇总收据卷,并知道当天的备用金何时用完。
账本:一个文件,每次调用一行#
完整代码如下。它使用 openai 包并指向 CheapTokens(https:/,密钥和模型 ID 见文档)。
import json
import os
from pathlib import Path

from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
PRICE_IN, PRICE_OUT = 1.00, 2.00  # USD per 1M tokens: example, substitute current ones


class BudgetExceeded(Exception):
    pass


class Ledger:
    def __init__(self, path, budget_usd):
        self.path = Path(path)
        self.budget = budget_usd
        self.rows = []
        if self.path.exists():
            with self.path.open() as f:
                self.rows = [json.loads(line) for line in f if line.strip()]

    @property
    def spent(self):
        return sum(r['cost_usd'] for r in self.rows)

    def done(self):
        return {r['unit'] for r in self.rows}

    def check(self, unit):
        if self.spent >= self.budget:
            raise BudgetExceeded(
                f'stopped before {unit}: spent {self.spent:.4f} of {self.budget} USD'
            )

    def add(self, unit, usage, finish_reason):
        cost = (usage.prompt_tokens * PRICE_IN
                + usage.completion_tokens * PRICE_OUT) / 1_000_000
        row = {
            'unit': unit,
            'model': MODEL,
            'prompt_tokens': usage.prompt_tokens,
            'completion_tokens': usage.completion_tokens,
            'finish_reason': finish_reason,
            'cost_usd': round(cost, 6),
        }
        self.rows.append(row)
        with self.path.open('a') as f:
            f.write(json.dumps(row) + '\n')


def ask(ledger, unit, prompt, max_tokens=400):
    ledger.check(unit)
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[{'role': 'user', 'content': prompt}],
        max_tokens=max_tokens,
    )
    ledger.add(unit, resp.usage, resp.choices[0].finish_reason)
    return resp.choices[0].message.content
每次调用都经过同样的四个步骤:
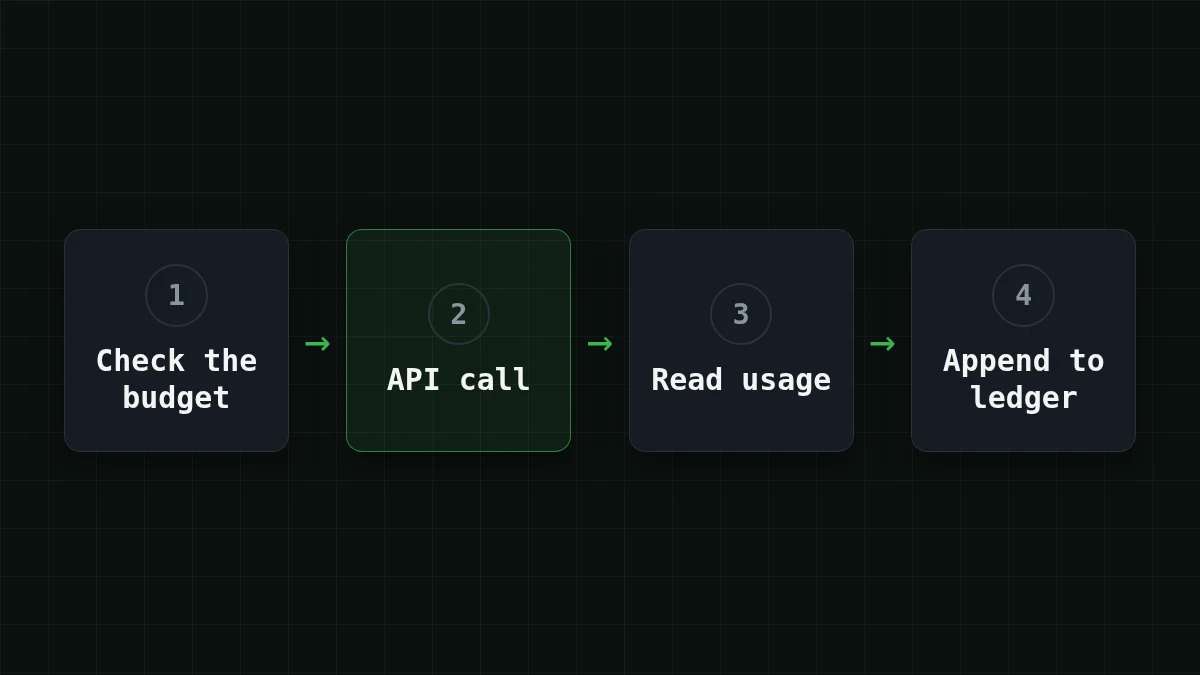
其中有三个选择是刻意为之。
- 每行一个 JSON 对象(JSONL),以追加模式打开。 如果脚本在第 130 次调用时崩溃,第 1 到 129 次调用已经写入磁盘。
- 总额来自文件,而不是变量。 重启脚本后上限仍然有效,因为账本记住了上一次运行花了多少。
finish_reason与 token 数一起记录。 一行显示length意味着回答达到了你的max_tokens并被截断。你之后会想知道这一点。
两个 PRICE_ 常量是占位符。请从价格表获取当前数字。对于你阅读本文时的 DeepSeek-V4-Flash,每 100 万输入 token 为 $0.015,每 100 万输出 token 为 $0.10。将 MODEL 改为 zai- 或 MiniMaxAI/ 并修改这两个常量,同一个账本对它们同样适用。
批处理循环:跳过已完成项,达到上限即停止#
循环很短。假设你的提示词放在一个以单元 ID 为键的字典中,单元 ID 是一项工作的名称,例如 doc-001:
prompts = {
    'doc-001': 'Summarize this ticket in one sentence: ...',
    'doc-002': 'Summarize this ticket in one sentence: ...',
    # ... your 200 prompts
}

ledger = Ledger('ledger.jsonl', budget_usd=0.50)
already = ledger.done()

for unit, prompt in prompts.items():
    if unit in already:
        continue
    try:
        answer = ask(ledger, unit, prompt)
    except BudgetExceeded as e:
        print(e)
        break
    Path(f'out-{unit}.txt').write_text(answer)
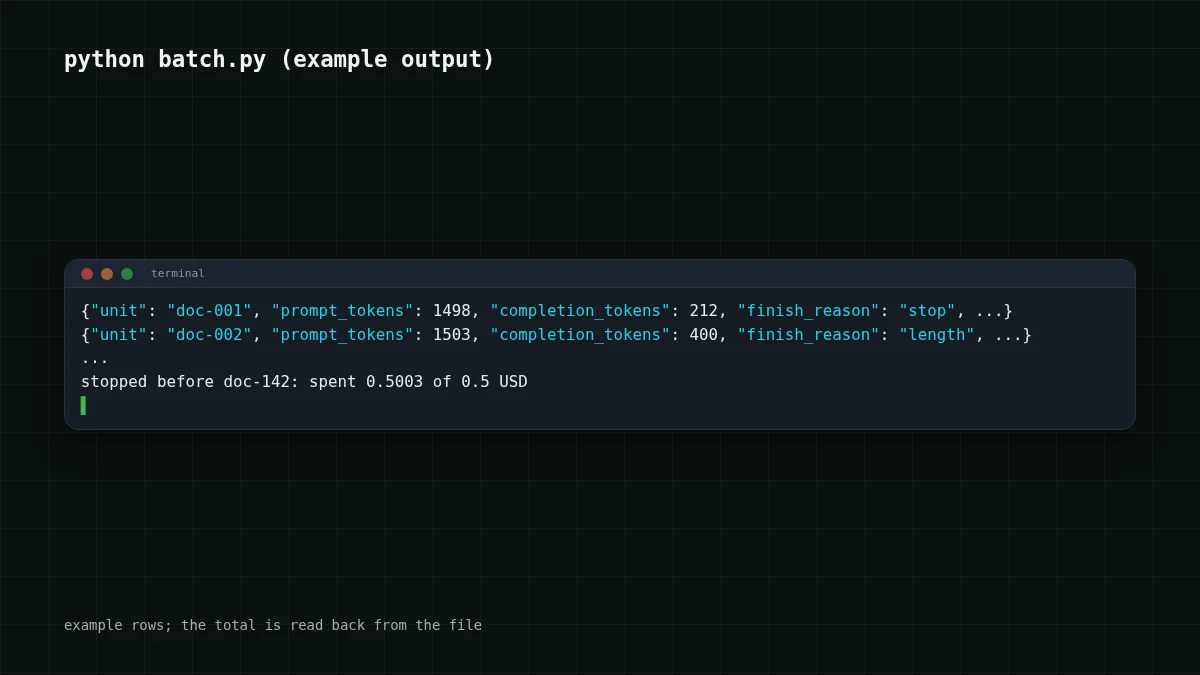
运行它,中途按 Ctrl+C,再次运行:已完成的单元会被跳过,因此账本同时充当进度文件。让预算用完,你会得到一行提示而不是意外,类似 stopped before doc-。
注意 before 这个词。检查发生在每次调用之前,所以最后一次调用可能使总额略微超出预算。超出多少是有界的:一次调用的费用不会超过你最长的提示词加上 max_tokens。对于 1,500 token 的提示词和 max_tokens=400,最多为 $0.000063。这就是为什么包装器中的每次调用都有 max_tokens:它把无界风险变成一个你可以规划的数字。
在按下运行前估算账单#
现在说另一半:在启动前知道成本。用较小的预算让前五条提示词通过 ask() 运行,并读取账本。假设这五行平均为 1,500 输入 token 和 400 输出 token。这些就是整批的数字。
对于 200 条提示词,即 200 × 1,500 = 300,000 输入 token 和 200 × 400 = 80,000 输出 token。以下是该工作负载按实时价格计算的费用:
| 模型 | 输入 $/1M | 输出 $/1M | 每次请求 | 200 次请求 | OpenRouter,200 次请求 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000046 | $0.0092 | $0.0167 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000063 | $0.0125 | $0.0322 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00014 | $0.027 | $0.324 |
每次请求 1,500 个输入 token 和 400 个输出 token。每 100 万 token 的价格为当前价格,会随我们的资费一同变动;OpenRouter 列显示相同工作负载的参考价格。
表中还有 OpenRouter 一列。将输入和输出合计计算,对于此负载,DeepSeek-V4-Flash 比 OpenRouter 更便宜,而这个总和才是批处理实际支付的费用。
提示词长度不同,所以五个样本只是猜测,不是承诺。当你想要安全的上限时,使用五个中最长的那个,然后让预算上限兜住其余部分。想在同样的 200 条提示词上比较两个模型?给每个模型各自的账本文件,例如 Ledger(f'ledger-,之后两个总额可以并排查看。
在这里试试你自己的批处理:根据样本设置每次请求的 token 数,以及你计划请求的次数。
成本计算器
你的批处理:来自 5 条提示词样本的 token 数
每次请求的输入 token 数: 1,500 · 每次请求的输出 token 数: 400 · 每日请求数: 200
| 模型 | 每天 | 每月 |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0092 | $0.276 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0125 | $0.375 |
| MiniMax-M2.7$0.05$0.15 | $0.027 | $0.81 |
关于发送前计算 token 的更多内容,请参阅使用 tiktoken 计算 token。
当账单超出预期:读取账本#
第三种读者场景是最糟糕的。一次 agent 运行出错并陷入循环,而仪表盘只显示一个总额。账本显示钱花在哪里。按费用对行排序:
rows = [json.loads(line) for line in open('ledger.jsonl')]
for r in sorted(rows, key=lambda r: r['cost_usd'], reverse=True)[:5]:
    print(r['unit'], r['prompt_tokens'], r['completion_tokens'], r['finish_reason'])
对于 agent,用步骤命名单元(step-17),这样你能看到运行的形态。有几种模式会反复出现;将每种模式与其常见原因对应起来:
配对
将每种账本模式与其常见原因对应
点击左侧项目,然后点击其配对项
- prompt_tokens 每行都略有增长循环在每一步都重新发送整个历史
- completion_tokens 等于 max_tokens 且 finish_reason 为 length回答在你的上限处被截断,而你为被截断的文本付费
- 同一个单元连续出现多次重试循环,或 agent 重复某一步骤
- 某一行的费用远高于其他所有行一个过大的输入,例如将整个文件粘贴到提示词中
每种模式在发票之前很久就能在账本中看到。第一种模式在为什么 agent 会重新读取其历史中有所介绍。
如果你还想在脚本之外获得按项目统计的支出和告警,这篇按项目预算告警指南涵盖了这方面。这里的账本是存在于你代码中、能够说停就停的那部分。
启动之前#
清单
首次正式运行之前
DeepSeek-V4-Flash 的上下文大小和回答限制在你选择 max_tokens 时很有用,详见其页面:CheapTokens 上的 DeepSeek-V4-Flash。


