KI für EinsteigerAnleitung
Die Kosten eines LLM-Batches in Python begrenzen: ein Ledger und ein hartes Budget
Loggen Sie Tokens und Kosten jedes API-Aufrufs in eine JSONL-Datei, stoppen Sie den Batch bei einem Budget und schätzen Sie die Rechnung, bevor Sie ihn ausführen. Python-Code inklusive.
Auf dieser Seite
Ihr Skript läuft über 200 Prompts, Sie klappen den Laptop zu, und am Morgen erfahren Sie, was die Nacht gekostet hat. Zwei kleine Gewohnheiten beheben das. Nach jedem API-Aufruf hängen Sie eine Zeile mit Tokens und Kosten an eine Ledger-Datei an. Vor jedem Aufruf vergleichen Sie die laufende Summe mit einem Budget und stoppen, wenn es erreicht ist. Das sind unter 50 Zeilen Python, und ein Testlauf mit 5 Prompts verrät Ihnen die Rechnung, bevor der echte Lauf beginnt.
Was der Clocktower-Lauf macht, das Sie kopieren können#
Dwarkesh Patel, Host des Dwarkesh Podcast, ließ 11 Modelle in Blood on the Clocktower gegeneinander antreten, laut README 386 Spiele, und veröffentlichte Code, Logs und Ratings (github.com/dwarkeshsp/clocktower, geprüft am 8. November 2026). Zwei Details aus dem Repo lohnen sich zum Nachahmen. Jedes Spielverzeichnis führt ein Log pro Aufruf mit Tokens und Kosten, und die Ausgaben gehen nach games/. Ein --budget-Flag begrenzt die Gesamtausgaben; der Standardwert ist $1.000. Die Benchmark-Seite fügt einen dritten Schutz hinzu: Jedes Modell bekommt pro Zug dieselbe Obergrenze von 8.000 Tokens (clocktowerbench.com).
Also: eine Obergrenze pro Aufruf, ein Log pro Aufruf, eine Obergrenze für die Summe. Ein Turnier braucht alle drei, und Ihr nächtlicher Lauf auch, nur kleiner.
Denken Sie an das Ledger wie an den Bon-Rollen in einer Ladenkasse. Jeder Verkauf druckt eine Zeile; der Manager kann die Rolle jederzeit aufsummieren und weiß, wann die Tageskasse leer ist.
Das Ledger: eine Datei, eine Zeile pro Aufruf#
Hier ist das Ganze. Es nutzt das openai-Paket, ausgerichtet auf CheapTokens (https:/, siehe die Dokumentation für den Key und die Modell-IDs).
import json
import os
from pathlib import Path

from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
PRICE_IN, PRICE_OUT = 1.00, 2.00  # USD per 1M tokens: example, substitute current ones


class BudgetExceeded(Exception):
    pass


class Ledger:
    def __init__(self, path, budget_usd):
        self.path = Path(path)
        self.budget = budget_usd
        self.rows = []
        if self.path.exists():
            with self.path.open() as f:
                self.rows = [json.loads(line) for line in f if line.strip()]

    @property
    def spent(self):
        return sum(r['cost_usd'] for r in self.rows)

    def done(self):
        return {r['unit'] for r in self.rows}

    def check(self, unit):
        if self.spent >= self.budget:
            raise BudgetExceeded(
                f'stopped before {unit}: spent {self.spent:.4f} of {self.budget} USD'
            )

    def add(self, unit, usage, finish_reason):
        cost = (usage.prompt_tokens * PRICE_IN
                + usage.completion_tokens * PRICE_OUT) / 1_000_000
        row = {
            'unit': unit,
            'model': MODEL,
            'prompt_tokens': usage.prompt_tokens,
            'completion_tokens': usage.completion_tokens,
            'finish_reason': finish_reason,
            'cost_usd': round(cost, 6),
        }
        self.rows.append(row)
        with self.path.open('a') as f:
            f.write(json.dumps(row) + '\n')


def ask(ledger, unit, prompt, max_tokens=400):
    ledger.check(unit)
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[{'role': 'user', 'content': prompt}],
        max_tokens=max_tokens,
    )
    ledger.add(unit, resp.usage, resp.choices[0].finish_reason)
    return resp.choices[0].message.content
Jeder Aufruf durchläuft dieselben vier Schritte:
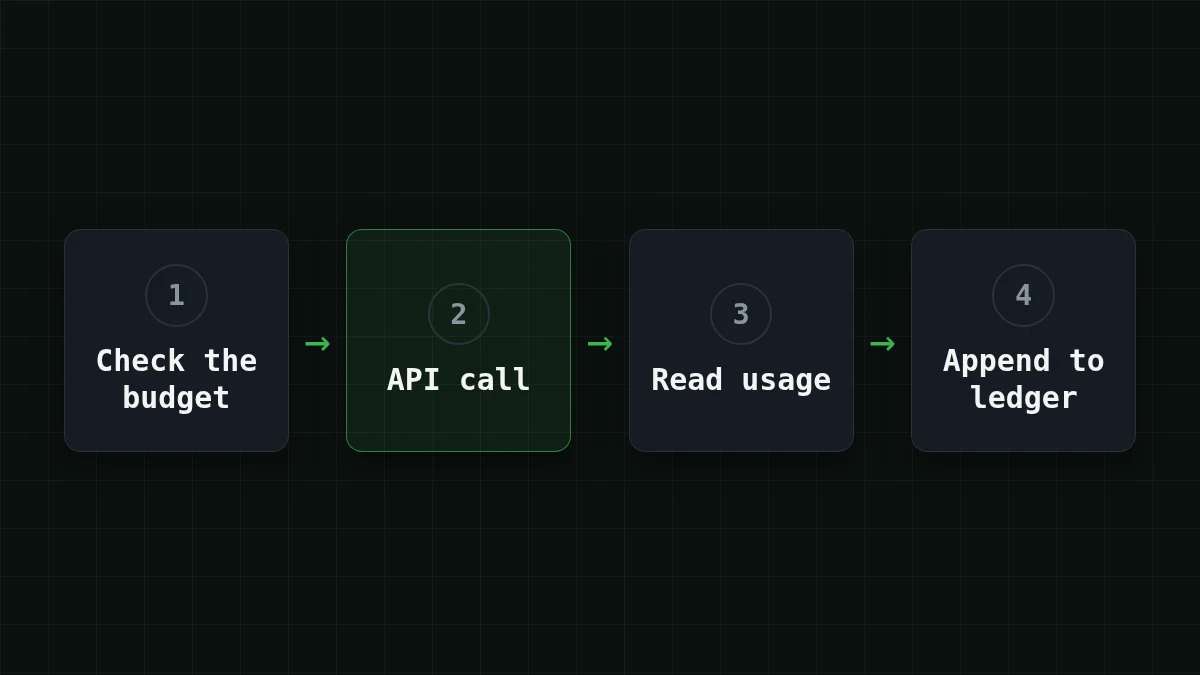
Drei Entscheidungen darin sind bewusst getroffen.
- Ein JSON-Objekt pro Zeile (JSONL), im Append-Modus geöffnet. Wenn das Skript bei Aufruf 130 abstürzt, liegen die Aufrufe 1 bis 129 bereits auf der Platte.
- Die Summe kommt aus der Datei, nicht aus einer Variable. Starten Sie das Skript neu, und die Obergrenze hält weiterhin, weil das Ledger sich merkt, was der vorherige Lauf ausgegeben hat.
finish_reasonwird neben den Tokens geloggt. Eine Zeile mitlengthbedeutet, dass die Antwort Ihrmax_tokenserreicht und abgeschnitten wurde. Das wollen Sie später wissen.
Die beiden PRICE_-Konstanten sind Platzhalter. Nehmen Sie die aktuellen Zahlen aus der Preistabelle. Für DeepSeek-V4-Flash sind das zum Zeitpunkt, an dem Sie dies lesen, $0.015 pro 1M Input-Tokens und $0.10 pro 1M Output-Tokens. Ändern Sie MODEL zu zai- oder MiniMaxAI/ und die beiden Konstanten, und dasselbe Ledger funktioniert für sie.
Die Batch-Schleife: Überspringen, was erledigt ist, am Cap stoppen#
Die Schleife ist kurz. Sagen wir, Ihre Prompts liegen in einem Dict, verschlüsselt nach einer Unit-ID, dem Namen eines Arbeitspakets, etwa doc-001:
prompts = {
    'doc-001': 'Summarize this ticket in one sentence: ...',
    'doc-002': 'Summarize this ticket in one sentence: ...',
    # ... your 200 prompts
}

ledger = Ledger('ledger.jsonl', budget_usd=0.50)
already = ledger.done()

for unit, prompt in prompts.items():
    if unit in already:
        continue
    try:
        answer = ask(ledger, unit, prompt)
    except BudgetExceeded as e:
        print(e)
        break
    Path(f'out-{unit}.txt').write_text(answer)
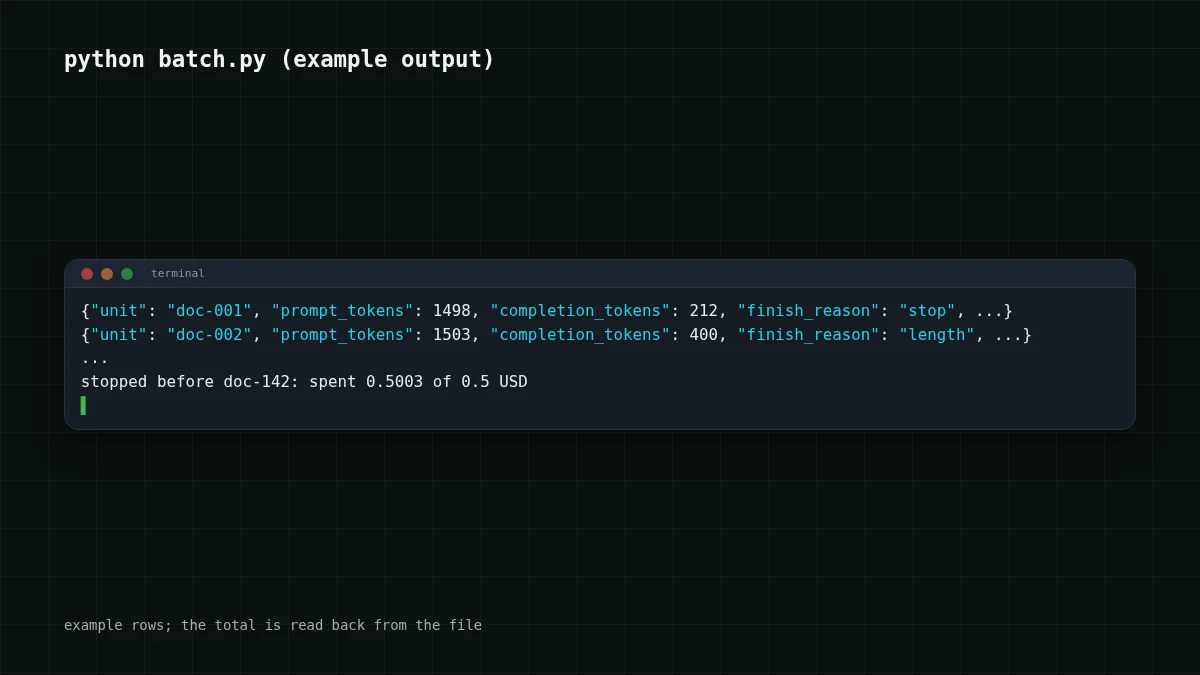
Führen Sie es aus, drücken Sie auf halbem Weg Ctrl+C, führen Sie es erneut aus: Erledigte Units werden übersprungen, sodass das Ledger zugleich Ihre Fortschrittsdatei ist. Lassen Sie das Budget ausgehen, und Sie bekommen eine Zeile statt einer Überraschung, etwa stopped before doc-.
Beachten Sie das Wort vor. Die Prüfung erfolgt vor jedem Aufruf, sodass der letzte Aufruf die Summe leicht über das Budget heben kann. Wie weit darüber, ist begrenzt: Ein Aufruf kann nicht mehr kosten als Ihr längster Prompt plus max_tokens. Bei einem Prompt mit 1.500 Tokens und max_tokens=400 sind das höchstens $0.000063. Deshalb hat jeder Aufruf im Wrapper ein max_tokens: Es verwandelt ein unbegrenztes Risiko in eine Zahl, mit der Sie planen können.
Die Rechnung schätzen, bevor Sie auf Start drücken#
Jetzt die andere Hälfte: die Kosten vor dem Start kennen. Lassen Sie die ersten fünf Prompts mit einem kleinen Budget durch ask() laufen und lesen Sie das Ledger. Sagen wir, die fünf Zeilen ergeben im Schnitt 1.500 Input-Tokens und 400 Output-Tokens. Das sind Ihre Zahlen für den gesamten Batch.
Für 200 Prompts sind das 200 × 1.500 = 300.000 Input-Tokens und 200 × 400 = 80.000 Output-Tokens. Hier ist diese Arbeitslast zu Live-Preisen:
| Modell | Input $/1M | Output $/1M | Pro Anfrage | 200 Anfragen | OpenRouter, 200 Anfragen |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000046 | $0.0092 | $0.0167 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000063 | $0.0125 | $0.0322 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00014 | $0.027 | $0.324 |
1.500 Input- und 400 Output-Tokens pro Anfrage. Die Preise pro 1 Mio. Tokens sind aktuell und ändern sich zusammen mit unseren Tarifen; die OpenRouter-Spalte zeigt Referenzpreise für dieselbe Arbeitslast.
Die Tabelle hat auch eine OpenRouter-Spalte. Zählt man Input und Output zusammen, kommt DeepSeek-V4-Flash für diese Last günstiger weg als OpenRouter, und diese Summe zahlt der Batch tatsächlich.
Prompts sind unterschiedlich lang, fünf Stichproben sind also eine Schätzung, kein Versprechen. Nehmen Sie den längsten der fünf, wenn Sie eine sichere Obergrenze wollen, und lassen Sie den Budget-Cap den Rest abfangen. Wollen Sie zwei Modelle auf denselben 200 Prompts vergleichen? Geben Sie jedem Modell eine eigene Ledger-Datei, zum Beispiel Ledger(f'ledger-, und die beiden Summen stehen danach nebeneinander.
Probieren Sie Ihren eigenen Batch hier aus: Setzen Sie die Tokens pro Anfrage aus Ihrer Stichprobe und wie viele Anfragen Sie planen.
Kostenrechner
Ihr Batch: Tokens aus Ihrer 5-Prompt-Stichprobe
Eingabe-Tokens pro Anfrage: 1.500 · Ausgabe-Tokens pro Anfrage: 400 · Anfragen pro Tag: 200
| Modell | Pro Tag | Pro Monat |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0092 | $0.276 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0125 | $0.375 |
| MiniMax-M2.7$0.05$0.15 | $0.027 | $0.81 |
Mehr zum Zählen von Tokens vor dem Senden finden Sie unter Tokens mit tiktoken zählen.
Wenn die Rechnung größer ist als erwartet: das Ledger lesen#
Das dritte Leser-Szenario ist das unangenehme. Ein Agent-Lauf geht schief und schleift, und das Dashboard zeigt nur eine Summe. Das Ledger zeigt, wo es passiert ist. Sortieren Sie die Zeilen nach Kosten:
rows = [json.loads(line) for line in open('ledger.jsonl')]
for r in sorted(rows, key=lambda r: r['cost_usd'], reverse=True)[:5]:
    print(r['unit'], r['prompt_tokens'], r['completion_tokens'], r['finish_reason'])
Benennen Sie bei einem Agenten die Unit nach dem Schritt (step-17), damit Sie die Form des Laufs sehen. Ein paar Muster tauchen immer wieder auf; ordnen Sie jedem seine übliche Ursache zu:
Paare zuordnen
Ordnen Sie jedes Ledger-Muster seiner üblichen Ursache zu
Tippe auf ein Element links, dann auf sein Paar
- prompt_tokens wächst mit jeder Zeile ein wenigDie Schleife sendet bei jedem Schritt die gesamte Historie erneut
- completion_tokens entspricht max_tokens und finish_reason ist lengthAntworten werden an Ihrem Cap abgeschnitten, und Sie zahlen für den abgeschnittenen Text
- Dieselbe Unit erscheint viele Male hintereinanderEine Retry-Schleife oder ein Agent, der einen Schritt wiederholt
- Eine Zeile kostet weit mehr als alle anderenEine überdimensionierte Eingabe, etwa eine ganze Datei, die in den Prompt eingefügt wurde
Jedes Muster ist im Ledger lange vor der Rechnung sichtbar. Das erste wird in warum ein Agent seine Historie erneut liest behandelt.
Wenn Sie zusätzlich Ausgaben pro Projekt und Alerts außerhalb des Skripts wollen, deckt dieser Leitfaden zu Budget-Alerts pro Projekt diese Seite ab. Das Ledger hier ist der Teil, der in Ihrem Code lebt und Stopp sagen kann.
Bevor Sie starten#
Checkliste
Vor dem ersten echten Lauf
Die Kontextgröße und das Antwortlimit von DeepSeek-V4-Flash, praktisch bei der Wahl von max_tokens, stehen auf seiner Seite: DeepSeek-V4-Flash auf CheapTokens.


