نئے سیکھنے والوں کے لیے AIگائیڈ
Python میں LLM بیچ کی لاگت کو کیپ کریں: ایک لیجر اور سخت بجٹ
ہر API کال کے ٹوکنز اور لاگت کو JSONL فائل میں لاگ کریں، بیچ کو بجٹ پر روکیں، اور چلانے سے پہلے بل کا اندازہ لگائیں۔ Python کوڈ شامل ہے۔
اس صفحہ پر
آپ کا اسکرپٹ 200 پرامپٹس پر لوپ کرتا ہے، آپ لیپ ٹاپ کا ڈھکن بند کرتے ہیں، اور صبح معلوم ہوتا ہے کہ رات پر کتنا خرچ آیا۔ دو چھوٹی عادتیں یہ ٹھیک کر دیتی ہیں۔ ہر API کال کے بعد، ٹوکنز اور لاگت کے ساتھ ایک لائن لیجر فائل میں شامل کریں۔ ہر کال سے پہلے، چلتے ہوئے کل کو بجٹ سے موازنہ کریں اور اگر حد پہنچ جائے تو رک جائیں۔ یہ Python کی 50 سے کم لائنوں میں ہوتا ہے، اور 5 پرامپٹس کا آزمائشی رن اصل رن شروع ہونے سے پہلے آپ کو بل بتا دیتا ہے۔
Clocktower کا رن کیا کرتا ہے جو آپ کاپی کر سکتے ہیں#
Dwarkesh Podcast کے میزبان Dwarkesh Patel نے Blood on the Clocktower میں 11 ماڈلز کو ایک دوسرے کے خلاف چلایا، README کے مطابق 386 گیمز، اور کوڈ، لاگز اور ریٹنگز شائع کیں (github.com/dwarkeshsp/clocktower، 8 نومبر 2026 کو چیک کیا گیا)۔ ریپو سے دو تفصیلیں چرانے کے قابل ہیں۔ ہر گیم ڈائریکٹری میں ٹوکنز اور لاگت کے ساتھ فی کال لاگ رکھا جاتا ہے، اور خرچ games/ میں جاتا ہے۔ ایک --budget فلیگ کل خرچ کو محدود کرتا ہے؛ ڈیفالٹ $1,000 ہے۔ بینچ مارک سائٹ ایک تیسرا گارڈ شامل کرتی ہے: ہر ماڈل کو فی ٹرن یکساں 8,000 ٹوکن کی حد ملتی ہے (clocktowerbench.com)۔
تو: ہر کال پر ایک حد، ہر کال کا ایک لاگ، کل پر ایک کیپ۔ ایک ٹورنامنٹ کو تینوں چاہیے، اور آپ کے رات بھر کے رن کو بھی، بس چھوٹے پیمانے پر۔
لیجر کو دکان کے کیش رجسٹر میں رسید کے رول کی طرح سمجھیں۔ ہر فروخت ایک لائن پرنٹ کرتی ہے؛ منیجر کسی بھی لمحے رول جمع کر کے جان سکتا ہے کہ دن کا فلوٹ کب ختم ہوا۔
لیجر: ایک فائل، فی کال ایک لائن#
پوری چیز یہ ہے۔ یہ openai پیکیج استعمال کرتی ہے جو CheapTokens کی طرف اشارہ کرتا ہے (https:/، کلید اور ماڈل آئی ڈیز کے لیے docs دیکھیں)۔
import json
import os
from pathlib import Path

from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
PRICE_IN, PRICE_OUT = 1.00, 2.00  # USD per 1M tokens: example, substitute current ones


class BudgetExceeded(Exception):
    pass


class Ledger:
    def __init__(self, path, budget_usd):
        self.path = Path(path)
        self.budget = budget_usd
        self.rows = []
        if self.path.exists():
            with self.path.open() as f:
                self.rows = [json.loads(line) for line in f if line.strip()]

    @property
    def spent(self):
        return sum(r['cost_usd'] for r in self.rows)

    def done(self):
        return {r['unit'] for r in self.rows}

    def check(self, unit):
        if self.spent >= self.budget:
            raise BudgetExceeded(
                f'stopped before {unit}: spent {self.spent:.4f} of {self.budget} USD'
            )

    def add(self, unit, usage, finish_reason):
        cost = (usage.prompt_tokens * PRICE_IN
                + usage.completion_tokens * PRICE_OUT) / 1_000_000
        row = {
            'unit': unit,
            'model': MODEL,
            'prompt_tokens': usage.prompt_tokens,
            'completion_tokens': usage.completion_tokens,
            'finish_reason': finish_reason,
            'cost_usd': round(cost, 6),
        }
        self.rows.append(row)
        with self.path.open('a') as f:
            f.write(json.dumps(row) + '\n')


def ask(ledger, unit, prompt, max_tokens=400):
    ledger.check(unit)
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[{'role': 'user', 'content': prompt}],
        max_tokens=max_tokens,
    )
    ledger.add(unit, resp.usage, resp.choices[0].finish_reason)
    return resp.choices[0].message.content
ہر کال انہی چار مراحل سے گزرتی ہے:
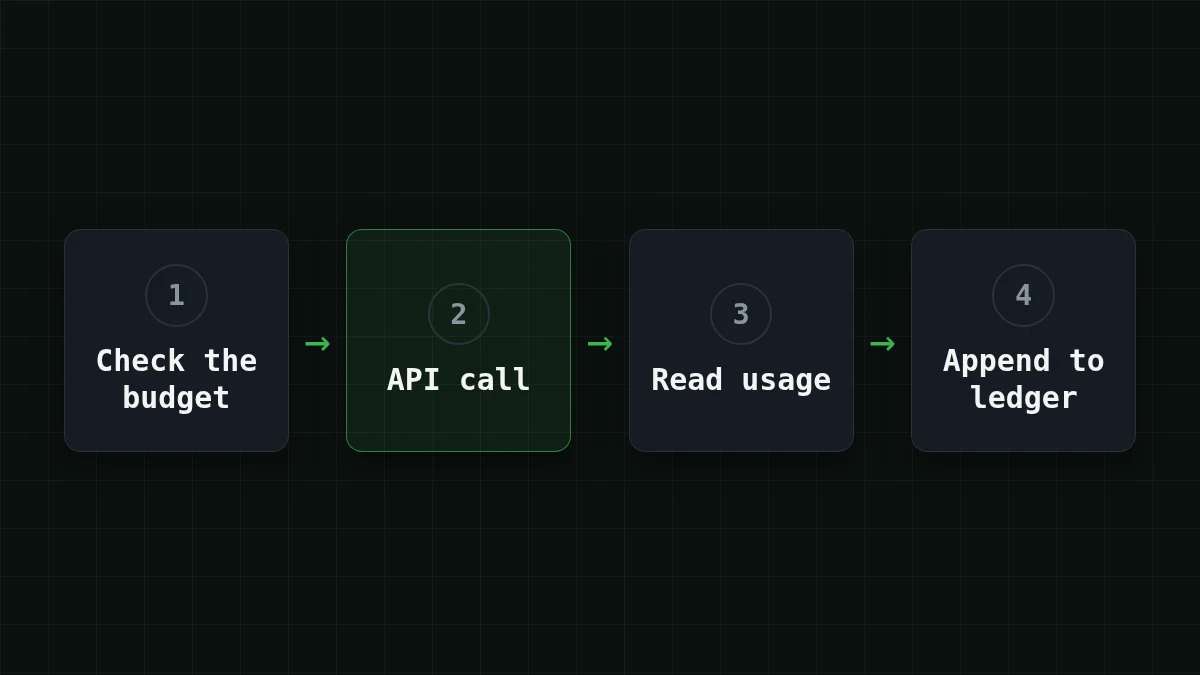
وہاں تین انتخاب جان بوجھ کر کیے گئے ہیں۔
- فی لائن ایک JSON آبجیکٹ (JSONL)، اپینڈ موڈ میں کھولا گیا۔ اگر اسکرپٹ کال 130 پر کریش ہو جائے، تو کالز 1 سے 129 پہلے ہی ڈسک پر ہیں۔
- کل رقم فائل سے آتی ہے، کسی ویری ایبل سے نہیں۔ اسکرپٹ دوبارہ شروع کریں اور کیپ پھر بھی برقرار رہتی ہے، کیونکہ لیجر یاد رکھتا ہے کہ پچھلے رن نے کتنا خرچ کیا۔
finish_reasonٹوکنز کے ساتھ لاگ ہوتا ہے۔ ایک قطار جس میںlengthلکھا ہو کا مطلب ہے کہ جواب آپ کےmax_tokensپر پہنچ کر کٹ گیا۔ آپ کو بعد میں یہ جاننا ہوگا۔
دو PRICE_ کانسٹنٹس پلیس ہولڈرز ہیں۔ موجودہ نمبر pricing table سے لیں۔ DeepSeek-V4-Flash کے لیے جس وقت آپ یہ پڑھ رہے ہیں، وہ $0.015 فی 1M ان پٹ ٹوکنز اور $0.10 فی 1M آؤٹ پٹ ٹوکنز ہے۔ MODEL کو zai- یا MiniMaxAI/ اور دو کانسٹنٹس میں بدلیں، اور وہی لیجر ان کے لیے بھی کام کرتا ہے۔
بیچ لوپ: جو ہو چکا اسے چھوڑیں، کیپ پر رکیں#
لوپ مختصر ہے۔ فرض کریں آپ کے پرامپٹس ایک ڈکٹ میں ہیں جس کی کلید یونٹ آئی ڈی ہے، یعنی کام کے ایک ٹکڑے کا نام، جیسے doc-001:
prompts = {
    'doc-001': 'Summarize this ticket in one sentence: ...',
    'doc-002': 'Summarize this ticket in one sentence: ...',
    # ... your 200 prompts
}

ledger = Ledger('ledger.jsonl', budget_usd=0.50)
already = ledger.done()

for unit, prompt in prompts.items():
    if unit in already:
        continue
    try:
        answer = ask(ledger, unit, prompt)
    except BudgetExceeded as e:
        print(e)
        break
    Path(f'out-{unit}.txt').write_text(answer)
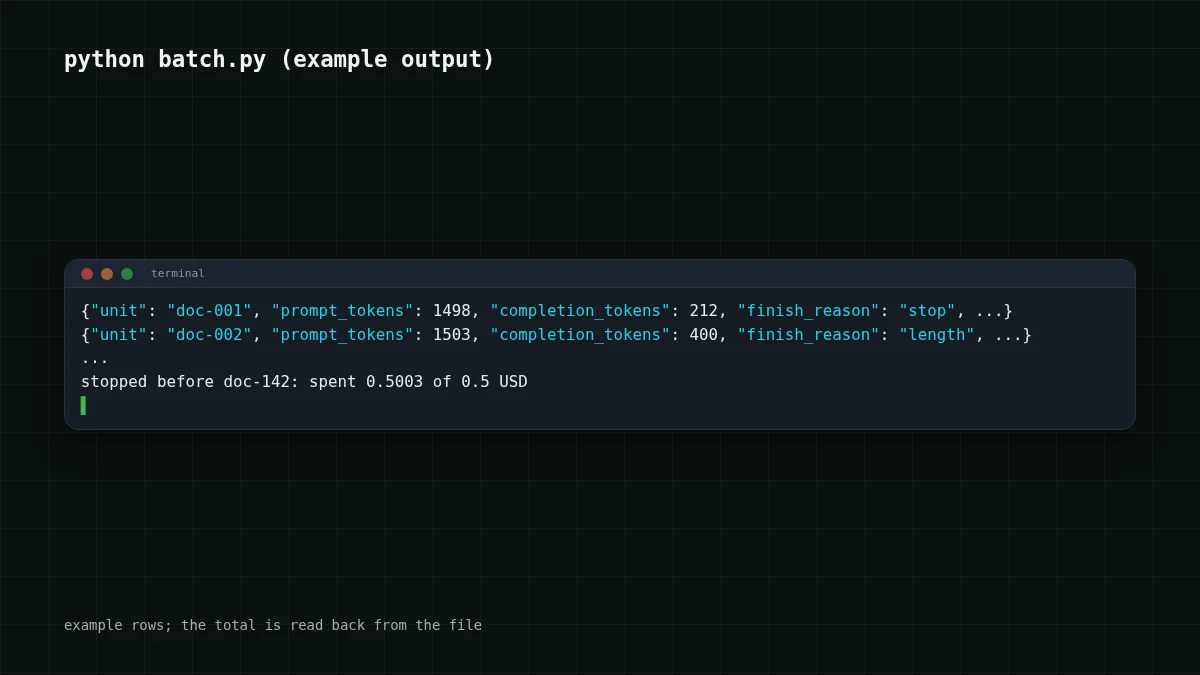
اسے چلائیں، آدھے راستے میں Ctrl+C دبائیں، دوبارہ چلائیں: مکمل شدہ یونٹس چھوڑ دیے جاتے ہیں، تو لیجر آپ کی پروگریس فائل کا بھی کام کرتا ہے۔ بجٹ ختم ہونے دیں اور آپ کو حیرت کے بجائے ایک لائن ملے گی، کچھ ایسی stopped before doc-۔
لفظ پہلے پر غور کریں۔ چیک ہر کال سے آگے ہوتا ہے، تو آخری کال کل کو بجٹ سے تھوڑا اوپر دھکیل سکتی ہے۔ کتنا اوپر، اس کی حد ہے: ایک کال آپ کے سب سے لمبے پرامپٹ کے علاوہ max_tokens سے زیادہ خرچ نہیں کر سکتی۔ 1,500 ٹوکن کے پرامپٹ اور max_tokens=400 کے لیے یہ زیادہ سے زیادہ $0.000063 ہے۔ اسی لیے ریپر میں ہر کال کے پاس max_tokens ہے: یہ کھلے سرے کے خطرے کو ایک ایسے نمبر میں بدل دیتا ہے جس کے گرد آپ منصوبہ بنا سکتے ہیں۔
رن دبانے سے پہلے بل کا اندازہ لگائیں#
اب دوسرا حصہ: لانچ سے پہلے لاگت جاننا۔ پہلے پانچ پرامپٹس کو چھوٹے بجٹ کے ساتھ ask() کے ذریعے چلائیں اور لیجر پڑھیں۔ فرض کریں پانچ قطاروں کی اوسط 1,500 ان پٹ ٹوکنز اور 400 آؤٹ پٹ ٹوکنز ہے۔ یہ پورے بیچ کے لیے آپ کے نمبر ہیں۔
200 پرامپٹس کے لیے یہ 200 × 1,500 = 300,000 ان پٹ ٹوکنز اور 200 × 400 = 80,000 آؤٹ پٹ ٹوکنز ہے۔ یہاں وہ ورک لوڈ لائیو قیمتوں پر ہے:
| ماڈل | ان پٹ $/1M | آؤٹ پٹ $/1M | فی درخواست | 200 درخواستیں | OpenRouter، 200 درخواستیں |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000046 | $0.0092 | $0.0167 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000063 | $0.0125 | $0.0322 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00014 | $0.027 | $0.324 |
فی درخواست 1,500 ان پٹ اور 400 آؤٹ پٹ ٹوکنز۔ فی 1M ٹوکنز کی قیمتیں موجودہ ہیں اور ہمارے ٹیرف کے ساتھ تبدیل ہوتی ہیں؛ OpenRouter کالم اسی ورک لوڈ کے لیے حوالہ جاتی قیمتیں دکھاتا ہے۔
ٹیبل میں OpenRouter کا کالم بھی ہے۔ ان پٹ اور آؤٹ پٹ کو ملا کر گننے پر، اس لوڈ کے لیے DeepSeek-V4-Flash OpenRouter سے سستا نکلتا ہے، اور بیچ واقعی یہی رقم ادا کرتا ہے۔
پرامپٹس کی لمبائی مختلف ہوتی ہے، تو پانچ نمونے ایک اندازہ ہیں، کوئی وعدہ نہیں۔ محفوظ بالائی حد چاہیے تو پانچ میں سے سب سے لمبا استعمال کریں، پھر باقی بجٹ کیپ سنبھال لے گی۔ ایک ہی 200 پرامپٹس پر دو ماڈلز کا موازنہ کرنا ہے؟ ہر ماڈل کو اپنی لیجر فائل دیں، مثلاً Ledger(f'ledger-، اور بعد میں دونوں کل رقمیں ساتھ ساتھ ہوں گی۔
یہاں اپنا بیچ آزمائیں: اپنے نمونے سے فی درخواست ٹوکنز اور کتنی درخواستیں کرنے کا ارادہ ہے، سیٹ کریں۔
لاگت کیلکولیٹر
آپ کا بیچ: آپ کے 5-پرامپٹ نمونے سے ٹوکنز
فی درخواست ان پٹ ٹوکنز: 1,500 · فی درخواست آؤٹ پٹ ٹوکنز: 400 · فی دن درخواستیں: 200
| ماڈل | فی دن | فی ماہ |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0092 | $0.276 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0125 | $0.375 |
| MiniMax-M2.7$0.05$0.15 | $0.027 | $0.81 |
بھیجنے سے پہلے ٹوکنز گننے کے بارے میں مزید کے لیے، counting tokens with tiktoken دیکھیں۔
جب بل توقع سے بڑا ہو: لیجر پڑھیں#
تیسرا قاری منظر سب سے بدتر ہے۔ ایک ایجنٹ رن غلط ہو کر لوپ میں پھنس جاتا ہے، اور ڈیش بورڈ صرف کل رقم دکھاتا ہے۔ لیجر دکھاتا ہے کہ کہاں گیا۔ قطاروں کو لاگت کے حساب سے ترتیب دیں:
rows = [json.loads(line) for line in open('ledger.jsonl')]
for r in sorted(rows, key=lambda r: r['cost_usd'], reverse=True)[:5]:
    print(r['unit'], r['prompt_tokens'], r['completion_tokens'], r['finish_reason'])
ایجنٹ کے لیے، یونٹ کا نام مرحلے کے مطابق رکھیں (step-17) تاکہ آپ رن کی ساخت دیکھ سکیں۔ چند پیٹرن بار بار سامنے آتے ہیں؛ ہر ایک کو اس کی معمول کی وجہ سے ملائیں:
جوڑے ملائیں
ہر لیجر پیٹرن کو اس کی معمول کی وجہ سے ملائیں
بائیں طرف کسی آئٹم پر ٹیپ کریں، پھر اس کا جوڑا
- prompt_tokens ہر قطار پر تھوڑا بڑھتا ہےلوپ ہر مرحلے پر پوری ہسٹری دوبارہ بھیجتا ہے
- completion_tokens برابر ہے max_tokens کے اور finish_reason ہے lengthجوابات آپ کی حد پر کٹ جاتے ہیں، اور آپ کٹے متن کی قیمت ادا کرتے ہیں
- وہی یونٹ کئی بار مسلسل آتا ہےایک ریٹری لوپ، یا ایجنٹ کا ایک ہی مرحلہ دہرانا
- ایک قطار باقی سب سے کہیں زیادہ مہنگی ہےایک حد سے بڑا ان پٹ، جیسے پوری فائل پرامپٹ میں چسپاں کرنا
ہر پیٹرن انوائس سے بہت پہلے لیجر میں نظر آتا ہے۔ پہلا why an agent re-reads its history میں کور کیا گیا ہے۔
اگر آپ اسکرپٹ سے باہر فی پروجیکٹ خرچ اور الرٹس بھی چاہتے ہیں، تو this guide to per-project budget alerts اس حصے کو کور کرتا ہے۔ یہاں کا لیجر وہ حصہ ہے جو آپ کے کوڈ میں رہتا ہے اور "رکو" کہہ سکتا ہے۔
لانچ سے پہلے#
چیک لسٹ
پہلے اصل رن سے پہلے
DeepSeek-V4-Flash کا کانٹیکسٹ سائز اور جواب کی حد، جو max_tokens منتخب کرتے وقت کام آتی ہے، اس کے صفحے پر ہے: DeepSeek-V4-Flash on CheapTokens۔


