لاگت کی بہتریگائیڈ
چلانے سے پہلے ماڈل ٹورنامنٹ کی API لاگت کا اندازہ لگائیں
فی سیٹ ٹوکن گنیں، کھیلوں اور فریق کے تبادلوں سے ضرب دیں، اور Python میں سخت حد لگائیں: 6 سیٹ، 60 کھیل کے ماڈل ٹورنامنٹ کا مکمل اندازہ۔
اس صفحہ پر
آپ پہلی درخواست سے پہلے ہی کسی ماڈل ٹورنامنٹ کا بل جان سکتے ہیں: ایک سیٹ پورے کھیل میں کتنے ٹوکن بھیجتا ہے گن لیں، سیٹوں اور کھیلوں سے ضرب دیں، اور کوڈ میں ایک سخت حد لگا دیں۔ جو چیز لوگ نظر انداز کرتے ہیں وہ تاریخ (history) ہے۔ ہر باری اب تک کی ہر بات دوبارہ بھیجتی ہے، اس لیے ان پٹ باریوں کی تعداد سے کہیں زیادہ تیزی سے بڑھتا ہے۔
$20,000 کی سرخی کیا بتاتی ہے اور کیا نہیں#
5 نومبر 2026 کو پوڈکاسٹر Dwarkesh Patel نے Clocktower Bench شائع کیا، ایک بینچ مارک جس میں ماڈلز ایک دوسرے کے خلاف سماجی استدلال کا کھیل Blood on the Clocktower کھیلتے ہیں۔ ان کا کہنا ہے کہ انہوں نے ہارنس بنانے پر تقریباً $20,000 کے API کریڈٹس خرچ کیے، اور اس کا بڑا حصہ ماحول کے ڈیزائن پر تکرار کرنے میں گیا، ان ٹوکنز سے زیادہ جو انہوں نے منصوبہ بندی کی تھی۔
اس پروجیکٹ کا README (8 نومبر 2026 کو چیک کیا گیا) سیٹ اپ بیان کرتا ہے: 11 ماڈلز، سرخی کی رینکنگ کے لیے 386 کھیل، ایک ماڈل ہر اچھی سیٹ پر اور دوسرا ہر بری سیٹ پر، 10–12 کھلاڑی، کئی گھنٹے چلنے والے کھیل۔ ہر ڈیل فریق بدل کر دوبارہ کھیلی جاتی ہے، تاکہ کسی ماڈل کو آسان کردار نہ ملے۔ یہ ایک مفت ڈرائی رن (--model random) بھی فراہم کرتا ہے، خرچ games/ میں لکھتا ہے، اور اس میں --budget حد ہے جو بطور ڈیفالٹ $1,000 ہے۔
جو یہ نہیں دیتا وہ فی کھیل ٹوکنز ہیں۔ تو نقل کرنے کے لیے کچھ نہیں؛ آپ خود اندازہ بناتے ہیں۔ یہی اس مضمون کے باقی حصے میں کیا گیا ہے، واضح مفروضوں کے ساتھ جنہیں آپ اپنے مفروضوں سے بدل سکتے ہیں۔
ایک سیٹ: ان پٹ کیوں بڑھتا رہتا ہے#
فرض کریں آپ ایک چھوٹا کھیل چلاتے ہیں: 6 سیٹ، ہر سیٹ ایک ماڈل جس کی اپنی گفتگو ہے، فی سیٹ 20 باریاں۔ فرض کریں 2,000 ٹوکن کا سسٹم پرامپٹ (قواعد اور سیٹ کا کردار)، ہر باری سے پہلے 600 نئے ٹوکن کی میز کی گفتگو آتی ہے، اور جواب 300 ٹوکن کا ہے۔ API کی کوئی یادداشت نہیں، اس لیے ہر درخواست پوری گفتگو دوبارہ لے کر جاتی ہے (لمبی چیٹ زیادہ مہنگی کیوں ہے)۔
باری 1 میں 2,000 + 600 = 2,600 ٹوکن جاتے ہیں۔ باری 20 میں 2,000 + 600 × 20 + 300 × 19 = 19,700 جاتے ہیں۔ آخری عدد خود آزمائیں:
نمبر کا اندازہ لگائیں
ایک سیٹ اپنی 20ویں باری پر کتنے ان پٹ ٹوکن بھیجتا ہے؟
آپ کا اندازہ
040,000
جواب دکھائیں
جواب: 19,700
19,700: 2,000 ٹوکن کا سسٹم پرامپٹ، 20 × 600 نئی گفتگو، اور 19 پچھلے جوابات ہر ایک 300 کے۔ ہر پرانا جواب اور ہر پرانا پیغام واپس جاتا ہے۔
ایک سیٹ کی تمام 20 باریاں جمع کریں: 2,000 × 20 + 600 × 210 + 300 × 190 = 40,000 + 126,000 + 57,000 = 223,000 ان پٹ ٹوکن۔ آؤٹ پٹ صرف 20 × 300 = 6,000 ہے۔ اگر آپ ہر پیغام ایک بار گنتے تو 2,000 + 20 × 600 = 14,000 ملتا اور سولہ گنا غلط ہوتے۔
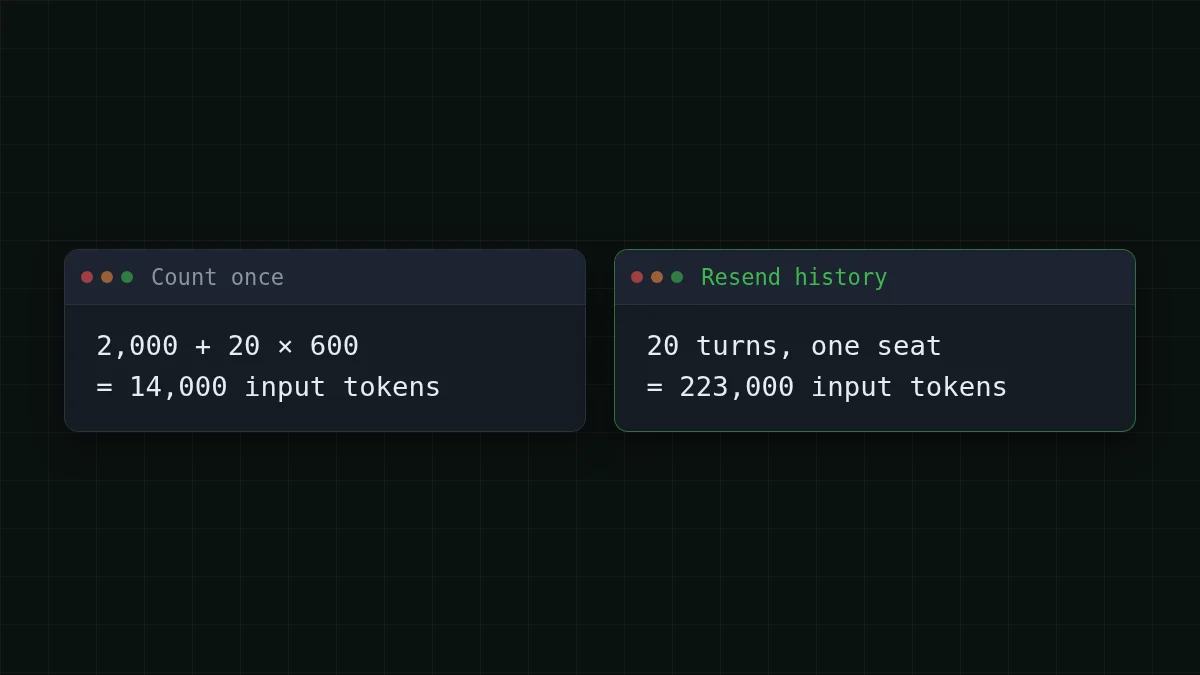
آؤٹ پٹ کا پہلو بمشکل ہلتا ہے۔ پیسہ ان پٹ پر جاتا ہے، اور یہی وہ پہلو ہے جو کھیل لمبے ہونے کے ساتھ بدتر ہوتا جاتا ہے۔
ایک سیٹ سے پورے ٹورنامنٹ تک#
اب اسے تین ضربوں سے بڑھائیں۔
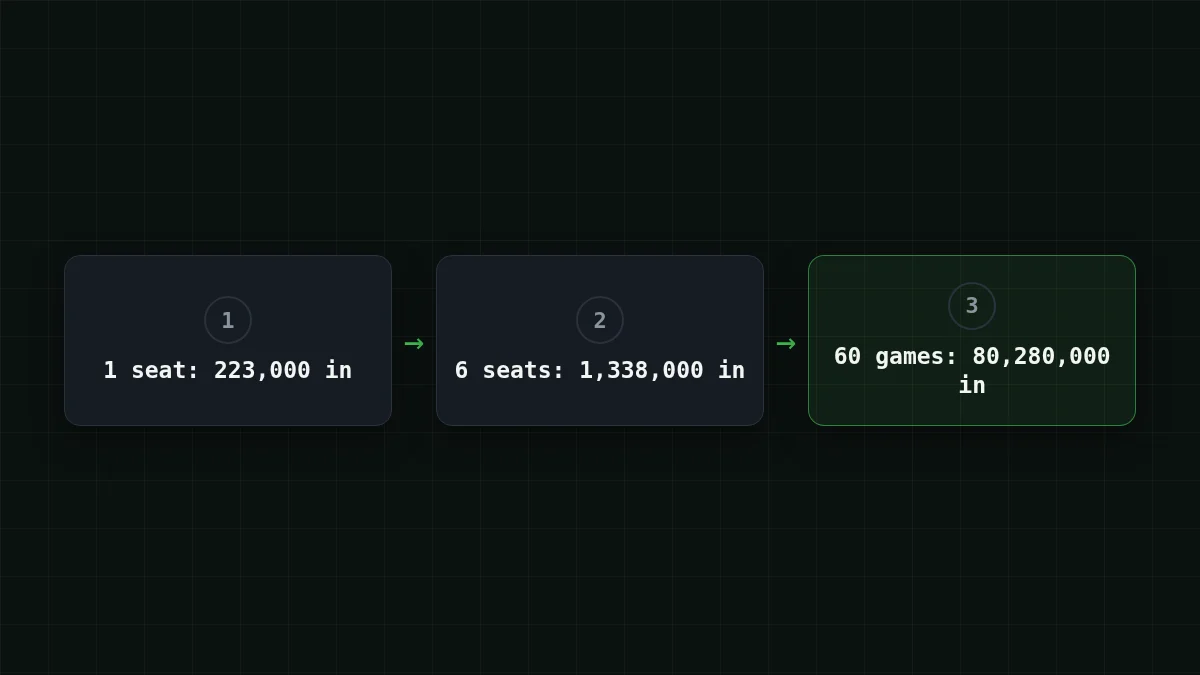
- سیٹیں۔ 6 سیٹ × 223,000 = 1,338,000 ان پٹ ٹوکن اور فی کھیل 6 × 6,000 = 36,000 آؤٹ پٹ ٹوکن۔
- فریق کا تبادلہ۔ راؤنڈ روبن میں 3 ماڈل لیں: 3 جوڑے۔ ہر جوڑے میں 10 ڈیلیں کھیلیں، ہر ایک دو بار فریق بدل کر: 3 × 10 × 2 = 60 کھیل۔
- کھیل۔ ٹورنامنٹ کے لیے 60 × 1,338,000 = 80,280,000 ان پٹ اور 60 × 36,000 = 2,160,000 آؤٹ پٹ ٹوکن۔
DeepSeek-V4-Flash پر ایک کھیل $0.0237 بنتا ہے۔ نیچے دیا گیا جدول پورے 60 کھیلوں کے ٹورنامنٹ کی قیمت لگاتا ہے گویا وہ ایک ماڈل ہر سیٹ پر کھیل رہا ہو، تاکہ آپ ان تین ماڈلز کا موازنہ کر سکیں جو CheapTokens اس قسم کے طویل گفتگو کے کام کے لیے پیش کرتا ہے۔ مجموعی طور پر، ان پٹ اور آؤٹ پٹ ملا کر، ان میں سے ہر ایک آخری کالم میں دیے گئے OpenRouter حوالے سے سستا ہے۔
| ماڈل | ان پٹ $/1M | آؤٹ پٹ $/1M | فی درخواست | 60 درخواستیں | OpenRouter، 60 درخواستیں |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0282 | $1.69 | $2.87 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0237 | $1.42 | $5.92 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0723 | $4.34 | $52.06 |
فی درخواست 1,338,000 ان پٹ اور 36,000 آؤٹ پٹ ٹوکنز۔ فی 1M ٹوکنز کی قیمتیں موجودہ ہیں اور ہمارے ٹیرف کے ساتھ تبدیل ہوتی ہیں؛ OpenRouter کالم اسی ورک لوڈ کے لیے حوالہ جاتی قیمتیں دکھاتا ہے۔
بجٹ کے لحاظ سے یہی پورا نکتہ ہے: یہ جاننے کے لیے کہ تین ماڈلز میں سے کون سا گفت و شنید کا کھیل بہتر کھیلتا ہے، آپ کو $20,000 کی لائن آئٹم کی ضرورت نہیں۔ آپ کو اوپر دیا گیا اندازہ چاہیے، اور پھر اسے جانچنے کے لیے ایک حقیقی پائلٹ۔
فوری جانچ
آپ کا 6 سیٹ کا کھیل فی سیٹ 20 سے 40 باریوں تک جاتا ہے۔ ان پٹ بل کا کیا ہوتا ہے؟
جواب دکھائیں
جواب: یہ تقریباً 3.6 گنا بڑھتا ہے
40 باریوں کے لیے وہی فارمولا 2,000 × 40 + 600 × 820 + 300 × 780 = 806,000 ان پٹ ٹوکن دیتا ہے، بمقابلہ 20 باریوں کے 223,000۔ تاریخ کا رکن باریوں کی تعداد کے مربع کے ساتھ بڑھتا ہے۔
ایسے کسی بھی عدد پر بھروسہ کرنے سے پہلے دو جانچیں۔ پہلی، سب سے بڑی درخواست ماڈل کی ونڈو میں فٹ ہونی چاہیے۔ 20 باریوں پر سب سے بڑی درخواست 19,700 ٹوکن ہے، کوئی مسئلہ نہیں۔ فی سیٹ 200 باریوں والا کئی گھنٹے کا کھیل 2,000 + 600 × 200 + 300 × 199 = 181,700 تک پہنچتا ہے، تقریباً 182K، اس لیے کھیل ڈیزائن کرنے سے پہلے ماڈل کے صفحے پر کانٹیکسٹ سائز پڑھیں۔ DeepSeek-V4-Flash کی 380K ونڈو اور 32,768 تک آؤٹ پٹ ٹوکن ہیں؛ ماڈل کا صفحہ دیکھیں۔ دوسری، اگر کوئی ماڈل طویل استدلال خارج کرتا ہے تو آپ کے 300 آؤٹ پٹ ٹوکن زیادہ ہو جاتے ہیں (بلک جاب میں سوچنے والے ٹوکن)۔
کوڈ میں سخت حد لگائیں#
README کا --budget فلیگ درست خیال ہے، اور اسے اپنے ہارنس میں نقل کرنے میں دس سطریں لگتی ہیں۔ نیچے دیا گیا اسکرپٹ چلنے سے پہلے اندازہ لگاتا ہے، ایسی درخواست بھیجنے سے انکار کرتا ہے جو کل کو حد سے بڑھا سکے، اور ہر کال کو لیجر فائل میں لاگ کرتا ہے۔ اس میں دی گئی قیمتیں ایک مثال ہیں: موجودہ قیمتیں قیمتوں کے جدول سے بدل لیں۔
import json, os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
PRICE_IN, PRICE_OUT = 0.10, 0.40  # per 1M tokens: example, substitute current
CAP_USD = 5.00
spent = 0.0


def cost(tin, tout):
    return (tin * PRICE_IN + tout * PRICE_OUT) / 1_000_000


def estimate(seats, turns, system=2000, new_in=600, out=300):
    tin = sum(system + new_in * k + out * (k - 1) for k in range(1, turns + 1))
    return seats * tin, seats * turns * out


def ask(seat, history, max_out=400):
    global spent
    rough_in = sum(len(m['content']) for m in history) // 3  # pessimistic
    if spent + cost(rough_in, max_out) > CAP_USD:
        raise SystemExit(f'cap reached: ${spent:.4f} spent')
    r = client.chat.completions.create(
        model=MODEL, messages=history, max_tokens=max_out)
    u = r.usage
    spent += cost(u.prompt_tokens, u.completion_tokens)
    with open('ledger.jsonl', 'a') as f:
        f.write(json.dumps({'seat': seat, 'in': u.prompt_tokens,
                            'out': u.completion_tokens,
                            'spent': round(spent, 6)}) + '\n')
    return r.choices[0].message.content


print(estimate(6, 20))  # (1338000, 36000) per game
estimate(6, 20) (1338000, 36000) پرنٹ کرتا ہے، یعنی وہی فی کھیل اعداد جو اوپر ہیں، تاکہ کوڈ اور حساب ایک دوسرے کی جانچ کریں۔ usage. اور usage. جواب سے آتے ہیں اور یہی وہ چیزیں ہیں جن کا آپ سے بل لیا جاتا ہے؛ پیشگی جانچ ایک محتاط کریکٹر گنتی استعمال کرتی ہے کیونکہ اصل گنتی کال کے بعد ہی معلوم ہوتی ہے۔ فی پروجیکٹ لیجرز کے بارے میں مزید Python میں ایجنٹ ٹوکن لاگت ٹریک کرنا میں۔
پہلی بار چلانے کے لیے محفوظ ترتیب#
ریپو کی اپنی ترتیب ایک اچھا نمونہ ہے: پہلے مفت، پھر سستا، آخر میں مہنگا۔ ان مراحل کو ترتیب دیں:
ترتیب دیں
محفوظ پہلی بار چلانے کے مراحل کو ترتیب دیں
آئٹمز کو گھسیٹیں یا تیروں کا استعمال کریں
- بے ترتیب کھلاڑی کے ساتھ ڈرائی رن، کوئی API کال نہیں
estimate()چلائیں اور اسے اپنی حد سے موازنہ کریں- ایک حقیقی کھیل کھیلیں اور لیجر پڑھیں
- اصل ٹوکن گنتی سے مفروضے درست کریں
- حد آن رکھ کر پورا ٹورنامنٹ شروع کریں
README کہتا ہے کہ سستے ماڈلز پر ڈیمو کھیل تقریباً $2–5 کا آتا ہے۔ یہ مصنف کا بیان ہے اور ماڈلز کے نام نہیں دیے گئے، اس لیے اسے ایک معقول حد سمجھیں، اپنے سیٹ اپ کا کوٹ نہیں۔ آپ کا اپنا پائلٹ کھیل وہ عدد دیتا ہے جو اہم ہے: اگر اس کا لیجر 1,500,000 ان پٹ ٹوکن دکھاتا ہے جہاں آپ نے 1,338,000 فرض کیے تھے، تو آپ نے کھیل 40 پر نہیں بلکہ چند سینٹ میں کچھ سیکھ لیا۔
لمبے تجربات کے لیے، معمول کے اوزار چیٹ تاریخ تراشنا میں ہیں: ہر سیٹ کو جو دوبارہ پڑھنا پڑتا ہے اسے کم کریں، اور مربعی رکن اسی کے ساتھ سکڑ جاتا ہے۔ جب آپ اسے چلانے کے لیے تیار ہوں، دستاویزات میں اینڈ پوائنٹ اور ماڈل آئی ڈیز موجود ہیں۔


