비용 최적화가이드
실행 전에 모델 토너먼트의 API 비용을 추정하세요
좌석당 토큰을 세고 게임 수와 진영 교체를 곱한 뒤 Python에 하드 캡을 설정하세요: 6좌석, 60게임 모델 토너먼트의 계산 예시.
이 페이지의 내용
첫 요청 전에 모델 토너먼트의 청구서를 알 수 있습니다. 한 좌석이 게임 전체에서 보내는 토큰을 세고, 좌석 수와 게임 수를 곱한 뒤, 코드에 하드 캡을 넣으면 됩니다. 사람들이 놓치는 부분은 히스토리입니다. 매 턴마다 지금까지 오간 모든 내용을 다시 보내기 때문에, 입력은 턴 수보다 훨씬 빠르게 늘어납니다.
$20,000라는 헤드라인이 알려주는 것과 알려주지 않는 것#
2026년 11월 5일, 팟캐스터 Dwarkesh Patel은 모델들이 서로 사회적 추리 게임 Blood on the Clocktower를 두고 겨루는 벤치마크 Clocktower Bench를 공개했습니다. 그는 하네스를 만드는 데 API 크레딧 약 $20,000를 썼고, 그 상당 부분이 계획했던 토큰보다 환경 설계를 반복하는 데 들어갔다고 말합니다.
프로젝트의 README(2026년 11월 8일 확인)는 구성을 설명합니다. 11개 모델, 헤드라인 순위를 위한 386게임, 한 모델이 모든 선한 좌석을, 다른 모델이 모든 악한 좌석을 맡고, 플레이어는 10–12명, 게임은 몇 시간씩 이어집니다. 각 딜은 진영을 바꿔 다시 진행되므로 어느 모델도 더 쉬운 역할을 맡지 않습니다. 또한 무료 드라이 런(--model random)을 제공하고, 지출을 games/에 기록하며, 기본값이 $1,000인 --budget 캡을 갖추고 있습니다.
제공하지 않는 것은 게임당 토큰 수입니다. 따라서 그대로 복사할 것은 없고, 추정치는 직접 만들어야 합니다. 이 글의 나머지 부분이 바로 그것을 하며, 가정은 명시해 두었으니 여러분의 것으로 바꿔도 됩니다.
한 좌석: 입력이 계속 늘어나는 이유#
더 작은 게임을 돌린다고 해봅시다. 좌석 6개, 각 좌석은 자체 대화를 가진 모델, 좌석당 20턴입니다. 2,000토큰 시스템 프롬프트(규칙과 해당 좌석의 역할), 매 턴 전에 도착하는 600토큰의 새 테이블 대화, 300토큰의 답변을 가정합니다. API에는 메모리가 없으므로 각 요청은 전체 대화를 다시 담습니다(긴 채팅이 더 비싼 이유).
1턴은 2,000 + 600 = 2,600토큰을 보냅니다. 20턴은 2,000 + 600 × 20 + 300 × 19 = 19,700을 보냅니다. 마지막 숫자를 직접 계산해 보세요:
숫자 맞히기
한 좌석이 20번째 턴에 보내는 입력 토큰은 몇 개인가?
내 추측
040,000
정답 보기
정답: 19,700
19,700: 2,000토큰 시스템 프롬프트, 새 대화 20 × 600, 이전 답변 19개 × 300. 모든 과거 답변과 과거 메시지가 다시 들어갑니다.
한 좌석의 20턴을 모두 더하면: 2,000 × 20 + 600 × 210 + 300 × 190 = 40,000 + 126,000 + 57,000 = 223,000 입력 토큰입니다. 출력은 20 × 300 = 6,000에 불과합니다. 각 메시지를 한 번씩만 세면 2,000 + 20 × 600 = 14,000이 되어 16배나 틀리게 됩니다.
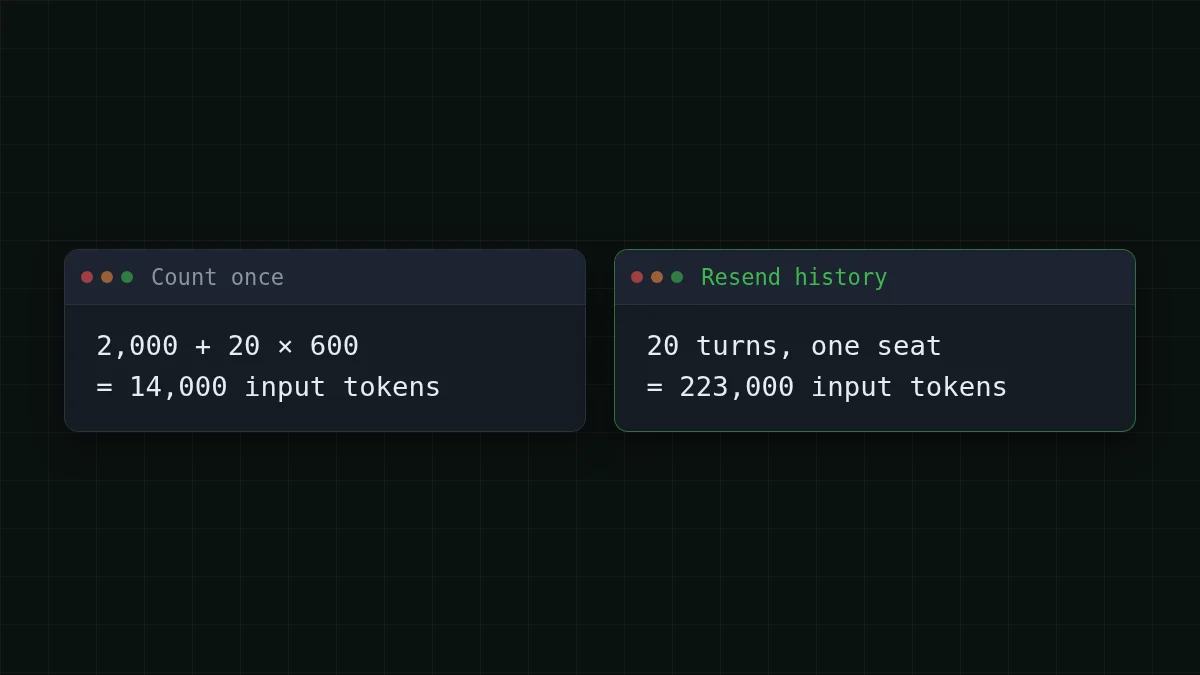
출력 쪽은 거의 변하지 않습니다. 돈은 입력에서 나가고, 게임이 길어질수록 나빠지는 것도 입력 쪽입니다.
한 좌석에서 토너먼트 전체로#
이제 세 가지 승수로 확장합니다.
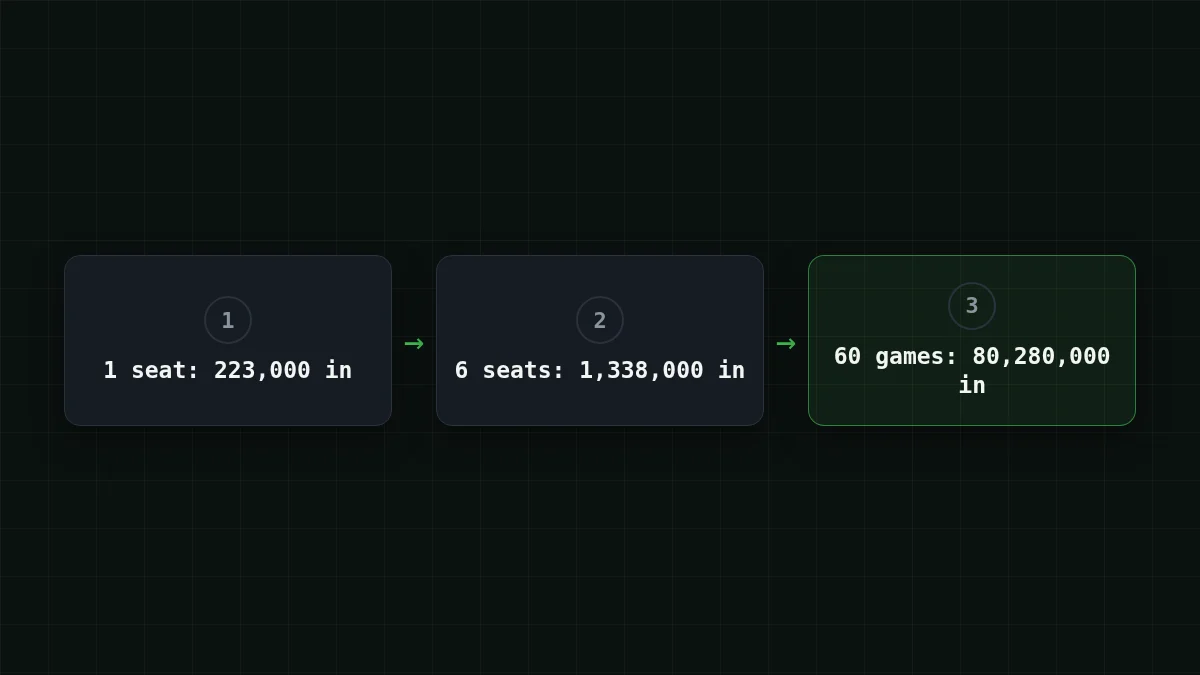
- 좌석. 6좌석 × 223,000 = 1,338,000 입력 토큰, 게임당 6 × 6,000 = 36,000 출력 토큰.
- 진영 교체. 3개 모델의 라운드 로빈: 3개 페어링. 페어링당 10딜, 각 딜을 진영을 바꿔 두 번: 3 × 10 × 2 = 60게임.
- 게임. 토너먼트 전체 60 × 1,338,000 = 80,280,000 입력, 60 × 36,000 = 2,160,000 출력 토큰.
DeepSeek-V4-Flash에서 한 게임은 $0.0237입니다. 아래 표는 그 한 모델이 모든 좌석을 맡는다고 가정해 60게임 토너먼트 전체의 가격을 매긴 것으로, CheapTokens가 이런 장기 대화 작업에 제공하는 세 모델을 비교할 수 있습니다. 입력과 출력을 합친 총액 기준으로, 세 모델 모두 마지막 열의 OpenRouter 참조 가격보다 저렴합니다.
| 모델 | 입력 $/1M | 출력 $/1M | 요청당 | 60회 요청 | OpenRouter, 60회 요청 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0282 | $1.69 | $2.87 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0237 | $1.42 | $5.92 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0723 | $4.34 | $52.06 |
요청당 입력 1,338,000개 및 출력 36,000개 토큰입니다. 100만 토큰당 가격은 현재 기준이며 당사 요금제에 따라 함께 변경됩니다. OpenRouter 열은 동일한 작업량에 대한 참고 가격을 보여줍니다.
예산 측면에서 이게 전부입니다. 세 모델 중 어느 것이 협상 게임을 더 잘하는지 알아내는 데 $20,000짜리 항목이 필요하지는 않습니다. 위의 추정치와, 그것을 검증할 실제 파일럿만 있으면 됩니다.
빠른 확인
좌석당 20턴인 6좌석 게임을 40턴으로 늘리면 입력 청구서는 어떻게 되나?
정답 보기
정답: 약 3.6배 늘어난다
40턴의 경우 같은 공식으로 2,000 × 40 + 600 × 820 + 300 × 780 = 806,000 입력 토큰이 나오며, 20턴의 223,000과 비교됩니다. 히스토리 항은 턴 수의 제곱에 비례해 늘어납니다.
이런 숫자를 믿기 전에 두 가지를 확인하세요. 첫째, 가장 큰 요청이 모델의 윈도우에 들어가야 합니다. 20턴에서 가장 큰 요청은 19,700토큰이라 문제없습니다. 좌석당 200턴인 몇 시간짜리 게임은 2,000 + 600 × 200 + 300 × 199 = 181,700, 약 182K에 이르므로 게임을 설계하기 전에 모델 페이지의 컨텍스트 크기를 읽어 보세요. DeepSeek-V4-Flash는 380K 윈도우와 최대 32,768 출력 토큰을 가집니다. 모델 페이지를 참고하세요. 둘째, 모델이 긴 추론을 내보내면 300 출력 토큰은 더 늘어납니다(대량 작업에서의 사고 토큰).
코드에 하드 캡 넣기#
README의 --budget 플래그는 올바른 발상이며, 여러분의 하네스에 복사하는 데 열 줄이면 됩니다. 아래 스크립트는 실행 전에 추정하고, 총액을 캡 위로 밀어낼 수 있는 요청은 보내기를 거부하며, 모든 호출을 원장 파일에 기록합니다. 스크립트의 가격은 예시이므로 가격표의 현재 가격으로 바꾸세요.
import json, os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
PRICE_IN, PRICE_OUT = 0.10, 0.40  # per 1M tokens: example, substitute current
CAP_USD = 5.00
spent = 0.0


def cost(tin, tout):
    return (tin * PRICE_IN + tout * PRICE_OUT) / 1_000_000


def estimate(seats, turns, system=2000, new_in=600, out=300):
    tin = sum(system + new_in * k + out * (k - 1) for k in range(1, turns + 1))
    return seats * tin, seats * turns * out


def ask(seat, history, max_out=400):
    global spent
    rough_in = sum(len(m['content']) for m in history) // 3  # pessimistic
    if spent + cost(rough_in, max_out) > CAP_USD:
        raise SystemExit(f'cap reached: ${spent:.4f} spent')
    r = client.chat.completions.create(
        model=MODEL, messages=history, max_tokens=max_out)
    u = r.usage
    spent += cost(u.prompt_tokens, u.completion_tokens)
    with open('ledger.jsonl', 'a') as f:
        f.write(json.dumps({'seat': seat, 'in': u.prompt_tokens,
                            'out': u.completion_tokens,
                            'spent': round(spent, 6)}) + '\n')
    return r.choices[0].message.content


print(estimate(6, 20))  # (1338000, 36000) per game
estimate(6, 20)은 위와 같은 게임당 숫자인 (1338000, 36000)를 출력하므로 코드와 산술이 서로를 검증합니다. usage.와 usage.은 응답에서 나오며 실제로 청구되는 값입니다. 사전 검사는 비관적인 문자 수를 쓰는데, 실제 개수는 호출 후에야 알 수 있기 때문입니다. 프로젝트별 원장에 대해서는 Python에서 에이전트 토큰 비용 추적하기를 참고하세요.
첫 실행을 위한 안전한 순서#
저장소 자체의 순서가 좋은 모델입니다. 무료 먼저, 저렴한 것 다음, 비싼 것은 마지막. 다음 단계를 순서대로 배열하세요:
순서대로 배열하기
안전한 첫 실행의 단계를 순서대로 배열하세요
항목을 드래그하거나 화살표를 사용하세요
- 무작위 플레이어로 드라이 런, API 호출 없음
estimate()를 실행하고 캡과 비교- 실제 게임 하나를 플레이하고 원장 읽기
- 실제 토큰 수로 가정 수정
- 캡을 켠 채 전체 토너먼트 시작
README는 저렴한 모델로 데모 게임을 돌리면 약 $2–5가 든다고 합니다. 이는 저자의 진술이고 모델 이름도 밝히지 않으므로, 여러분의 구성에 대한 견적이 아니라 합리성 범위로 받아들이세요. 여러분의 파일럿 게임이 중요한 숫자를 줍니다. 원장에 1,338,000을 가정했는데 1,500,000 입력 토큰이 찍혔다면, 40번째 게임이 아니라 몇 센트로 무언가를 배운 것입니다.
더 긴 실험에서는 채팅 히스토리 줄이기의 일반적인 수단을 씁니다. 각 좌석이 다시 읽어야 하는 양을 줄이면 이차항도 함께 줄어듭니다. 실행할 준비가 되면 문서에 엔드포인트와 모델 id가 있습니다.


