Estime o custo de API de um torneio de modelos antes de rodá-lo
Conte tokens por assento, multiplique por partidas e trocas de lado, e defina um teto rígido em Python: uma estimativa detalhada para um torneio de modelos de 6 assentos e 60 partidas.
Nesta página
Você pode saber a conta de um torneio de modelos antes da primeira requisição: conte os tokens que um assento envia ao longo de uma partida inteira, multiplique por assentos e partidas, e coloque um teto rígido no código. O que as pessoas esquecem é o histórico. A cada turno tudo o que foi dito até então é reenviado, então a entrada cresce muito mais rápido que o número de turnos.
O que uma manchete de $20.000 diz e não diz#
Em 5 de novembro de 2026 o podcaster Dwarkesh Patel publicou o Clocktower Bench, um benchmark em que modelos jogam o jogo de dedução social Blood on the Clocktower uns contra os outros. Ele diz que gastou cerca de $20.000 em créditos de API construindo o harness, e que boa parte foi para iterar no design do ambiente, mais do que os tokens que tinha planejado.
O README do projeto (verificado em 8 de novembro de 2026) descreve a configuração: 11 modelos, 386 partidas para o ranking principal, um modelo ocupando todos os assentos bons e outro todos os assentos maus, 10–12 jogadores, partidas que duram várias horas. Cada distribuição é rejogada com os lados trocados, para que nenhum modelo fique com o papel mais fácil. Ele também traz um dry run gratuito (--model random), grava os gastos em games/ e tem um teto --budget que por padrão é $1.000.
O que ele não dá é tokens por partida. Então não há nada para copiar; você mesmo monta a estimativa. É o que o resto deste artigo faz, com premissas declaradas que você pode trocar pelas suas.
Um assento: por que a entrada não para de crescer#
Digamos que você rode uma partida menor: 6 assentos, cada assento é um modelo com sua própria conversa, 20 turnos por assento. Assuma um system prompt de 2.000 tokens (regras e o papel do assento), 600 novos tokens de conversa de mesa chegando antes de cada turno, e uma resposta de 300 tokens. A API não tem memória, então cada requisição carrega a conversa inteira de novo (por que um chat longo custa mais).
O turno 1 envia 2.000 + 600 = 2.600 tokens. O turno 20 envia 2.000 + 600 × 20 + 300 × 19 = 19.700. Tente o último número você mesmo:
Adivinhar o número
Quantos tokens de entrada um assento envia no seu 20º turno?
O seu palpite
040.000
Mostrar resposta
Resposta: 19.700
19.700: o system prompt de 2.000 tokens, 20 × 600 de conversa nova, e 19 respostas anteriores de 300 cada. Toda resposta antiga e toda mensagem antiga voltam.
Some todos os 20 turnos de um assento: 2.000 × 20 + 600 × 210 + 300 × 190 = 40.000 + 126.000 + 57.000 = 223.000 tokens de entrada. A saída é só 20 × 300 = 6.000. Se você contasse cada mensagem uma vez, teria 2.000 + 20 × 600 = 14.000 e erraria por um fator de dezesseis.
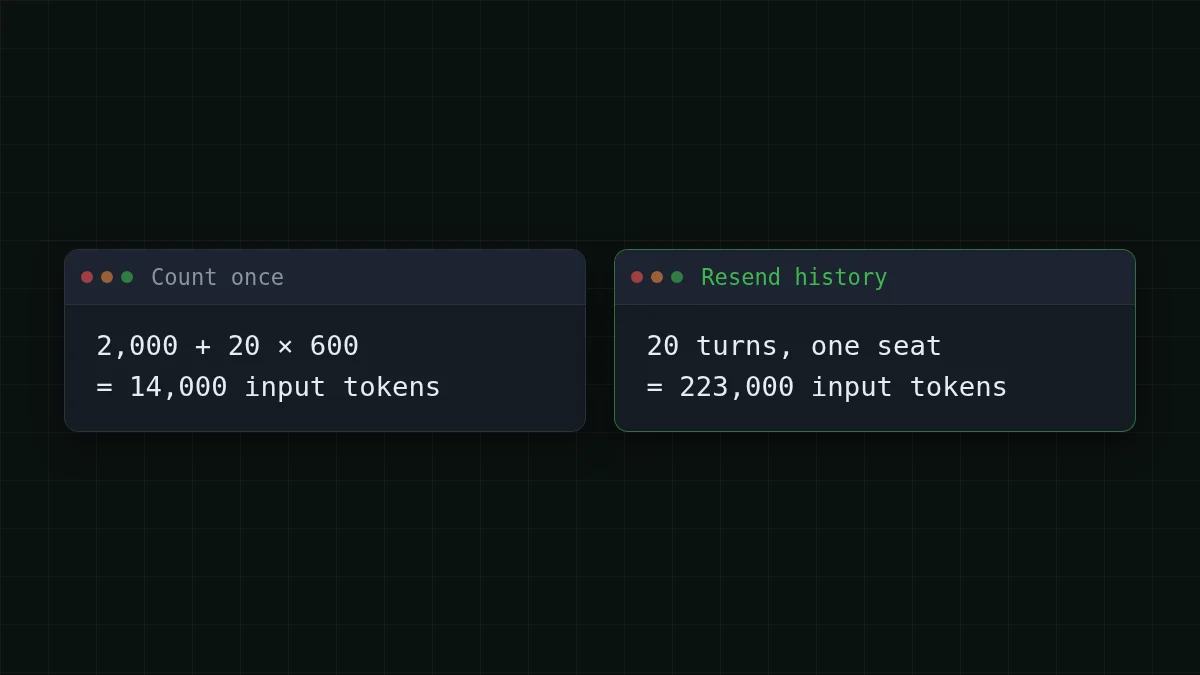
O lado da saída quase não se move. A entrada é onde o dinheiro vai, e é o lado que piora conforme as partidas ficam mais longas.
De um assento para um torneio inteiro#
Agora escale com três multiplicadores.
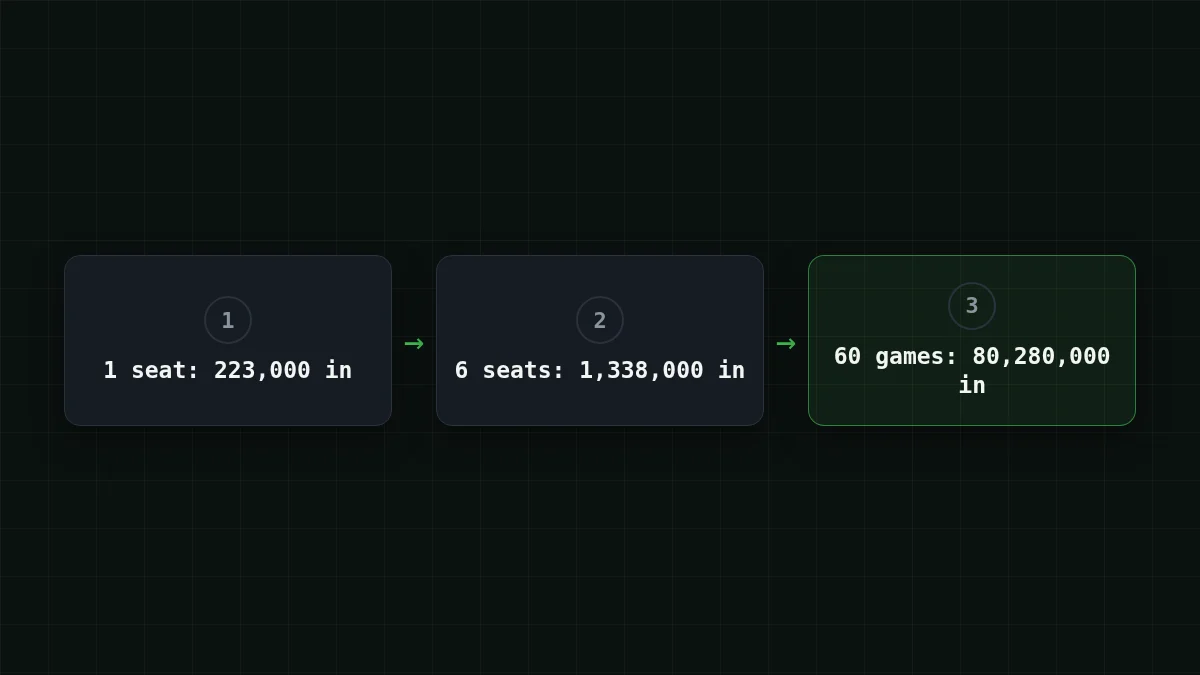
- Assentos. 6 assentos × 223.000 = 1.338.000 tokens de entrada e 6 × 6.000 = 36.000 tokens de saída por partida.
- Troca de lado. Pegue 3 modelos em round robin: 3 confrontos. Jogue 10 distribuições por confronto, cada uma duas vezes com os lados trocados: 3 × 10 × 2 = 60 partidas.
- Partidas. 60 × 1.338.000 = 80.280.000 de entrada e 60 × 36.000 = 2.160.000 tokens de saída para o torneio.
Uma partida no DeepSeek-V4-Flash sai por $0.0237. A tabela abaixo precifica o torneio inteiro de 60 partidas como se aquele único modelo ocupasse todos os assentos, para você comparar os três modelos que a CheapTokens oferece para esse tipo de trabalho de conversa longa. No total, com entrada e saída somadas, cada um deles é mais barato que a referência do OpenRouter na última coluna.
| Modelo | Entrada $/1M | Saída $/1M | Por solicitação | 60 solicitações | OpenRouter, 60 solicitações |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0282 | $1.69 | $2.87 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0237 | $1.42 | $5.92 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0723 | $4.34 | $52.06 |
1.338.000 tokens de entrada e 36.000 tokens de saída por solicitação. Os preços por 1M de tokens são atuais e mudam junto com nossas tarifas; a coluna OpenRouter mostra preços de referência para a mesma carga de trabalho.
Em termos de orçamento, esse é o truque inteiro: você não precisa de uma linha de $20.000 para descobrir qual de três modelos joga melhor um jogo de negociação. Você precisa da estimativa acima, e depois de um piloto real para conferi-la.
Verificação rápida
Sua partida de 6 assentos passa de 20 para 40 turnos por assento. O que acontece com a conta de entrada?
Mostrar resposta
Resposta: Cresce cerca de 3,6 vezes
Para 40 turnos a mesma fórmula dá 2.000 × 40 + 600 × 820 + 300 × 780 = 806.000 tokens de entrada, contra 223.000 para 20 turnos. O termo do histórico cresce com o quadrado do número de turnos.
Duas verificações antes de confiar em qualquer número desses. Primeiro, a maior requisição precisa caber na janela do modelo. Com 20 turnos a maior requisição é 19.700 tokens, sem problema. Uma partida de várias horas com 200 turnos por assento chega a 2.000 + 600 × 200 + 300 × 199 = 181.700, cerca de 182K, então leia o tamanho do contexto na página do modelo antes de desenhar o jogo. O DeepSeek-V4-Flash tem uma janela de 380K e até 32.768 tokens de saída; veja a página do modelo. Segundo, se um modelo emitir raciocínio longo, seus 300 tokens de saída viram mais (tokens de raciocínio em um job em lote).
Coloque um teto rígido no código#
A flag --budget do README é a ideia certa, e leva dez linhas para copiar no seu próprio harness. O script abaixo estima antes de rodar, se recusa a enviar uma requisição que possa empurrar o total para além do teto, e registra cada chamada em um arquivo de ledger. Os preços nele são um exemplo: substitua pelos atuais da tabela de preços.
import json, os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
PRICE_IN, PRICE_OUT = 0.10, 0.40  # per 1M tokens: example, substitute current
CAP_USD = 5.00
spent = 0.0


def cost(tin, tout):
    return (tin * PRICE_IN + tout * PRICE_OUT) / 1_000_000


def estimate(seats, turns, system=2000, new_in=600, out=300):
    tin = sum(system + new_in * k + out * (k - 1) for k in range(1, turns + 1))
    return seats * tin, seats * turns * out


def ask(seat, history, max_out=400):
    global spent
    rough_in = sum(len(m['content']) for m in history) // 3  # pessimistic
    if spent + cost(rough_in, max_out) > CAP_USD:
        raise SystemExit(f'cap reached: ${spent:.4f} spent')
    r = client.chat.completions.create(
        model=MODEL, messages=history, max_tokens=max_out)
    u = r.usage
    spent += cost(u.prompt_tokens, u.completion_tokens)
    with open('ledger.jsonl', 'a') as f:
        f.write(json.dumps({'seat': seat, 'in': u.prompt_tokens,
                            'out': u.completion_tokens,
                            'spent': round(spent, 6)}) + '\n')
    return r.choices[0].message.content


print(estimate(6, 20))  # (1338000, 36000) per game
estimate(6, 20) imprime (1338000, 36000), os mesmos números por partida de acima, então o código e a aritmética se conferem. usage. e usage. vêm da resposta e são o que você paga; a pré-checagem usa uma contagem de caracteres pessimista porque a contagem real só é conhecida depois da chamada. Mais sobre ledgers por projeto em rastreando o custo de tokens de agentes em Python.
Uma ordem segura para a primeira execução#
A sequência do próprio repositório é um bom modelo: grátis primeiro, barato depois, caro por último. Coloque estes passos em ordem:
Colocar em ordem
Coloque os passos de uma primeira execução segura em ordem
Arraste os itens ou use as setas
- Dry run com um jogador aleatório, sem chamadas de API
- Rode
estimate()e compare com seu teto - Jogue uma partida real e leia o ledger
- Corrija as premissas com as contagens reais de tokens
- Lance o torneio completo com o teto ligado
O README diz que uma partida de demonstração em modelos baratos custa cerca de $2–5. Essa é a afirmação do autor e os modelos não são nomeados, então trate como uma faixa de sanidade, não como cotação para o seu setup. Sua própria partida piloto dá o número que importa: se o ledger dela mostrar 1.500.000 tokens de entrada onde você assumiu 1.338.000, você aprendeu algo por alguns centavos em vez de na partida 40.
Para experimentos mais longos, as alavancas de sempre estão em enxugando o histórico do chat: corte o que cada assento precisa reler, e o termo quadrático encolhe junto. Quando estiver pronto para rodar, a documentação tem o endpoint e os ids dos modelos.


