Estimer le coût API d'un tournoi de modèles avant de le lancer
Comptez les tokens par siège, multipliez par les parties et les inversions de camps, et fixez un plafond strict en Python : une estimation détaillée pour un tournoi de modèles à 6 sièges et 60 parties.
Sur cette page
Vous pouvez connaître la facture d'un tournoi de modèles avant la première requête : comptez les tokens qu'un siège envoie sur une partie entière, multipliez par les sièges et les parties, et placez un plafond strict dans le code. Ce que les gens oublient, c'est l'historique. À chaque tour, tout ce qui a été dit jusqu'ici est renvoyé, donc l'entrée croît bien plus vite que le nombre de tours.
Ce qu'un titre à 20 000 $ dit et ne dit pas#
Le 5 novembre 2026, le podcasteur Dwarkesh Patel a publié Clocktower Bench, un benchmark où des modèles jouent au jeu de déduction sociale Blood on the Clocktower les uns contre les autres. Il dit avoir dépensé environ 20 000 $ de crédits API pour construire le harnais, et qu'une bonne partie est passée dans l'itération sur la conception de l'environnement, plus que dans les tokens prévus.
Le README du projet (vérifié le 8 novembre 2026) décrit la configuration : 11 modèles, 386 parties pour le classement principal, un modèle jouant tous les sièges du camp du bien et un autre tous les sièges du camp du mal, 10 à 12 joueurs, des parties qui durent plusieurs heures. Chaque donne est rejouée avec les camps inversés, pour qu'aucun modèle n'obtienne le rôle le plus facile. Le projet fournit aussi un essai à blanc gratuit (--model random), écrit les dépenses dans games/, et possède un plafond --budget fixé par défaut à 1 000 $.
Ce qu'il ne donne pas, c'est le nombre de tokens par partie. Il n'y a donc rien à copier ; vous construisez l'estimation vous-même. C'est ce que fait la suite de cet article, avec des hypothèses explicites que vous pouvez remplacer par les vôtres.
Un siège : pourquoi l'entrée ne cesse de croître#
Supposons une partie plus petite : 6 sièges, chaque siège est un modèle avec sa propre conversation, 20 tours par siège. Prenez un prompt système de 2 000 tokens (règles et rôle du siège), 600 nouveaux tokens de conversation de table arrivant avant chaque tour, et une réponse de 300 tokens. L'API n'a pas de mémoire, donc chaque requête transporte à nouveau toute la conversation (pourquoi un long chat coûte plus cher).
Le tour 1 envoie 2 000 + 600 = 2 600 tokens. Le tour 20 envoie 2 000 + 600 × 20 + 300 × 19 = 19 700. Essayez le dernier nombre vous-même :
Devinez le nombre
Combien de tokens d'entrée un siège envoie-t-il à son 20e tour ?
Votre estimation
040 000
Afficher la réponse
Réponse: 19 700
19 700 : le prompt système de 2 000 tokens, 20 × 600 de nouvelle conversation, et 19 réponses précédentes de 300 chacune. Chaque ancienne réponse et chaque ancien message sont renvoyés.
Additionnez les 20 tours d'un siège : 2 000 × 20 + 600 × 210 + 300 × 190 = 40 000 + 126 000 + 57 000 = 223 000 tokens d'entrée. La sortie ne fait que 20 × 300 = 6 000. Si vous comptiez chaque message une seule fois, vous obtiendriez 2 000 + 20 × 600 = 14 000 et vous vous tromperiez d'un facteur seize.
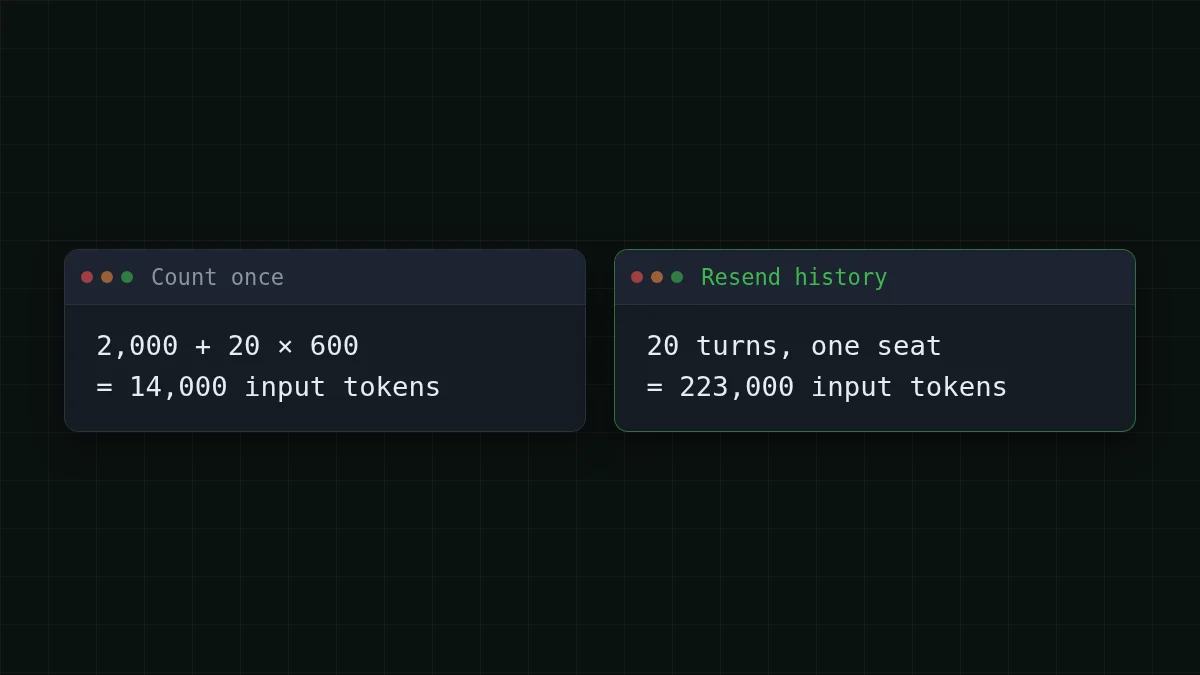
Le côté sortie bouge à peine. C'est l'entrée qui coûte, et c'est le côté qui empire à mesure que les parties s'allongent.
D'un siège à un tournoi entier#
Mettez maintenant à l'échelle avec trois multiplicateurs.
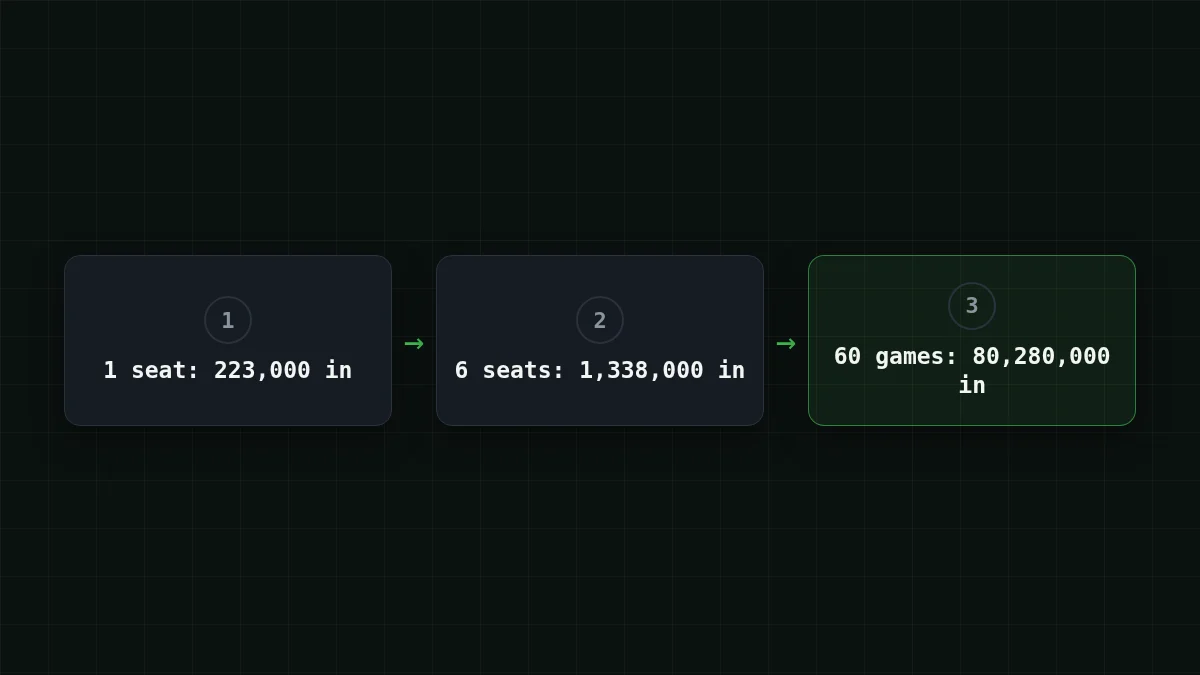
- Sièges. 6 sièges × 223 000 = 1 338 000 tokens d'entrée et 6 × 6 000 = 36 000 tokens de sortie par partie.
- Inversion des camps. Prenez 3 modèles en tournoi toutes rondes : 3 appariements. Jouez 10 donnes par appariement, chacune deux fois avec les camps inversés : 3 × 10 × 2 = 60 parties.
- Parties. 60 × 1 338 000 = 80 280 000 en entrée et 60 × 36 000 = 2 160 000 tokens de sortie pour le tournoi.
Une partie sur DeepSeek-V4-Flash revient à $0.0237. Le tableau ci-dessous chiffre le tournoi complet de 60 parties comme si ce seul modèle jouait tous les sièges, pour que vous puissiez comparer les trois modèles que CheapTokens propose pour ce genre de tâche à longue conversation. Au total, entrée et sortie comprises, chacun d'eux est moins cher que la référence OpenRouter de la dernière colonne.
| Modèle | Entrée $/1M | Sortie $/1M | Par requête | 60 requêtes | OpenRouter, 60 requêtes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0282 | $1.69 | $2.87 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0237 | $1.42 | $5.92 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0723 | $4.34 | $52.06 |
1 338 000 tokens d'entrée et 36 000 tokens de sortie par requête. Les prix par million de tokens sont actuels et évoluent avec nos tarifs ; la colonne OpenRouter indique des prix de référence pour la même charge de travail.
Côté budget, c'est toute l'astuce : vous n'avez pas besoin d'une ligne de 20 000 $ pour savoir lequel de trois modèles joue mieux à un jeu de négociation. Il vous faut l'estimation ci-dessus, puis un vrai pilote pour la vérifier.
Vérification rapide
Votre partie à 6 sièges passe de 20 à 40 tours par siège. Qu'arrive-t-il à la facture d'entrée ?
Afficher la réponse
Réponse: Elle est multipliée par environ 3,6
Pour 40 tours, la même formule donne 2 000 × 40 + 600 × 820 + 300 × 780 = 806 000 tokens d'entrée, contre 223 000 pour 20 tours. Le terme d'historique croît avec le carré du nombre de tours.
Deux vérifications avant de faire confiance à un tel chiffre. D'abord, la plus grosse requête doit tenir dans la fenêtre du modèle. À 20 tours, la plus grosse requête fait 19 700 tokens, aucun problème. Une partie de plusieurs heures avec 200 tours par siège atteint 2 000 + 600 × 200 + 300 × 199 = 181 700, soit environ 182K, donc lisez la taille de contexte sur la page du modèle avant de concevoir la partie. DeepSeek-V4-Flash a une fenêtre de 380K et jusqu'à 32 768 tokens de sortie ; voir la page du modèle. Ensuite, si un modèle émet un long raisonnement, vos 300 tokens de sortie augmentent (tokens de réflexion dans une tâche en lot).
Placez un plafond strict dans le code#
L'option --budget du README est la bonne idée, et il faut dix lignes pour la copier dans votre propre harnais. Le script ci-dessous estime avant d'exécuter, refuse d'envoyer une requête qui pourrait faire dépasser le plafond au total, et journalise chaque appel dans un fichier de registre. Les prix qu'il contient sont un exemple : remplacez-les par les prix actuels du tableau des tarifs.
import json, os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
PRICE_IN, PRICE_OUT = 0.10, 0.40  # per 1M tokens: example, substitute current
CAP_USD = 5.00
spent = 0.0


def cost(tin, tout):
    return (tin * PRICE_IN + tout * PRICE_OUT) / 1_000_000


def estimate(seats, turns, system=2000, new_in=600, out=300):
    tin = sum(system + new_in * k + out * (k - 1) for k in range(1, turns + 1))
    return seats * tin, seats * turns * out


def ask(seat, history, max_out=400):
    global spent
    rough_in = sum(len(m['content']) for m in history) // 3  # pessimistic
    if spent + cost(rough_in, max_out) > CAP_USD:
        raise SystemExit(f'cap reached: ${spent:.4f} spent')
    r = client.chat.completions.create(
        model=MODEL, messages=history, max_tokens=max_out)
    u = r.usage
    spent += cost(u.prompt_tokens, u.completion_tokens)
    with open('ledger.jsonl', 'a') as f:
        f.write(json.dumps({'seat': seat, 'in': u.prompt_tokens,
                            'out': u.completion_tokens,
                            'spent': round(spent, 6)}) + '\n')
    return r.choices[0].message.content


print(estimate(6, 20))  # (1338000, 36000) per game
estimate(6, 20) affiche (1338000, 36000), les mêmes chiffres par partie que ci-dessus, pour que le code et l'arithmétique se vérifient mutuellement. usage. et usage. proviennent de la réponse et correspondent à ce qui vous est facturé ; la pré-vérification utilise un comptage de caractères pessimiste car le compte réel n'est connu qu'après l'appel. Plus de détails sur les registres par projet dans suivre le coût en tokens d'un agent en Python.
Un ordre sûr pour le premier lancement#
La séquence du dépôt est un bon modèle : gratuit d'abord, bon marché ensuite, cher en dernier. Mettez ces étapes dans l'ordre :
Remettre en ordre
Mettez dans l'ordre les étapes d'un premier lancement sûr
Faites glisser les éléments ou utilisez les flèches
- Essai à blanc avec un joueur aléatoire, sans appels API
- Exécuter
estimate()et le comparer à votre plafond - Jouer une vraie partie et lire le registre
- Corriger les hypothèses avec les vrais comptes de tokens
- Lancer le tournoi complet avec le plafond activé
Le README indique qu'une partie de démonstration sur des modèles bon marché coûte environ 2 à 5 $. C'est une déclaration de l'auteur et les modèles ne sont pas nommés, donc traitez-la comme un ordre de grandeur, pas comme un devis pour votre configuration. Votre propre partie pilote donne le chiffre qui compte : si son registre affiche 1 500 000 tokens d'entrée là où vous supposiez 1 338 000, vous l'avez appris pour quelques centimes au lieu de la partie 40.
Pour des expériences plus longues, les leviers habituels sont dans réduire l'historique de chat : coupez ce que chaque siège doit relire, et le terme quadratique diminue d'autant. Quand vous êtes prêt à lancer, la documentation contient l'endpoint et les identifiants de modèles.


