IA pour débutantsGuide
Plafonner le coût d'un lot LLM en Python : un registre et un budget strict
Journalisez les tokens et le coût de chaque appel API dans un fichier JSONL, arrêtez le lot à un budget et estimez la facture avant de l'exécuter. Code Python inclus.
Sur cette page
Votre script boucle sur 200 prompts, vous fermez le capot de l'ordinateur portable, et au matin vous découvrez ce que la nuit a coûté. Deux petites habitudes règlent cela. Après chaque appel API, ajoutez une ligne avec les tokens et le coût dans un fichier de registre. Avant chaque appel, comparez le total cumulé avec un budget et arrêtez s'il est atteint. Cela fait moins de 50 lignes de Python, et une exécution d'essai sur 5 prompts vous donne la facture avant que l'exécution réelle ne commence.
Ce que fait l'exécution Clocktower que vous pouvez copier#
Dwarkesh Patel, animateur du Dwarkesh Podcast, a fait s'affronter 11 modèles dans Blood on the Clocktower, 386 parties selon le README, et a publié le code, les logs et les classements (github.com/dwarkeshsp/clocktower, consulté le 8 novembre 2026). Deux détails du dépôt valent la peine d'être repris. Chaque répertoire de partie conserve un log par appel avec les tokens et le coût, et les dépenses vont dans games/. Un flag --budget plafonne la dépense totale ; la valeur par défaut est de 1 000 $. Le site du benchmark ajoute une troisième garde : chaque modèle dispose du même plafond de 8 000 tokens par tour (clocktowerbench.com).
Donc : un plafond sur chaque appel, un log de chaque appel, un plafond sur le total. Un tournoi a besoin des trois, et votre exécution nocturne aussi, en plus petit.
Considérez le registre comme le rouleau de tickets d'une caisse de magasin. Chaque vente imprime une ligne ; le gérant peut additionner le rouleau à tout moment et sait quand la caisse du jour est épuisée.
Le registre : un fichier, une ligne par appel#
Voici l'ensemble. Il utilise le paquet openai pointé vers CheapTokens (https:/, voir la documentation pour la clé et les identifiants de modèles).
import json
import os
from pathlib import Path

from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
PRICE_IN, PRICE_OUT = 1.00, 2.00  # USD per 1M tokens: example, substitute current ones


class BudgetExceeded(Exception):
    pass


class Ledger:
    def __init__(self, path, budget_usd):
        self.path = Path(path)
        self.budget = budget_usd
        self.rows = []
        if self.path.exists():
            with self.path.open() as f:
                self.rows = [json.loads(line) for line in f if line.strip()]

    @property
    def spent(self):
        return sum(r['cost_usd'] for r in self.rows)

    def done(self):
        return {r['unit'] for r in self.rows}

    def check(self, unit):
        if self.spent >= self.budget:
            raise BudgetExceeded(
                f'stopped before {unit}: spent {self.spent:.4f} of {self.budget} USD'
            )

    def add(self, unit, usage, finish_reason):
        cost = (usage.prompt_tokens * PRICE_IN
                + usage.completion_tokens * PRICE_OUT) / 1_000_000
        row = {
            'unit': unit,
            'model': MODEL,
            'prompt_tokens': usage.prompt_tokens,
            'completion_tokens': usage.completion_tokens,
            'finish_reason': finish_reason,
            'cost_usd': round(cost, 6),
        }
        self.rows.append(row)
        with self.path.open('a') as f:
            f.write(json.dumps(row) + '\n')


def ask(ledger, unit, prompt, max_tokens=400):
    ledger.check(unit)
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[{'role': 'user', 'content': prompt}],
        max_tokens=max_tokens,
    )
    ledger.add(unit, resp.usage, resp.choices[0].finish_reason)
    return resp.choices[0].message.content
Chaque appel passe par les mêmes quatre étapes :
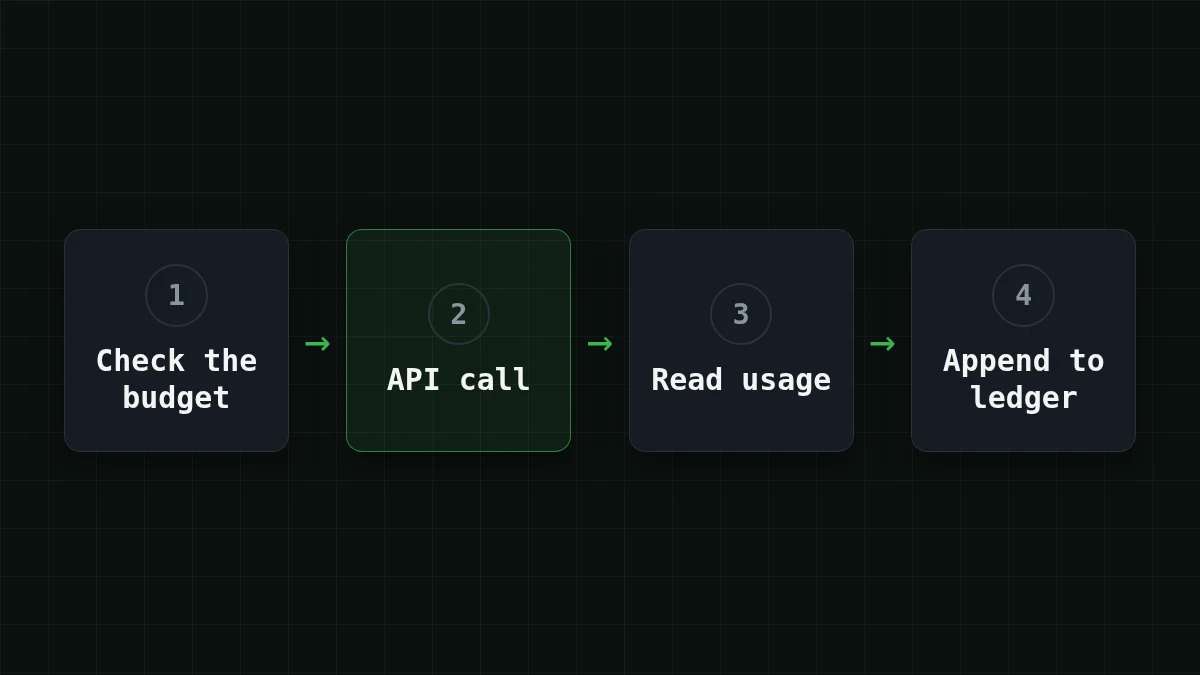
Trois choix y sont délibérés.
- Un objet JSON par ligne (JSONL), ouvert en mode ajout. Si le script plante à l'appel 130, les appels 1 à 129 sont déjà sur le disque.
- Le total vient du fichier, pas d'une variable. Redémarrez le script et le plafond tient toujours, car le registre se souvient de ce que l'exécution précédente a dépensé.
finish_reasonest journalisé à côté des tokens. Une ligne qui indiquelengthsignifie que la réponse a atteint votremax_tokenset a été tronquée. Vous voudrez le savoir plus tard.
Les deux constantes PRICE_ sont des espaces réservés. Prenez les chiffres actuels dans la table de tarifs. Pour DeepSeek-V4-Flash au moment où vous lisez ceci, c'est $0.015 par 1M de tokens d'entrée et $0.10 par 1M de tokens de sortie. Remplacez MODEL par zai- ou MiniMaxAI/ et les deux constantes, et le même registre fonctionne pour eux.
La boucle par lots : ignorer ce qui est fait, s'arrêter au plafond#
La boucle est courte. Disons que vos prompts se trouvent dans un dict indexé par un identifiant d'unité, le nom d'une pièce de travail, comme doc-001 :
prompts = {
    'doc-001': 'Summarize this ticket in one sentence: ...',
    'doc-002': 'Summarize this ticket in one sentence: ...',
    # ... your 200 prompts
}

ledger = Ledger('ledger.jsonl', budget_usd=0.50)
already = ledger.done()

for unit, prompt in prompts.items():
    if unit in already:
        continue
    try:
        answer = ask(ledger, unit, prompt)
    except BudgetExceeded as e:
        print(e)
        break
    Path(f'out-{unit}.txt').write_text(answer)
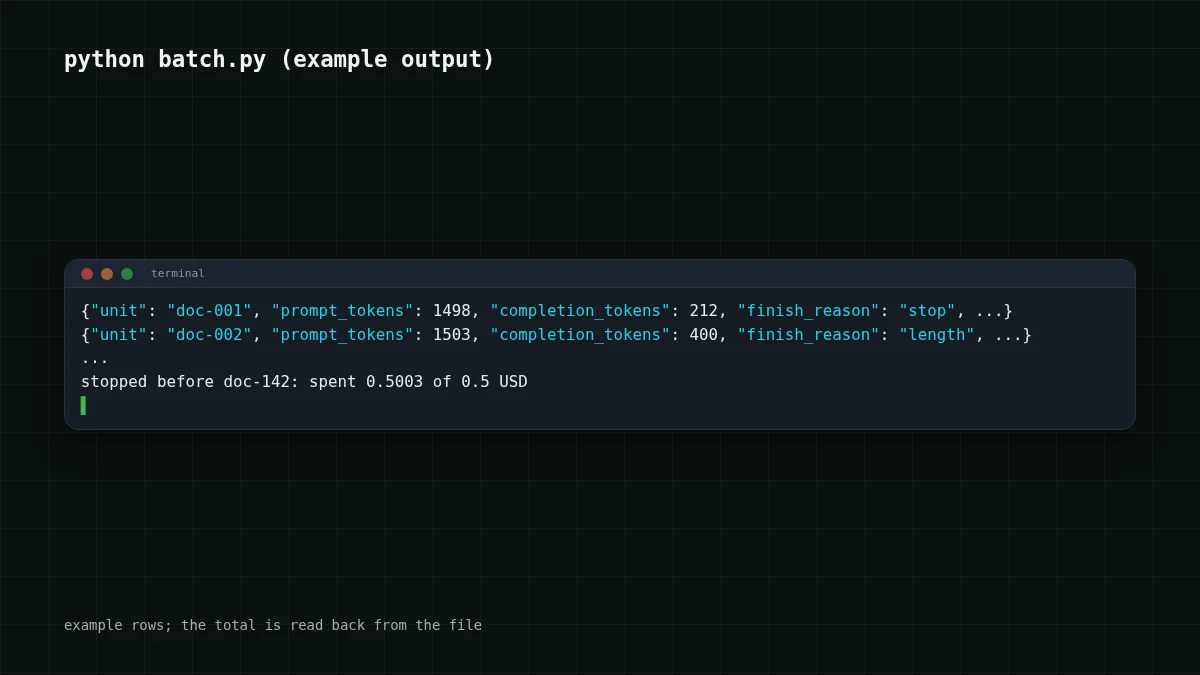
Lancez-le, faites Ctrl+C à mi-chemin, relancez-le : les unités terminées sont ignorées, donc le registre sert aussi de fichier de progression. Laissez le budget s'épuiser et vous obtenez une ligne au lieu d'une surprise, quelque chose comme stopped before doc-.
Remarquez le mot avant. La vérification a lieu avant chaque appel, donc le dernier appel peut faire dépasser légèrement le budget. Le dépassement est borné : un appel ne peut pas coûter plus que votre prompt le plus long plus max_tokens. Pour un prompt de 1 500 tokens et max_tokens=400, c'est au plus $0.000063. C'est pourquoi chaque appel du wrapper a un max_tokens : il transforme un risque ouvert en un nombre autour duquel vous pouvez planifier.
Estimer la facture avant d'appuyer sur exécuter#
Maintenant l'autre moitié : connaître le coût avant le lancement. Faites passer les cinq premiers prompts par ask() avec un petit budget et lisez le registre. Disons que les cinq lignes font en moyenne 1 500 tokens d'entrée et 400 tokens de sortie. Ce sont vos chiffres pour tout le lot.
Pour 200 prompts, cela fait 200 × 1 500 = 300 000 tokens d'entrée et 200 × 400 = 80 000 tokens de sortie. Voici cette charge de travail aux tarifs actuels :
| Modèle | Entrée $/1M | Sortie $/1M | Par requête | 200 requêtes | OpenRouter, 200 requêtes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000046 | $0.0092 | $0.0167 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000063 | $0.0125 | $0.0322 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00014 | $0.027 | $0.324 |
1 500 tokens d'entrée et 400 tokens de sortie par requête. Les prix par million de tokens sont actuels et évoluent avec nos tarifs ; la colonne OpenRouter indique des prix de référence pour la même charge de travail.
Le tableau a aussi une colonne OpenRouter. En comptant l'entrée et la sortie ensemble, DeepSeek-V4-Flash revient moins cher qu'OpenRouter pour cette charge, et c'est cette somme que le lot paie réellement.
Les prompts diffèrent en longueur, donc cinq échantillons sont une estimation, pas une promesse. Utilisez le plus long des cinq quand vous voulez une borne supérieure sûre, puis laissez le plafond de budget rattraper le reste. Vous voulez comparer deux modèles sur les mêmes 200 prompts ? Donnez à chaque modèle son propre fichier de registre, par exemple Ledger(f'ledger-, et les deux totaux se retrouvent côte à côte ensuite.
Essayez votre propre lot ici : définissez les tokens par requête à partir de votre échantillon et le nombre de requêtes que vous prévoyez.
Calculateur de coût
Votre lot : tokens issus de votre échantillon de 5 prompts
Tokens d'entrée par requête: 1 500 · Tokens de sortie par requête: 400 · Requêtes par jour: 200
| Modèle | Par jour | Par mois |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0092 | $0.276 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0125 | $0.375 |
| MiniMax-M2.7$0.05$0.15 | $0.027 | $0.81 |
Pour en savoir plus sur le comptage des tokens avant l'envoi, voir compter les tokens avec tiktoken.
Quand la facture est plus grosse que prévu : lire le registre#
Le troisième scénario de lecture est le plus désagréable. Une exécution d'agent tourne mal et boucle, et le tableau de bord n'affiche qu'un total. Le registre montre où cela s'est passé. Triez les lignes par coût :
rows = [json.loads(line) for line in open('ledger.jsonl')]
for r in sorted(rows, key=lambda r: r['cost_usd'], reverse=True)[:5]:
    print(r['unit'], r['prompt_tokens'], r['completion_tokens'], r['finish_reason'])
Pour un agent, nommez l'unité d'après l'étape (step-17) afin de voir la forme de l'exécution. Quelques motifs reviennent sans cesse ; associez chacun à sa cause habituelle :
Associer les paires
Associez chaque motif de registre à sa cause habituelle
Touchez un élément à gauche, puis sa paire
- prompt_tokens augmente un peu à chaque ligneLa boucle renvoie tout l'historique à chaque étape
- completion_tokens égale max_tokens et finish_reason vaut lengthLes réponses sont tronquées à votre plafond, et vous payez le texte tronqué
- La même unité apparaît plusieurs fois de suiteUne boucle de nouvelle tentative, ou un agent qui répète une étape
- Une ligne coûte bien plus que toutes les autresUne entrée surdimensionnée, comme un fichier entier collé dans le prompt
Chaque motif est visible dans le registre bien avant la facture. Le premier est traité dans pourquoi un agent relit son historique.
Si vous voulez aussi des dépenses par projet et des alertes hors du script, ce guide sur les alertes de budget par projet couvre cet aspect. Le registre ici est la partie qui vit dans votre code et peut dire stop.
Avant de lancer#
Liste de contrôle
Avant la première exécution réelle
La taille de contexte et la limite de réponse de DeepSeek-V4-Flash, utiles quand vous choisissez max_tokens, sont sur sa page : DeepSeek-V4-Flash sur CheapTokens.


