AI dla początkującychPrzewodnik
Ogranicz koszt partii LLM w Pythonie: księga i twardy budżet
Loguj tokeny i koszt każdego wywołania API do pliku JSONL, zatrzymaj partię na budżecie i oszacuj rachunek, zanim ją uruchomisz. Kod Pythona w zestawie.
Na tej stronie
Twój skrypt przechodzi przez 200 promptów, zamykasz klapę laptopa, a rano odkrywasz, ile kosztowała noc. Dwa małe nawyki to naprawiają. Po każdym wywołaniu API dopisz jedną linię z tokenami i kosztem do pliku księgi. Przed każdym wywołaniem porównaj sumę bieżącą z budżetem i zatrzymaj się, jeśli został osiągnięty. To mniej niż 50 linii Pythona, a próbny przebieg na 5 promptach powie ci, jaki będzie rachunek, zanim zacznie się prawdziwy przebieg.
Co robi przebieg Clocktower, co możesz skopiować#
Dwarkesh Patel, gospodarz Dwarkesh Podcast, skonfrontował 11 modeli ze sobą w Blood on the Clocktower, 386 gier według README, i opublikował kod, logi i oceny (github.com/dwarkeshsp/clocktower, sprawdzone 8 listopada 2026). Dwa szczegóły z repo warto podkraść. Każdy katalog gry trzyma log per wywołanie z tokenami i kosztem, a wydatki trafiają do games/. Flaga --budget ogranicza całkowity wydatek; domyślnie to 1000 dolarów. Strona benchmarku dodaje trzecią zaporę: każdy model dostaje ten sam limit 8000 tokenów na turę (clocktowerbench.com).
Czyli: limit na każde wywołanie, log każdego wywołania, limit na sumę. Turniej potrzebuje wszystkich trzech, a twój nocny przebieg też, tylko mniejszy.
Pomyśl o księdze jak o rolce paragonów w kasie sklepu. Każda sprzedaż drukuje linię; menedżer może w każdej chwili zsumować rolkę i wie, kiedy skończy się dzisiejsza kasa.
Księga: jeden plik, jedna linia na wywołanie#
Oto całość. Używa pakietu openai skierowanego na CheapTokens (https:/, klucz i identyfikatory modeli znajdziesz w dokumentacji).
import json
import os
from pathlib import Path

from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
PRICE_IN, PRICE_OUT = 1.00, 2.00  # USD per 1M tokens: example, substitute current ones


class BudgetExceeded(Exception):
    pass


class Ledger:
    def __init__(self, path, budget_usd):
        self.path = Path(path)
        self.budget = budget_usd
        self.rows = []
        if self.path.exists():
            with self.path.open() as f:
                self.rows = [json.loads(line) for line in f if line.strip()]

    @property
    def spent(self):
        return sum(r['cost_usd'] for r in self.rows)

    def done(self):
        return {r['unit'] for r in self.rows}

    def check(self, unit):
        if self.spent >= self.budget:
            raise BudgetExceeded(
                f'stopped before {unit}: spent {self.spent:.4f} of {self.budget} USD'
            )

    def add(self, unit, usage, finish_reason):
        cost = (usage.prompt_tokens * PRICE_IN
                + usage.completion_tokens * PRICE_OUT) / 1_000_000
        row = {
            'unit': unit,
            'model': MODEL,
            'prompt_tokens': usage.prompt_tokens,
            'completion_tokens': usage.completion_tokens,
            'finish_reason': finish_reason,
            'cost_usd': round(cost, 6),
        }
        self.rows.append(row)
        with self.path.open('a') as f:
            f.write(json.dumps(row) + '\n')


def ask(ledger, unit, prompt, max_tokens=400):
    ledger.check(unit)
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[{'role': 'user', 'content': prompt}],
        max_tokens=max_tokens,
    )
    ledger.add(unit, resp.usage, resp.choices[0].finish_reason)
    return resp.choices[0].message.content
Każde wywołanie przechodzi przez te same cztery kroki:
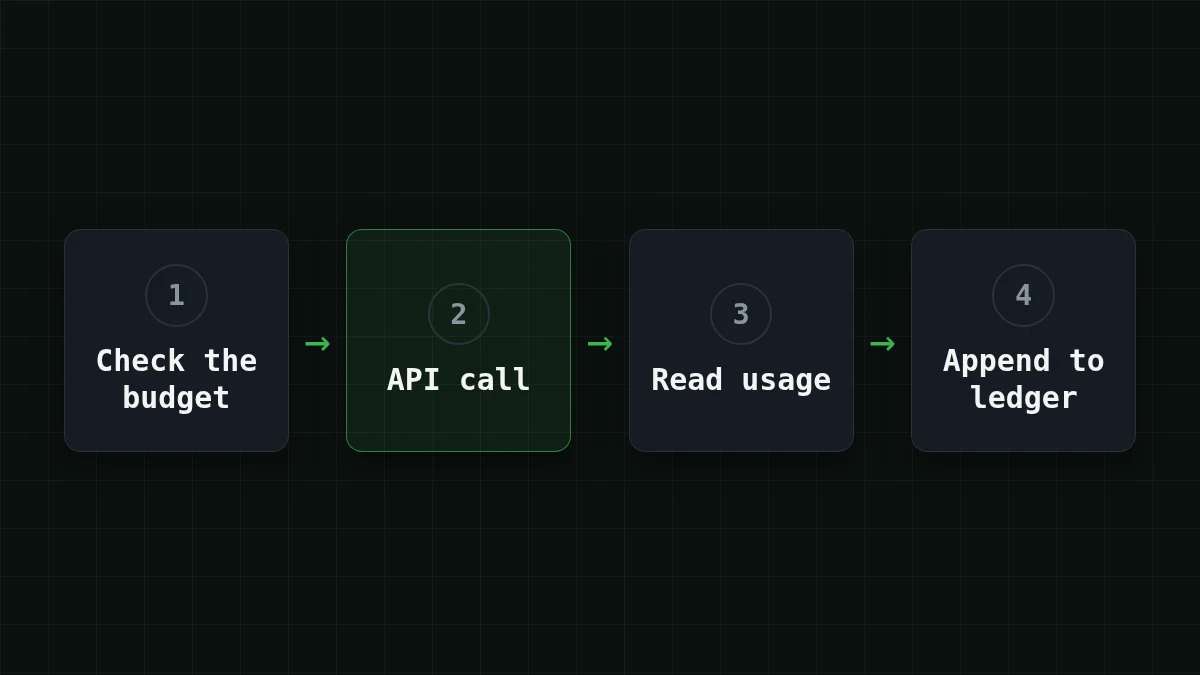
Trzy wybory są tam celowe.
- Jeden obiekt JSON na linię (JSONL), otwierany w trybie dopisywania. Jeśli skrypt padnie przy wywołaniu 130, wywołania od 1 do 129 są już na dysku.
- Suma pochodzi z pliku, nie ze zmiennej. Zrestartuj skrypt, a limit nadal obowiązuje, bo księga pamięta, ile wydał poprzedni przebieg.
finish_reasonjest logowany obok tokenów. Wiersz zlengthoznacza, że odpowiedź trafiła w twójmax_tokensi została ucięta. Będziesz chciał to wiedzieć później.
Dwie stałe PRICE_ to placeholdery. Weź aktualne liczby z tabeli cen. Dla DeepSeek-V4-Flash w chwili, gdy to czytasz, to $0.015 za 1M tokenów wejściowych i $0.10 za 1M tokenów wyjściowych. Zmień MODEL na zai- lub MiniMaxAI/ oraz te dwie stałe, a ta sama księga zadziała dla nich.
Pętla wsadowa: pomiń zrobione, zatrzymaj się na limicie#
Pętla jest krótka. Powiedzmy, że twoje prompty siedzą w słowniku kluczowanym po identyfikatorze jednostki, nazwie jednego kawałka pracy, na przykład doc-001:
prompts = {
    'doc-001': 'Summarize this ticket in one sentence: ...',
    'doc-002': 'Summarize this ticket in one sentence: ...',
    # ... your 200 prompts
}

ledger = Ledger('ledger.jsonl', budget_usd=0.50)
already = ledger.done()

for unit, prompt in prompts.items():
    if unit in already:
        continue
    try:
        answer = ask(ledger, unit, prompt)
    except BudgetExceeded as e:
        print(e)
        break
    Path(f'out-{unit}.txt').write_text(answer)
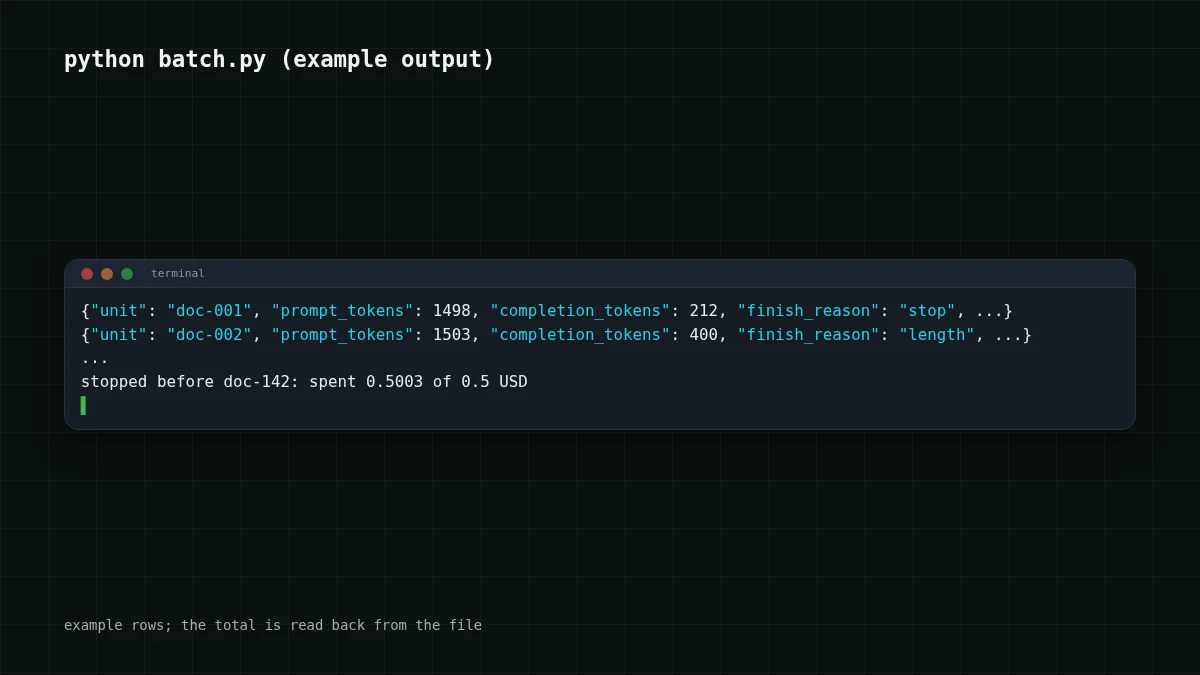
Uruchom, wciśnij Ctrl+C w połowie, uruchom ponownie: ukończone jednostki są pomijane, więc księga służy też jako plik postępu. Pozwól budżetowi się wyczerpać, a dostaniesz jedną linię zamiast niespodzianki, coś w rodzaju stopped before doc-.
Zwróć uwagę na słowo przed. Sprawdzenie następuje przed każdym wywołaniem, więc ostatnie wywołanie może wypchnąć sumę nieco ponad budżet. O ile ponad, jest ograniczone: jedno wywołanie nie może kosztować więcej niż twój najdłuższy prompt plus max_tokens. Dla promptu 1500 tokenów i max_tokens=400 to najwyżej $0.000063. Dlatego każde wywołanie w wrapperze ma max_tokens: zamienia otwarte ryzyko w liczbę, wokół której można planować.
Oszacuj rachunek, zanim wciśniesz uruchom#
Teraz druga połowa: znać koszt przed startem. Przepuść pierwsze pięć promptów przez ask() z małym budżetem i odczytaj księgę. Powiedzmy, że pięć wierszy daje średnio 1500 tokenów wejściowych i 400 wyjściowych. To twoje liczby dla całej partii.
Dla 200 promptów to 200 × 1500 = 300 000 tokenów wejściowych i 200 × 400 = 80 000 tokenów wyjściowych. Oto to obciążenie na aktualnych cenach:
| Model | Wejście $/1M | Wyjście $/1M | Za żądanie | 200 żądań | OpenRouter, 200 żądań |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000046 | $0.0092 | $0.0167 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000063 | $0.0125 | $0.0322 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00014 | $0.027 | $0.324 |
1500 tokenów wejściowych i 400 tokenów wyjściowych na żądanie. Ceny za 1 mln tokenów są aktualne i zmieniają się wraz z naszymi taryfami; kolumna OpenRouter pokazuje ceny referencyjne dla tego samego obciążenia.
Tabela ma też kolumnę OpenRouter. Licząc wejście i wyjście razem, DeepSeek-V4-Flash wychodzi taniej niż OpenRouter dla tego obciążenia, a ta suma to naprawdę to, co płaci partia.
Prompty różnią się długością, więc pięć próbek to zgadywanie, nie obietnica. Użyj najdłuższego z pięciu, gdy chcesz bezpiecznej górnej granicy, a resztę złapie limit budżetu. Chcesz porównać dwa modele na tych samych 200 promptach? Daj każdemu modelowi własny plik księgi, na przykład Ledger(f'ledger-, a dwie sumy staną obok siebie później.
Wypróbuj własną partię tutaj: ustaw tokeny na żądanie z twojej próbki i ile żądań planujesz.
Kalkulator kosztów
Twoja partia: tokeny z twojej próbki 5 promptów
Tokeny wejściowe na żądanie: 1500 · Tokeny wyjściowe na żądanie: 400 · Żądania dziennie: 200
| Model | Dziennie | Miesięcznie |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0092 | $0.276 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0125 | $0.375 |
| MiniMax-M2.7$0.05$0.15 | $0.027 | $0.81 |
Więcej o liczeniu tokenów przed wysłaniem znajdziesz w liczeniu tokenów z tiktoken.
Gdy rachunek jest większy niż oczekiwano: czytaj księgę#
Trzeci scenariusz czytelnika jest paskudny. Przebieg agenta idzie źle i zapętla się, a dashboard pokazuje tylko sumę. Księga pokazuje, gdzie poszło. Posortuj wiersze po koszcie:
rows = [json.loads(line) for line in open('ledger.jsonl')]
for r in sorted(rows, key=lambda r: r['cost_usd'], reverse=True)[:5]:
    print(r['unit'], r['prompt_tokens'], r['completion_tokens'], r['finish_reason'])
Dla agenta nazwij jednostkę po kroku (step-17), żebyś widział kształt przebiegu. Kilka wzorców pojawia się raz za razem; dopasuj każdy do jego zwykłej przyczyny:
Dopasuj pary
Dopasuj każdy wzorzec księgi do jego zwykłej przyczyny
Dotknij element po lewej, a następnie jego parę
- prompt_tokens rośnie trochę w każdym wierszuPętla odsyła całą historię przy każdym kroku
- completion_tokens równa się max_tokens, a finish_reason to lengthOdpowiedzi są ucinane na twoim limicie, a płacisz za ucięty tekst
- Ta sama jednostka pojawia się wiele razy z rzęduPętla ponowień albo agent powtarzający jeden krok
- Jeden wiersz kosztuje znacznie więcej niż wszystkie inneJeden za duży input, na przykład cały plik wklejony do promptu
Każdy wzorzec jest widoczny w księdze długo przed fakturą. Pierwszy jest omówiony w dlaczego agent ponownie czyta swoją historię.
Jeśli chcesz też wydatków per projekt i alertów poza skryptem, ten przewodnik po alertach budżetowych per projekt omawia tę stronę. Księga tutaj to część, która żyje w twoim kodzie i potrafi powiedzieć stop.
Zanim uruchomisz#
Lista kontrolna
Przed pierwszym prawdziwym przebiegiem
Rozmiar kontekstu i limit odpowiedzi DeepSeek-V4-Flash, przydatne przy wyborze max_tokens, są na jego stronie: DeepSeek-V4-Flash na CheapTokens.


